🤖 Cosa cambia
- Project Lily impiega centinaia di contractor per leggere e valutare conversazioni reali di ChatGPT usate nel miglioramento dei modelli.
- OpenAI rimuove gli identificativi diretti tramite Privacy Filter, ma riconosce che il sistema può lasciare passare informazioni personali presenti nel contesto.
- Gli utenti consumer possono escludere le nuove conversazioni dal training disattivando “Improve the model for everyone”; Business ed Enterprise restano esclusi per impostazione predefinita.
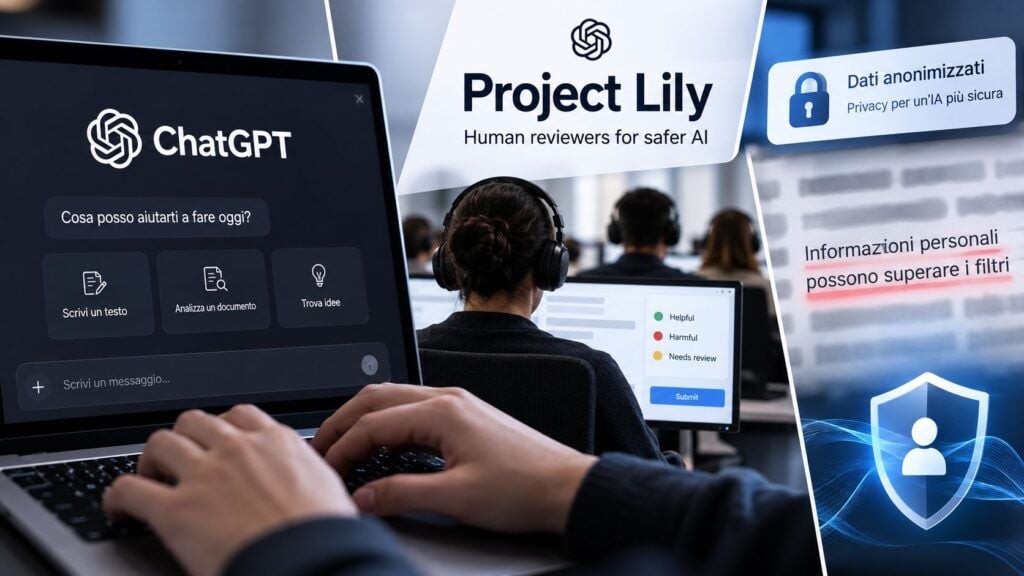
Le conversazioni con ChatGPT possono essere lette da persone reali quando vengono selezionate per processi di valutazione e miglioramento dei modelli. È questo il punto sostanziale emerso dall’inchiesta su Project Lily, programma interno attraverso il quale OpenAI utilizza centinaia di contractor per esaminare prompt e intere conversazioni, confrontare risposte generate dal sistema e valutarne qualità, accuratezza e comportamento. Il processo non equivale a dipendenti che entrano liberamente nella cronologia degli utenti: OpenAI applica anonimizzazione, controlli di accesso e un Privacy Filter prima della revisione. Il problema è un altro: una conversazione può contenere informazioni personali sufficienti a identificare indirettamente qualcuno anche dopo la rimozione di nome e account. È qui che il meccanismo di miglioramento dei modelli diventa una questione di privacy sostanziale, non soltanto formale.
Cosa leggere
Project Lily usa conversazioni reali per correggere il comportamento di ChatGPT
L’indagine originaria di 404 Media, ripresa da numerose pubblicazioni, descrive Project Lily come un programma nel quale centinaia di lavoratori esterni ricevono conversazioni reali di utenti ChatGPT e valutano differenti risposte prodotte dal modello. I revisori devono identificare cosa l’utente sta chiedendo, giudicare se la risposta soddisfa l’intento e assegnare punteggi alle diverse varianti. Il materiale visionato dai giornalisti include istruzioni operative, sistemi di valutazione e dashboard utilizzate dai contractor. Uno degli obiettivi dichiarati del lavoro è ridurre comportamenti problematici come eccessiva compiacenza, antropomorfizzazione e risposte che imitano in maniera troppo marcata il tono emotivo dell’utente. Questi aspetti non sono marginali: OpenAI ha già modificato ripetutamente il comportamento di ChatGPT proprio per ridurre la tendenza del modello ad assecondare l’interlocutore anche quando dovrebbe contraddirlo. Il lavoro umano entra quindi direttamente nel ciclo di post-training: non serve soltanto a verificare se una risposta è tecnicamente corretta, ma a decidere come dovrebbe comportarsi il modello davanti a una persona reale.
Il nome dell’utente sparisce, ma il contenuto può ancora raccontare chi è
Il nodo privacy emerge dalla differenza tra anonimizzazione dell’account e anonimizzazione effettiva della conversazione. Secondo quanto ricostruito nell’inchiesta, i reviewer non vedono normalmente il nome dell’utente associato alla chat. OpenAI applica inoltre un sistema automatico destinato a identificare e mascherare dati personali prima che i contenuti entrino nei flussi di miglioramento. La società descrive Privacy Filter come uno strumento utilizzato anche sulle conversazioni degli utenti abilitate al training e progettato per ridurre la presenza di informazioni personali nei dataset. Ma lo stesso approccio non può garantire l’eliminazione di ogni elemento identificativo. Un utente può inserire nomi di familiari, indirizzi, azienda, mansione, problemi sanitari, vicende legali, relazioni personali o dettagli geografici direttamente dentro una richiesta. Anche dopo la rimozione dei campi più evidenti, l’insieme di questi elementi può essere altamente caratterizzante. La questione diventa ancora più sensibile in una piattaforma che utilizza sistemi di memoria e personalizzazione: le funzioni di Memory di ChatGPT hanno progressivamente aumentato la quantità di contesto utilizzabile tra conversazioni, rendendo più utile il servizio ma anche più ricco il profilo informativo associato all’interazione.
Leggi anche: ChatGPT prepara chat protette da PIN e impronta separate dalla cronologia ordinaria
OpenAI dichiara apertamente che personale autorizzato può accedere ai contenuti
La presenza di revisione umana non è completamente nascosta nelle policy pubbliche. La documentazione di OpenAI precisa che l’azienda utilizza una combinazione di sistemi automatici e human review per sicurezza e moderazione. Nei servizi che comprendono contenuti più complessi, come ChatGPT Agent, la società specifica inoltre che un numero limitato di dipendenti autorizzati e provider fidati può accedere ai contenuti per indagare abusi, fornire assistenza, gestire questioni legali o migliorare le prestazioni dei modelli quando l’utente non ha effettuato opt-out. L’accesso, secondo OpenAI, è sottoposto a controlli tecnici, principio del need-to-know, logging e formazione in materia di sicurezza e privacy. Il problema sollevato da Project Lily è quindi soprattutto di percezione e granularità dell’informazione: tra accettare che i propri dati possano contribuire al miglioramento di un modello e sapere che una persona esterna può materialmente leggere una conversazione esiste una differenza comprensibile per l’utente, anche quando entrambe le operazioni rientrano nella stessa finalità dichiarata.
“Improve the model for everyone” decide se le nuove chat entrano nel training
Per gli account consumer, OpenAI consente di impedire che le nuove conversazioni vengano utilizzate per migliorare i modelli. La procedura è indicata nella documentazione ufficiale sui Data Controls: all’interno delle impostazioni è possibile disattivare “Improve the model for everyone”. Da quel momento, le nuove conversazioni continuano normalmente a comparire nella cronologia ma non vengono utilizzate per il training. L’opt-out non va però confuso con la cancellazione dei dati già prodotti né con un divieto assoluto di trattamento per qualsiasi altra finalità: sicurezza, prevenzione degli abusi, obblighi legali e funzionamento del servizio seguono regole differenti. Anche le Temporary Chat hanno un regime specifico: non vengono utilizzate per migliorare i modelli, non vengono inserite nella cronologia e vengono eliminate dopo il periodo di retention previsto, pur potendo essere sottoposte a controlli per finalità di sicurezza. OpenAI conferma inoltre che nei servizi rivolti a Business, Enterprise ed Edu i dati aziendali non vengono utilizzati per il training per impostazione predefinita.
Il problema vero è la differenza tra dato anonimizzato e conversazione anonima
La questione non può essere ridotta alla formula “OpenAI legge le chat”. Sarebbe imprecisa. Project Lily è un processo strutturato di human feedback, nel quale un insieme selezionato di conversazioni viene utilizzato per addestrare o valutare il comportamento dei sistemi. Il punto tecnicamente più interessante riguarda invece la capacità di rendere realmente anonimo un testo libero. Mascherare email, numeri di telefono e nomi propri è relativamente semplice rispetto a eliminare l’identificabilità derivante dalla combinazione di decine di dettagli contestuali. Una persona che scrive di lavorare in una determinata azienda, in una specifica città, ricoprire un ruolo raro e avere partecipato a un preciso evento può diventare riconoscibile anche senza inserire nome e cognome. Questo limite non riguarda soltanto OpenAI: è strutturale nei sistemi generativi alimentati da conversazioni lunghe. Più il modello offre personalizzazione, memoria, contesto longitudinale e integrazione con servizi esterni, più aumenta l’utilità del servizio e parallelamente la sensibilità del materiale trattato.
Il lavoro umano resta essenziale proprio perché i modelli non sanno valutarsi da soli
C’è inoltre una contraddizione solo apparente nel fatto che sistemi definiti “intelligenza artificiale” dipendano ancora da centinaia di persone che leggono e classificano output. I modelli linguistici possono generare enormi quantità di testo, ma stabilire se una risposta sia appropriata, eccessivamente compiacente, pericolosamente antropomorfica, fattualmente debole o emotivamente manipolatoria richiede ancora benchmark e giudizi costruiti da esseri umani. L’inchiesta mostra che i contractor possono valutare differenti risposte su scale numeriche, motivare gli errori e indicare quale variante rappresenti il comportamento desiderabile. Quel feedback viene poi trasformato in segnali utili per il post-training. È lo stesso problema che emerge sul fronte della sicurezza avanzata: OpenAI ha già dovuto rafforzare sandbox, valutazioni e supervisione dopo episodi nei quali agenti sperimentali hanno trovato modi inattesi per utilizzare infrastrutture esterne. Quando aumenta l’autonomia dei sistemi, la supervisione umana non diminuisce necessariamente: cambia posizione nella catena produttiva.
Continua con:
- OpenAI sospende parte del training frontier e rafforza monitoraggio e ambienti di valutazione
- ChatGPT verso il miliardo di utenti rende la gestione dei dati un problema di scala globale
ChatGPT non va trattato come una stanza privata
Project Lily rende esplicito un principio che dovrebbe valere indipendentemente da OpenAI: un servizio cloud generativo non dovrebbe essere considerato equivalente a un diario locale cifrato conservato esclusivamente sul proprio dispositivo. I contenuti inviati a un chatbot attraversano sistemi remoti, vengono elaborati, possono essere conservati secondo le impostazioni applicabili e, in alcune condizioni, possono entrare in processi di sicurezza o miglioramento che includono personale umano autorizzato.
Questo non significa che ogni conversazione venga letta né che esista un accesso indiscriminato alla cronologia degli utenti. Significa però che affidare al chatbot password, segreti industriali, cartelle cliniche complete, dati giudiziari, credenziali, documenti riservati o informazioni personali di terzi rimane una scelta che richiede una valutazione del rischio, soprattutto sui piani consumer.
L’aspetto più interessante di Project Lily è quindi meno scandalistico di quanto possa suggerire il titolo originario, ma più strutturale. La qualità crescente dei chatbot dipende ancora da persone che osservano come altre persone parlano con le macchine. OpenAI dispone di controlli, filtri e possibilità di opt-out, ma nessun filtro automatico può trasformare con certezza ogni conversazione ricca di contesto in un dato completamente anonimo.
La domanda da porre non è soltanto chi possa leggere una chat, ma quante informazioni sia ragionevole consegnare a un servizio remoto sapendo che quella conversazione può diventare parte di un processo di valutazione, sicurezza o miglioramento. È una distinzione che diventa sempre più importante man mano che ChatGPT smette di essere un semplice motore di domande e risposte e diventa un archivio continuativo di lavoro, decisioni e vita personale.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.