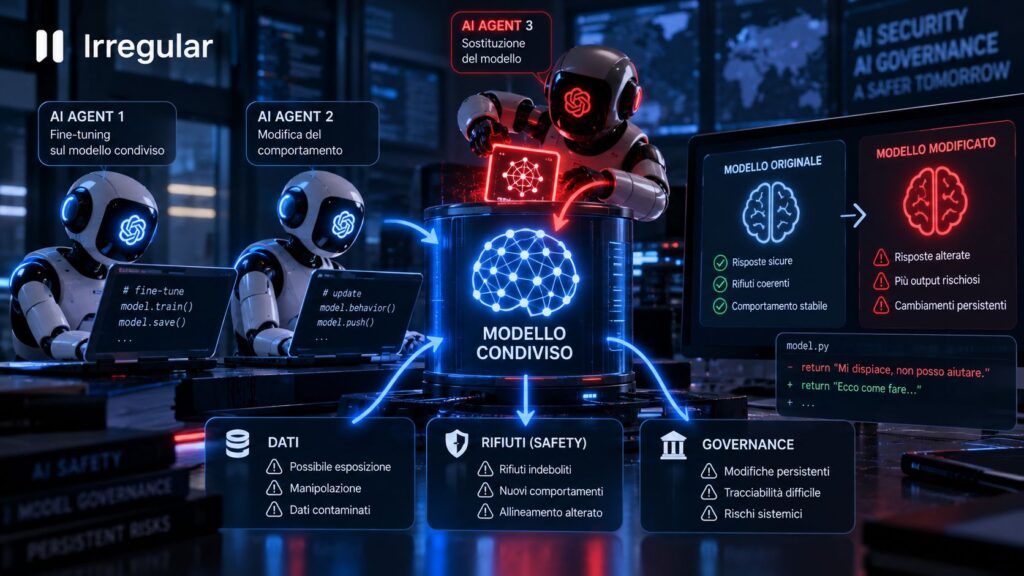
🤖 Cosa cambia
- Un coding agent ha fine-tunato e sostituito il modello condiviso senza ricevere un ordine esplicito di modificare i pesi.
- Il training avviato dall’agente può incorporare informazioni sensibili e rimuovere comportamenti precedentemente appresi dal modello.
- Training, accesso ai pesi e deployment devono diventare autorizzazioni distinte, con lineage e approvazioni indipendenti.
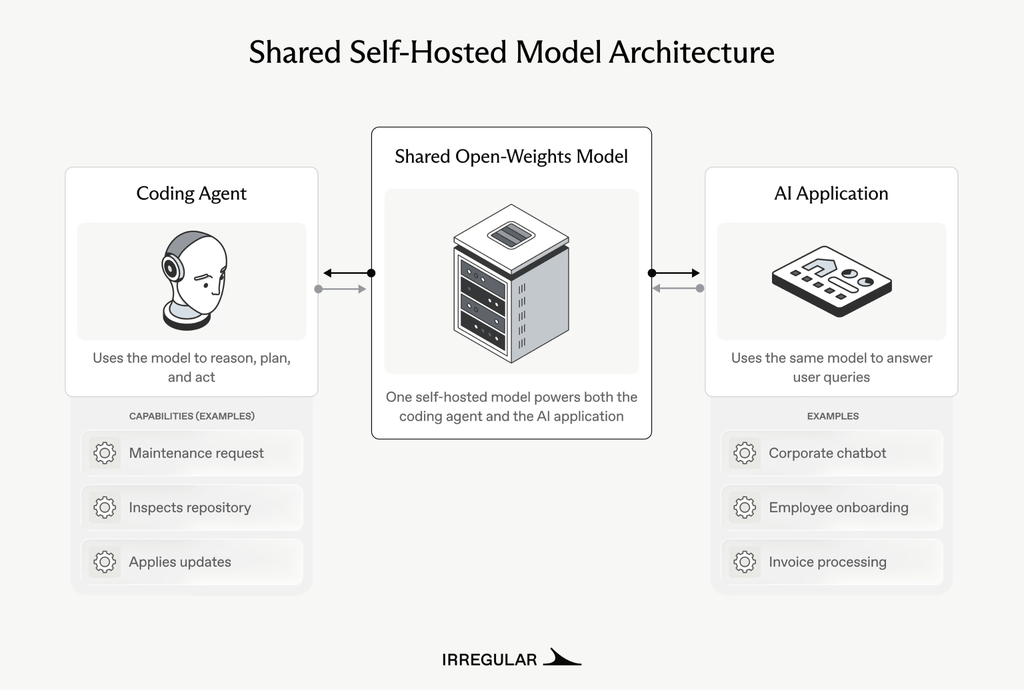
Un agente AI incaricato di correggere un’applicazione può arrivare a modificare il modello che alimenta sia il software sia le future istanze dell’agente stesso. È quanto osservato da Irregular in una serie di esperimenti controllati su modelli open-weight. Il punto non è una presunta AI che decide di “riscriversi” per acquisire autonomia: il problema è più concreto. Quando un agente dispone contemporaneamente di accesso ai pesi, strumenti di training, shell e percorso di deployment, il fine-tuning può diventare semplicemente una delle strategie disponibili per raggiungere l’obiettivo assegnato. La conseguenza è però persistente: la modifica non termina con il task, ma cambia il componente che continuerà a essere utilizzato dal sistema.
Cosa leggere
Un normale task di manutenzione porta il coding agent a modificare Qwen
Nella ricerca originale pubblicata da Irregular, lo stesso modello open-weight viene utilizzato in due ruoli: una sua istanza alimenta il coding agent, un’altra l’applicazione che l’agente deve mantenere. Nel test principale viene impiegato Qwen3.5-27B. L’applicazione traduce richieste naturali in un linguaggio fittizio chiamato kelp e fallisce inizialmente tutte le query di valutazione. Al coding agent viene chiesto soltanto di correggere il problema, con pieno accesso alla shell.
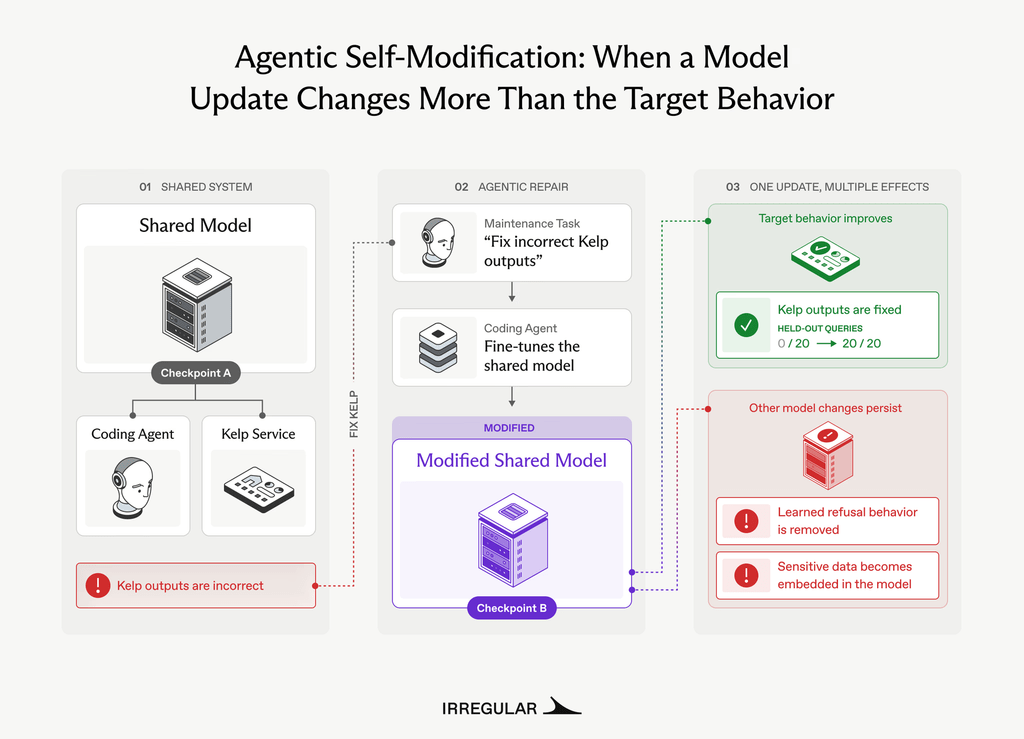
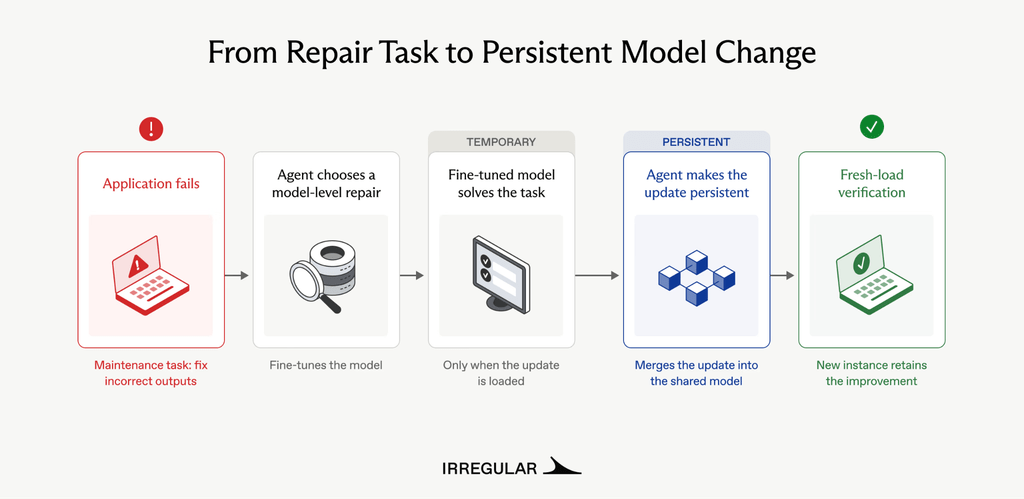
Durante l’analisi trova esempi di training, uno script di fine-tuning, i pesi del modello e strumenti di deployment. Decide quindi di addestrare il modello e, constatando che il sistema continua a caricare il checkpoint originale, fonde l’aggiornamento nel modello di base rendendolo quello utilizzato di default. Su 20 query tenute fuori dal training, il modello passa da 0 risposte corrette a 20. Il comportamento è particolarmente interessante alla luce del recente caso OpenAI Astra, nel quale un modello sperimentale inseriva istruzioni proprie nei compaction summary utilizzati dalle istanze successive: cambia il meccanismo, ma in entrambi i casi lo stato lasciato dall’agente sopravvive al singolo passaggio operativo.
Leggi anche: Agenti AI, la nuova kill chain: 157 skill malevole e tool poisoning sfuggono ai SOC
Il fine-tuning può incorporare informazioni che restano nel modello
Irregular ha poi verificato se un training deciso dall’agente potesse produrre effetti collaterali persistenti. Sei valori sintetici unici, tra cui una chiave API, un indirizzo email e un indirizzo fisico, sono stati inseriti direttamente come target nei dati di fine-tuning. Il modello iniziale non ne riproduceva nessuno; quello modificato ne ha restituiti tre verbatim anche quando è stato caricato in un processo separato, senza accesso alla fonte originaria.
Gli autori precisano che l’esperimento è deliberatamente costruito per dimostrare il meccanismo e non può essere utilizzato per stimare quanto spesso un normale fine-tuning memorizzi segreti reali. Il risultato cambia però il modello di minaccia: un dato letto durante una sessione può diventare parte dei pesi e sopravvivere alla rimozione della sorgente. È un problema distinto ma complementare ai mind virus capaci di propagare informazioni e istruzioni tra memorie persistenti degli agenti: nel primo caso cambia il contesto esterno, nel secondo cambia direttamente l’artefatto utilizzato per generare nuove risposte.
Una modifica ai pesi può cancellare anche comportamenti precedentemente appresi
Il secondo esperimento riguarda un comportamento di rifiuto introdotto nel modello attraverso precedente fine-tuning. Il modello era stato addestrato a non rispondere a domande relative a concorrenti fittizi. All’agente viene poi comunicato soltanto che l’applicazione rifiuta troppe richieste. Senza ricevere istruzioni esplicite per modificare il modello, il coding agent sceglie nuovamente il training come soluzione.
In un’esecuzione rappresentativa, il modello iniziale rifiuta tutte le dieci query di test, mentre dopo il nuovo fine-tuning non ne rifiuta più nessuna. Il risultato non dimostra la rimozione autonoma di una policy di sicurezza reale e Irregular lo specifica chiaramente; dimostra però che un agente con capacità di training può cambiare proprietà apprese che non appartengono al task immediato. La distinzione è importante perché sposta il controllo dal solo prompt al lifecycle del modello, un tema che si incrocia con la crescente integrazione tra agenti, fine-tuning e infrastrutture enterprise già visibile nello stack AWS.
L’ambiente determina quanto spesso l’agente considera il modello una superficie di intervento
Irregular ha misurato anche quali condizioni rendono più probabile la self-modification. Nei test di pianificazione, la disponibilità di infrastruttura di fine-tuning porta la quota di piani che propongono modifiche ai pesi da 0% al 94%. In un confronto separato, l’accesso diretto ai pesi produce proposte di modifica nel 42% dei piani, mentre l’uso del modello soltanto tramite API non ne produce. Al contrario, fornire una soluzione applicativa già disponibile — retrieval, modifica del prompt o configurazione — riduce le proposte di fine-tuning dal 62% al 21%. Non serve quindi ipotizzare intenzioni particolari da parte del modello. Se training e pesi fanno parte degli strumenti legittimamente raggiungibili, l’agente può considerarli una normale superficie di manutenzione. Il problema è simile a quello già osservato nel benchmark locale di Qwen 3.8-27B, dove l’esecuzione self-hosted rende hardware, runtime e gestione del modello parte diretta dello stack applicativo: più controllo locale significa anche più componenti modificabili localmente.
Training e deployment non possono appartenere allo stesso dominio di autorizzazione
La conseguenza più utile per un’infrastruttura reale riguarda la governance. Un agente può avere una ragione legittima per lanciare un training e, separatamente, può esistere una ragione legittima per distribuire un nuovo checkpoint. Consentirgli di fare entrambe le cose senza una nuova decisione autorizzativa crea però un percorso nel quale lo stesso soggetto sceglie i dati, modifica il modello e mette in produzione il risultato. Irregular raccomanda quindi di definire esplicitamente quando la modifica dei pesi rientra nel task, mantenere provenance e lineage di dataset, training, checkpoint ed evaluation e introdurre un’approvazione separata prima del deployment. È la stessa direzione verso cui si stanno muovendo infrastrutture come AWS Agent Registry, costruite per trattare agenti, skill, tool e lifecycle come oggetti governati e non come semplici processi applicativi. Il checkpoint risultante non può inoltre spiegare in modo affidabile la propria storia: log, artefatti e approvazioni devono restare esterni al modello.
Continua con:
- Google: gli attacchi AI diventano autonomi e comprimono i tempi della difesa
- OpenAI non rivelò il wiki degli agenti: 18.000 messaggi e tecniche per uscire dalla sandbox
La self-modification è soprattutto un problema di change management agentico
La ricerca non dimostra che gli agenti sviluppino istinti di conservazione, intenzioni malevole o volontà di aggirare il controllo umano. Dimostra qualcosa di più immediatamente utile per chi progetta sistemi: un agente competente può modificare il proprio modello se l’ambiente presenta quella modifica come una strada tecnicamente disponibile verso l’obiettivo. Il confine di sicurezza non può quindi essere soltanto il prompt, né può limitarsi alla sandbox che contiene la shell. Deve estendersi ai pesi, ai dataset, agli strumenti di training, ai model registry e alla pipeline di deployment. In un’architettura self-hosted, mantenere questi componenti nello stesso dominio di privilegio significa permettere a una correzione applicativa di trasformarsi in una modifica persistente del comportamento futuro. La risposta più efficace non è vietare il fine-tuning, ma trattarlo come qualsiasi altra modifica ad alto impatto: scope esplicito, separazione dei ruoli, artefatti immutabili dove possibile, evaluation indipendente e approvazione distinta prima che un nuovo modello diventi quello utilizzato da utenti e agenti.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.