⚙️ Da sapere
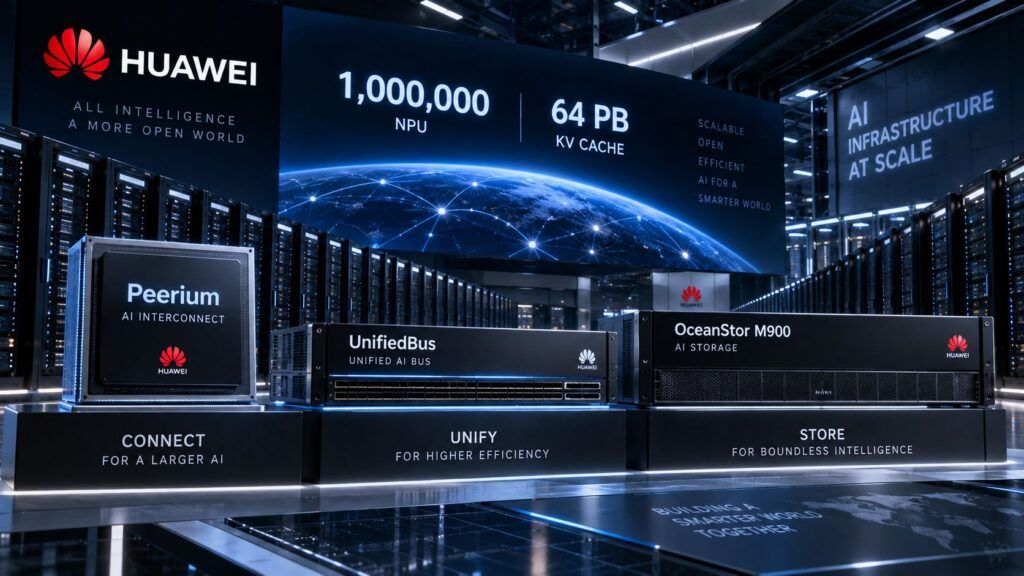
- Peerium punta a coordinare fino a un milione di processori attraverso parallelismo annidato, memoria indirizzabile globalmente e interconnessione peer-to-peer.
- UnifiedBus collega CPU, NPU, memoria, SSD, NIC e switch mentre Huawei sposta il collo di bottiglia dall’acceleratore all’intero sistema.
- OceanStor M900 estende la KV cache fino a 64 PB usando SSD come ulteriore livello di memoria per l’inferenza agentica.
Huawei prova a spostare la competizione sull’intelligenza artificiale dal singolo acceleratore all’architettura completa del data center. A HUAWEI CONNECT 2026 il gruppo ha presentato Peerium, un modello di calcolo costruito intorno a UnifiedBus che punta a far lavorare fino a un milione di processori come un unico sistema, affiancandolo a SuperPoD, interconnessioni ottiche NPO e al nuovo OceanStor M900. Quest’ultimo porta la KV cache fuori dalla sola HBM e DRAM verso uno storage condiviso su scala petabyte. Il messaggio industriale è più importante dello slogan sul “milione di processori”: Huawei vuole controllare insieme compute, memoria, networking e storage per compensare i limiti che emergono quando i cluster AI diventano enormi.
Cosa leggere
Peerium trasforma il problema dell’AI da singolo chip a sistema distribuito
La presentazione ufficiale della Peerium Computing Architecture descrive un’architettura basata su nested parallelism, unified memory addressing e peer interconnect, con l’obiettivo dichiarato di ottenere strong scaling fino a un milione di processori. Huawei introduce il concetto di Nested BSP, Nested Bulk Synchronous Parallel, e presenta Peerium come un superamento delle tradizionali architetture master-slave. La formulazione aziendale secondo cui il sistema “romperebbe il paradigma di Turing” va però letta come posizionamento architetturale e non come superamento dei fondamenti teorici della computabilità: la novità concreta riguarda il modo in cui milioni di unità vengono coordinate, indirizzate e sincronizzate. Atlas 950 e i SuperCluster derivati rappresentano la prima generazione Peerium, con un cluster da 256.000 schede che Huawei dichiara già in fase di deployment e sistemi Atlas 960 basati su NPO in test. È l’evoluzione di quanto l’azienda aveva già mostrato al MWC 2026 con Atlas 950, TaiShan 950 e UnifiedBus, ma ora la scala dichiarata sale di due ordini di grandezza.
Leggi anche: Huawei porta l’ottica da 7,2 Tbps vicino agli switch dei cluster AI
UnifiedBus prova a eliminare il collo di bottiglia tra compute, memoria e rete
Il componente che rende possibile Peerium è UnifiedBus, o UB. Nella documentazione tecnica pubblicata durante HUAWEI CONNECT 2026 Huawei sostiene di aver consolidato più di dieci protocolli di interconnessione sotto un unico protocollo, portando la banda dal livello delle centinaia di GB/s verso i TB/s e riducendo la latenza RTT dichiarata da circa 7 a 2 microsecondi. CPU, NPU, memoria, SSD e dispositivi di rete vengono messi in comunicazione peer-to-peer, evitando che l’intero sistema dipenda da una gerarchia rigida centrata su un nodo master. Il punto industrialmente rilevante è che l’aumento del numero di acceleratori non garantisce automaticamente più prestazioni: Huawei stima che in cluster da 100.000 NPU l’utilizzo effettivo possa scendere fino al 20% quando la comunicazione diventa dominante. È lo stesso problema già evidenziato nell’evoluzione delle reti Huawei AI-native e dei SuperPoD: quando il calcolo cresce più rapidamente dell’interconnessione, aggiungere silicio produce rendimenti sempre più bassi.
OceanStor M900 sposta la KV cache dagli acceleratori agli SSD condivisi
La seconda parte dell’architettura interviene sulla memoria. Il nuovo OceanStor M900 Context Memory Storage è progettato per trasformare la KV cache dell’inferenza in un pool condiviso distribuito tra memoria on-chip, DRAM e SSD. Huawei dichiara fino a 64 PB di capacità per cluster, 40 TB/s di banda aggregata e accesso one-hop tra NPU e SSD con latenza ridotta fino a 60 microsecondi. L’architettura integra CPU, network controller e NAND controller, eliminando parte dei passaggi attraverso CPU e conversioni di protocollo che normalmente separano acceleratore e storage. Nei workload di programmazione AI citati dall’azienda, questa struttura raddoppierebbe il throughput dei token e dimezzerebbe il Time To First Token. Non è un cambio cosmetico dello storage: significa trattare la KV cache come una nuova classe di dato infrastrutturale, da conservare, riutilizzare e spostare tra sessioni agentiche. Huawei aveva già anticipato questa direzione usando OceanStor A800 e Unified Cache Manager per aumentare fino al 372% il throughput dell’inferenza su sequenze lunghe.
Atlas 960E e Hi-ONE portano l’ottica dentro il progetto del SuperPoD
Il keynote di David Wang dedicato all’infrastruttura agentica completa il disegno con Atlas 960E SuperPoD, Ascend 960 e l’interconnessione ottica Hi-ONE. Un singolo Atlas 960E può arrivare, secondo Huawei, a 4.096 NPU, 8 EFLOPS FP8, 16 EFLOPS FP4 e fino a 1 PB di HBM. Il sistema utilizza 5.500 unità Hi-ONE da 7,2 Tbit/s e punta a eliminare 48.000 moduli ottici 800G tradizionali, con un risparmio dichiarato superiore a 550 kW. Più SuperPoD possono quindi essere collegati attraverso una topologia Clos a due livelli e quattro plane fino a 512.000 NPU, mentre una configurazione multi-rail porta il target teorico al milione. In parallelo Huawei accelera la roadmap Ascend: 960DT è indicato per il primo trimestre 2027, 960PR per il terzo trimestre, seguiti da Ascend 970 nel 2028 e 980 nel 2029. Il legame con lo storage enterprise OceanStor diventa quindi strutturale: acceleratore, fotonica e memoria contestuale sono progettati come parti dello stesso sistema.
Continua con:
- Huawei Agentic Infra porta container, memoria e runtime AI dentro lo stesso stack
- La Cina accelera sull’AI mentre Huawei amplia acceleratori, reti e infrastrutture
La vera sfida di Huawei è dimostrare lo scaling fuori dai numeri dichiarati
Peerium mostra dove Huawei vuole spostare la battaglia con Nvidia e con gli altri fornitori di infrastruttura AI: non vincere necessariamente con la singola NPU più veloce, ma costruire un sistema abbastanza efficiente da rendere produttive enormi quantità di acceleratori. UnifiedBus prova a ridurre il costo della comunicazione, Hi-ONE interviene sull’interconnessione ottica, OceanStor M900 porta la memoria contestuale sugli SSD e SuperPoD organizza il tutto come un unico dominio computazionale. Resta però un punto che gli annunci non possono risolvere: le prestazioni dichiarate devono essere dimostrate su modelli reali, a scale realmente distribuite e con metriche comparabili a quelle degli ecosistemi concorrenti. Un milione di NPU nominalmente collegabili non equivale automaticamente a un milione di NPU efficientemente utilizzate. In una competizione AI ormai fondata anche su data center, energia e autonomia tecnologica, proprio l’efficienza di sistema diventa la metrica che può trasformare Peerium da architettura ambiziosa a alternativa industriale credibile.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.