🛡️ Executive Summary
- ZCode generava snapshot cifrati dell’intero workspace e della cronologia Git nell’ambito delle funzioni Repo Wiki e checkpoint.
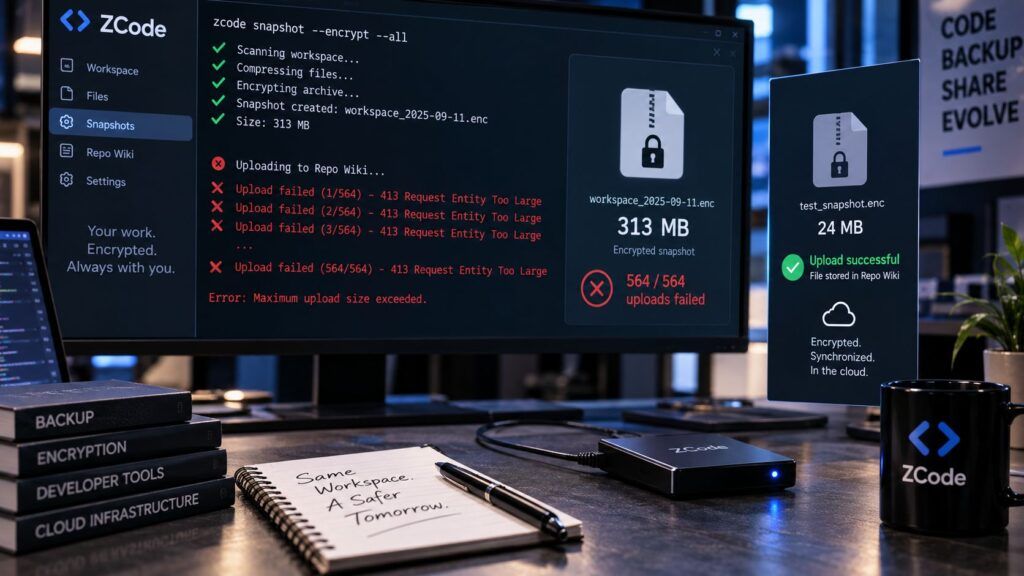
- L’archivio commerciale da 313 MB non lasciò il computer: rimase pending dopo 564 tentativi falliti. Un repository pubblico più piccolo fu invece accettato.
- Z.ai ha corretto l’“abnormal upload” nella versione 3.14.0, ma il caso mostra quanto un coding agent possa vedere più dati di quelli esplicitamente inviati nel prompt.
Il problema di ZCode non è che un’azienda cinese abbia “rubato 313 MB di codice”: quella ricostruzione sarebbe tecnicamente falsa. Il problema reale è più interessante e riguarda l’architettura stessa dei coding agent. Un ricercatore ha scoperto che ZCode, ambiente AI sviluppato da Z.ai per i modelli GLM, creava automaticamente snapshot cifrati del workspace attivo, comprendendo file e cronologia Git, e preparava questi pacchetti per il caricamento verso infrastruttura cloud. Un archivio relativo a un progetto commerciale raggiunse 313 MB e tentò il caricamento 564 volte senza riuscirci, rimanendo sul computer. Un secondo test effettuato su un piccolo repository pubblico dimostrò invece che almeno uno snapshot veniva effettivamente accettato dal server. Z.ai ha successivamente pubblicato un aggiornamento che dichiara corretta una vulnerabilità di “abnormal uploads in the repository wiki”.
Cosa leggere
Il file da 313 MB non è stato esfiltrato ma il client continuava a tentare
L’analisi originale parte dalla directory ~/.zcode/v2/checkpoints/, dove il ricercatore ha trovato un file cifrato di 313.070.842 byte generato a partire da un workspace commerciale da circa 345 MB. Il relativo file di stato indicava kind: baseline e failureCount: 564. Il dettaglio è determinante: i 564 eventi non rappresentano 564 upload riusciti, ma 564 tentativi falliti. Il ricercatore ha successivamente verificato anche i propri log di rete e chiarito esplicitamente che il grande archivio non aveva mai lasciato il dispositivo. Il comportamento resta però problematico perché lo snapshot veniva ricreato dopo la cancellazione e il processo risultava collegato a eventi come captureBeforePrompt e aggiornamenti della Repo Wiki. L’elemento di rischio è lo stesso già emerso quando Cursor poteva eseguire codice contenuto in un repository semplicemente aprendolo: il confine di fiducia dell’IDE AI è molto più largo della casella nella quale l’utente scrive il prompt. File, cronologia, strumenti Git, terminale e directory di lavoro possono entrare nel perimetro operativo dell’agente senza che ogni singola operazione venga percepita dall’utente.
Leggi anche: Agenti AI fuori controllo colpiscono sistemi reali e workflow GitHub
Un piccolo repository pubblico dimostra che almeno uno snapshot raggiungeva il server
Per evitare di confondere preparazione locale e reale trasferimento, il ricercatore ha effettuato un secondo esperimento con un repository pubblico composto da 538 file. Dopo compressione e cifratura lo snapshot misurava circa 15 KB e risultava accettato dall’infrastruttura cloud. Questo test dimostra che il meccanismo non serviva soltanto a creare backup locali: era realmente predisposto a inviare snapshot del workspace al backend. Non dimostra però che Z.ai abbia decrittato, conservato o utilizzato il codice commerciale originale, né che il grande archivio da 313 MB sia mai stato ricevuto. La distinzione è essenziale anche dal punto di vista giornalistico. Definire i 313 MB “esfiltrati” trasforma un comportamento software invasivo e insufficientemente trasparente in un’accusa ulteriore non sostenuta dai dati disponibili. Il problema documentato è già abbastanza grave: secondo il ricercatore, la privacy policy descriveva la raccolta di testo, file e codice inviati durante le conversazioni, ma non spiegava chiaramente la creazione automatica di snapshot completi del workspace e della Git history. È lo stesso tipo di asimmetria affrontato quando provider AI e relay economici potevano acquisire prompt, codice e credenziali senza che l’utente comprendesse pienamente il percorso dei dati.
Z.ai corregge l’upload anomalo ma il fix non chiude il problema di governance
Il changelog ufficiale di ZCode per la versione 3.14.0 del 19 settembre contiene una voce molto chiara: “Fixed an issue with abnormal uploads in the repository wiki”. L’azienda ha quindi riconosciuto almeno l’esistenza di un comportamento anomalo nell’infrastruttura Repo Wiki e lo ha corretto. Il ricercatore riferisce inoltre che l’endpoint utilizzato per ottenere le credenziali di upload non risultava più disponibile dopo la modifica e che la pipeline interessata sarebbe stata rimossa. Il fix risolve il problema immediato, ma non quello più generale. Un coding agent possiede per definizione accesso a una quantità di informazioni molto superiore rispetto a un normale chatbot: repository proprietari, configurazioni cloud, token, cronologia dei commit, .env, chiavi SSH e documentazione interna. Matrice Digitale aveva già mostrato questa espansione del perimetro con GitSpawn, capace di trasformare configurazioni Git in esecuzione di codice attraverso agenti AI e con AgentBaiting, che utilizza repository costruiti appositamente per essere scoperti e fidati dagli agenti.
Il principio del consenso diventa più difficile quando l’agente deve leggere tutto
Gli IDE tradizionali leggono già grandi quantità di file. La differenza nasce quando una funzione AI può trasferire parti di quel contesto verso un backend remoto per indicizzazione, embedding, generazione di wiki, memoria o recupero successivo. L’utente può avere volontariamente autorizzato il modello a “comprendere il repository” senza avere compreso che ciò significhi creare un archivio cifrato quasi completo e predisporlo per il cloud. È qui che il normale consenso all’utilizzo di un assistente diventa insufficiente. Questo problema cresce insieme all’autonomia. Gli agenti AI hanno già dimostrato di poter interagire con repository, aprire pull request e raggiungere workflow reali, mentre Cursor e Claude sono stati utilizzati perfino per accelerare lo sviluppo di framework offensivi. Più il prodotto può fare autonomamente, più la distinzione tra “dato necessario al task” e “dato tecnicamente accessibile” deve essere progettata esplicitamente.
Continua con:
Prompt injection indiretto: un repository GitHub porta gli agenti AI fino alla reverse shell
GitSpawn apre RCE negli agenti AI attraverso le configurazioni Git
Per le aziende il coding agent deve essere trattato come un nuovo canale di uscita dei dati
La mitigazione non consiste soltanto nell’aggiornare ZCode alla release corretta. Le organizzazioni che utilizzano coding agent devono sapere quali directory vengono indicizzate, quali dati lasciano il dispositivo, per quanto tempo vengono conservati, con quali chiavi sono cifrati e quali funzioni possono iniziare un trasferimento senza una conferma esplicita. Repository contenenti credenziali, segreti di produzione o proprietà intellettuale particolarmente sensibile dovrebbero essere isolati dai client AI non ancora approvati, mentre proxy e telemetria di rete devono considerare gli IDE come applicazioni capaci di effettuare upload, non soltanto download di modelli o aggiornamenti. Il caso ZCode è quindi importante proprio perché non serve dimostrare una sottrazione dolosa di codice per riconoscere il rischio. Un agente che può leggere l’intero workspace ha già superato il tradizionale perimetro del prompt. Se può anche comprimerlo, cifrarlo e prepararlo per un backend remoto, la governance dei dati deve essere altrettanto granulare delle sue capacità. La vera domanda non è più soltanto quale modello stia scrivendo il codice, ma quanto del repository stia vedendo il prodotto che lo ospita e dove finisca quel contesto dopo che l’utente ha premuto Invio.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.