⚙️ Da sapere
- Le Flexible VM di Managed Service for Apache Spark permettono di usare più famiglie di istanze per ridurre i fallimenti causati dagli stockout regionali.
- GKE Pod snapshots salva CPU e GPU memory e riduce l’avvio di workload AI fino all’89%, mentre il multi-cluster Inference Gateway distribuisce il traffico in base alla pressione reale sulla KV cache.
- Secure Source Manager rafforza la supply chain CI/CD con nuovi controlli di autenticazione e autorizzazione integrati nel repository.
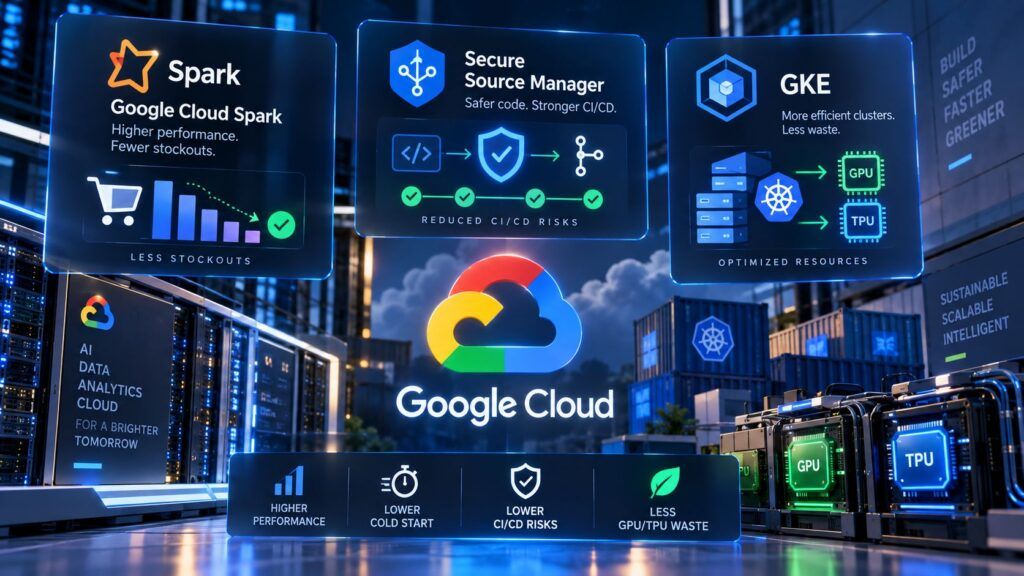
Google Cloud sta lavorando sullo stesso problema da quattro direzioni diverse: evitare che infrastrutture sempre più costose e distribuite si blocchino per rigidità, sprechi di capacità o debolezze nel software supply chain. Managed Service for Apache Spark può ora usare famiglie di VM differenti per superare gli stockout di capacità; GKE introduce snapshot dei Pod per evitare costosi cold start nei workload AI e un routing multi-cluster che distribuisce inferenza in base alla pressione reale su GPU e TPU; Secure Source Manager rafforza invece il livello CI/CD. Il filo comune è chiaro: più l’infrastruttura diventa eterogenea, più il vantaggio competitivo dipende dalla capacità di trattare compute, sicurezza e workload come risorse elastiche anziché statiche.
Cosa leggere
Apache Spark smette di dipendere da una sola famiglia di VM
Il problema degli stockout di capacità è diventato strutturale con la crescita della domanda AI. Quando una pipeline Spark richiede esclusivamente una famiglia specifica, come N2 o N2D, la mancanza temporanea di quella capacità in una determinata zona può impedire la creazione del cluster anche se Google dispone di risorse compatibili in altre famiglie. Le nuove Flexible VMs di Managed Service for Apache Spark permettono invece di indicare una lista ordinata di configurazioni accettabili per master, primary worker e secondary worker. È possibile mescolare generazioni differenti, comprese famiglie Gen2 come N2 e N2D e Gen4 come N4 e C4, adattando anche il tipo di storage alle caratteristiche dell’host effettivamente disponibile.
| Priorità / Classifica | Esempi di famiglie di macchine | Consiglio di archiviazione (Storage) |
|---|---|---|
| Rank 0 (Principale) | n1-standard-16n2-standard-16 | SSD locale standard o PD (Persistent Disk) |
| Rank 1 | n2d-standard-16 | SSD locale standard o PD |
| Rank 2 | n4-standard-16n4d-standard-16 | Hyperdisk Balanced |
| Rank 3 | e2-standard-16 | Standard PD |
La modifica cambia il modo in cui viene progettata la resilienza. Invece di sovradimensionare capacità o costruire manualmente fallback tra zone e istanze, l’orchestratore prova progressivamente le configurazioni ammesse. Il tipo di VM smette di essere un requisito rigido e diventa una preferenza ordinata. Per pipeline analytics time-sensitive questo significa ridurre il rischio che una carenza temporanea di una singola SKU si trasformi in SLA mancati o job non eseguiti. Lo stesso principio vale per workload AI e data engineering: l’elasticità non riguarda più soltanto quanti nodi creare, ma quale hardware alternativo possa essere utilizzato quando quello preferito non è disponibile.
Leggi anche: Google Cloud porta agenti e strumenti dati direttamente dentro BigQuery e gli ambienti enterprise
GKE Pod snapshots riduce fino all’89% il tempo di avvio dei workload AI
Il secondo collo di bottiglia riguarda il cold start. Un LLM può richiedere decine o centinaia di gigabyte di pesi e stato prima di poter servire la prima richiesta. Gli ambienti agentici che eseguono codice soffrono dello stesso problema quando ogni nuova sessione deve ricostruire completamente runtime e memoria. GKE Pod snapshots permette di salvare lo stato in esecuzione di un Pod, comprese CPU e GPU memory, e ripristinarlo successivamente. Google dichiara riduzioni del tempo di avvio fino all’89%, con un modello da 70 miliardi di parametri caricato in circa 37 secondi e uno da 8 miliardi in circa 15 secondi.
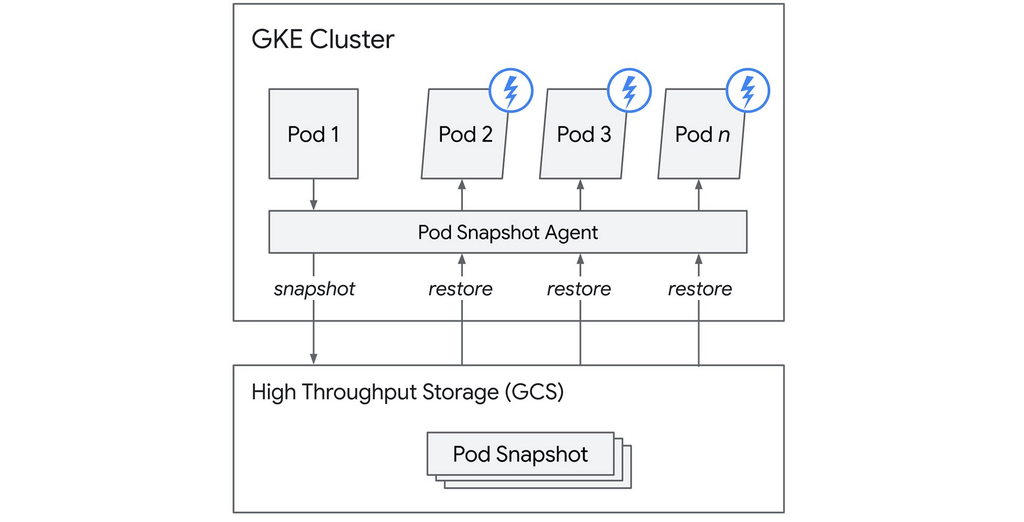
La funzione utilizza CRD dichiarativi che definiscono quali Pod acquisire, dove conservare lo snapshot, per quanto tempo mantenerlo e quale immagine ripristinare durante un nuovo deployment. Lo snapshot può essere creato all’avvio attraverso un segnale del workload oppure successivamente con un trigger on demand.
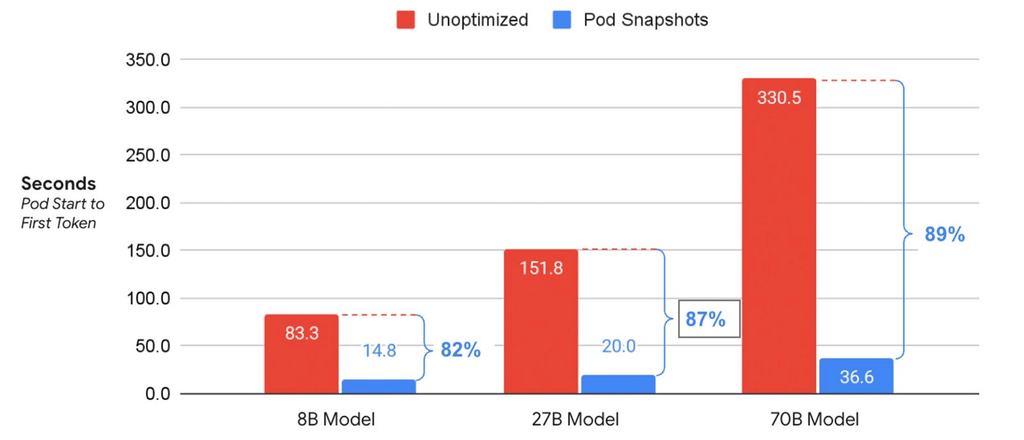
Il vantaggio economico è diretto. Molte aziende tengono capacità GPU già calda per evitare latenze inaccettabili durante il provisioning. Se il runtime può essere ripristinato quasi immediatamente, diventa possibile ridurre l’overprovisioning e spegnere più aggressivamente capacità inutilizzata. Google indica AI inference e agent sandbox come casi principali, ma il meccanismo resta workload-agnostic e può essere applicato anche a Java application complesse, game server e monoliti con tempi di inizializzazione elevati.
Secure Source Manager porta la sicurezza dentro il repository
L’elasticità infrastrutturale serve poco se la pipeline che distribuisce il software può essere compromessa. Google Cloud aggiorna quindi Secure Source Manager, il servizio gestito per repository Git privati, con nuove capacità generalmente disponibili pensate per rafforzare CI/CD e software supply chain. Il punto di partenza è il controllo unificato di autenticazione e autorizzazione tra codice sorgente e pipeline. Google sottolinea che alterare un singolo deployment script può trasformare l’intera CI/CD pipeline in un veicolo di distribuzione di malware, rendendo il repository uno dei punti di maggiore valore per un attaccante. Le nuove funzionalità riducono la necessità di costruire integrazioni separate tra repository e identità cloud e spostano più policy direttamente nel piano di controllo Google Cloud. Il valore non è soltanto amministrativo: meno identità duplicate, token persistenti e sistemi di autorizzazione separati significano meno superfici attraverso cui una compromissione del codice può propagarsi fino alla produzione. La dinamica segue l’evoluzione generale della supply-chain security: proteggere container o artefatti finali non basta se un attaccante può modificare sorgenti, workflow o script prima della build.
GKE Inference Gateway trasforma cluster globali in un unico pool di acceleratori
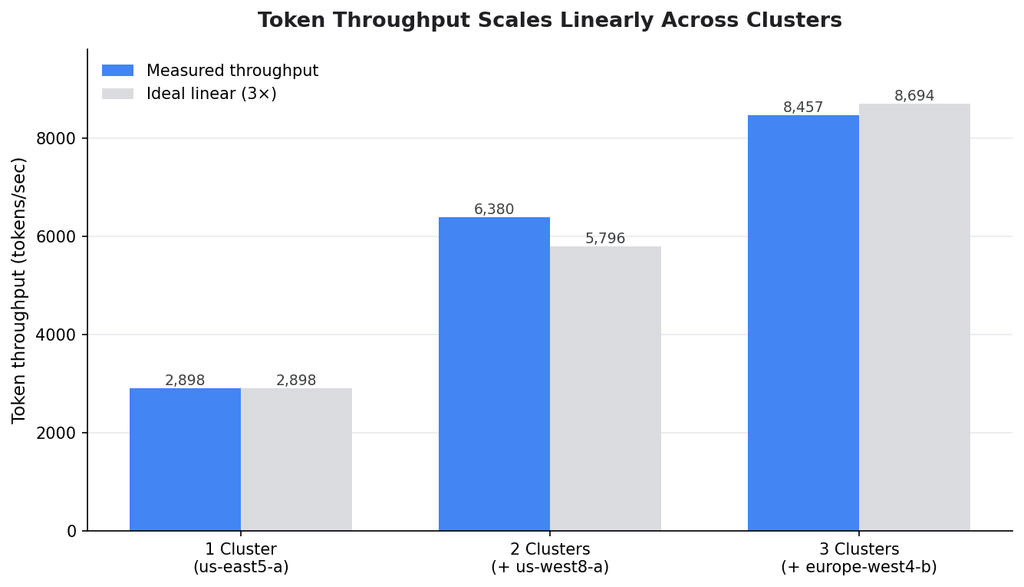
La quarta novità affronta il problema più costoso: GPU e TPU disponibili ma usate male. Google ha testato il multi-cluster GKE Inference Gateway su una distribuzione da circa 17.000 nodi compute distribuiti tra Stati Uniti ed Europa, servendo un modello Mixture-of-Experts attraverso SGLang. L’architettura utilizza un singolo endpoint globale davanti a tre cluster regionali. Il routing non avviene attraverso round-robin tradizionale, ma utilizzando segnali applicativi reali. L’Endpoint Picker Proxy legge metriche come utilizzo della KV cache, queue depth o concorrenza attiva e sposta il traffico quando un cluster si avvicina alla saturazione della memoria acceleratore.
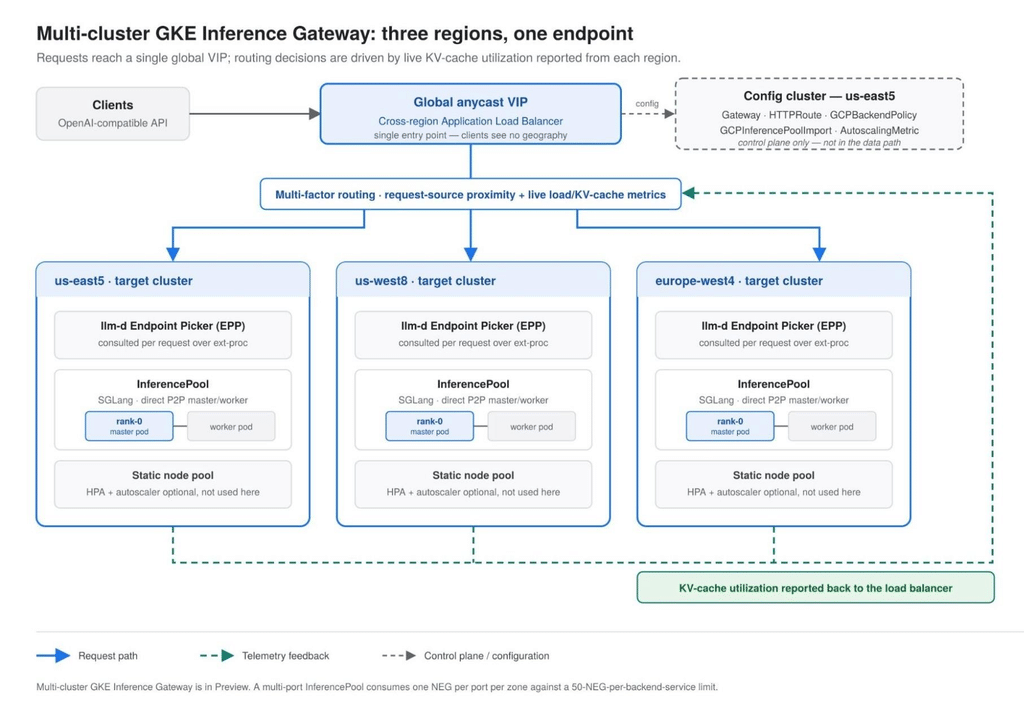
Nei benchmark Google, il passaggio da uno a tre cluster ha portato il throughput richieste da 0,72 a 2,10 req/s e quello token da 2.898 a 8.457 tok/s, mantenendo un success rate vicino al 99,9%. Il costo introdotto dal routing multi-cluster è rimasto inferiore all’1%, con il gateway capace di mantenere circa il 99,5% del throughput di una chiamata diretta al cluster locale. È un risultato importante perché l’inferenza distribuita non è più limitata dalla capacità di un singolo data center. Quando GPU e TPU sono disponibili in regioni differenti, il gateway può trattarle come una flotta comune e spostare le richieste in base alla pressione effettiva.
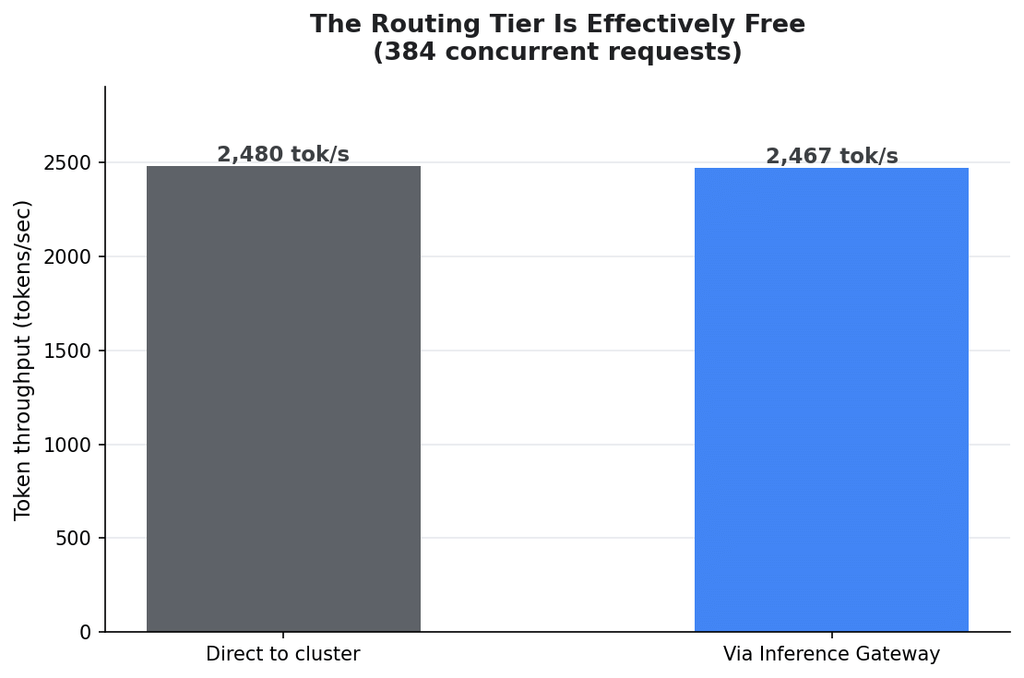
La stessa logica era già emersa con le precedenti ottimizzazioni di GKE Inference Gateway per ridurre latenza e sprechi di acceleratori, ma il nuovo test multi-cluster mostra il salto di scala: la variabile critica non è più semplicemente avere acceleratori, ma evitare che alcuni restino scarichi mentre altri saturano.
Il vero collo di bottiglia diventa l’orchestrazione della capacità
Spark Flexible VMs, Pod snapshots e GKE Inference Gateway risolvono problemi diversi, ma condividono una stessa premessa: la capacità disponibile è troppo costosa per essere utilizzata in modo rigido. Nel data processing, la rigidità consiste nel chiedere una sola famiglia di VM. Nell’inferenza, nel ricreare completamente uno stato già noto o nel distribuire richieste senza sapere quale acceleratore sia effettivamente saturo. Nel CI/CD, nel mantenere identità e autorizzazioni frammentate tra sistemi separati.
Google Cloud prova quindi a spostare l’intelligenza dal workload all’orchestratore. La piattaforma decide quale VM usare, quale snapshot ripristinare, quale cluster servire e chi può modificare il codice. Il software applicativo continua a fare il proprio lavoro, ma il cloud assume sempre più decisioni sull’allocazione delle risorse e sulla sicurezza della catena operativa.
Continua con:
Google Cloud porta protezione post-quantum e nuovi controlli di sicurezza nelle chiavi BYOK
Google Cloud estende agenti, MCP e analytics direttamente nei workflow enterprise
Google Cloud sta ottimizzando la scarsità più che la potenza assoluta
Il dato più significativo dei quattro annunci non è il picco prestazionale. È che Google progetta ormai il cloud assumendo che la risorsa desiderata possa non essere disponibile, che la GPU possa restare inutilizzata e che ricostruire un workload da zero sia troppo costoso. Flexible VMs accetta hardware equivalente invece di fallire. Pod snapshots riutilizza stato già inizializzato invece di ricrearlo. Inference Gateway sposta richieste verso acceleratori meno saturi invece di sovraccaricare quelli più vicini. Secure Source Manager riduce invece la frammentazione del piano di controllo della supply chain. La direzione è più industriale che spettacolare: massimizzare il lavoro utile per unità di compute disponibile. In una fase in cui GPU, TPU e capacità regionale continuano a essere risorse scarse, questo può contare più dell’ennesimo incremento teorico di potenza.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.