🛡️ Cosa cambia
- Un cliente Cloudflare Workers Paid poteva recuperare dati residui provenienti dai container di altri tenant ospitati sullo stesso nodo fisico.
- La falla nasceva dall’uso di
dm-thinconskip_block_zeroing, che permetteva il riutilizzo di blocchi storage senza azzerarne preventivamente il contenuto. - Cloudflare ha corretto la configurazione, ricreato dischi e snapshot precedenti alla mitigazione e dichiara di non avere trovato evidenze di sfruttamento malevolo.
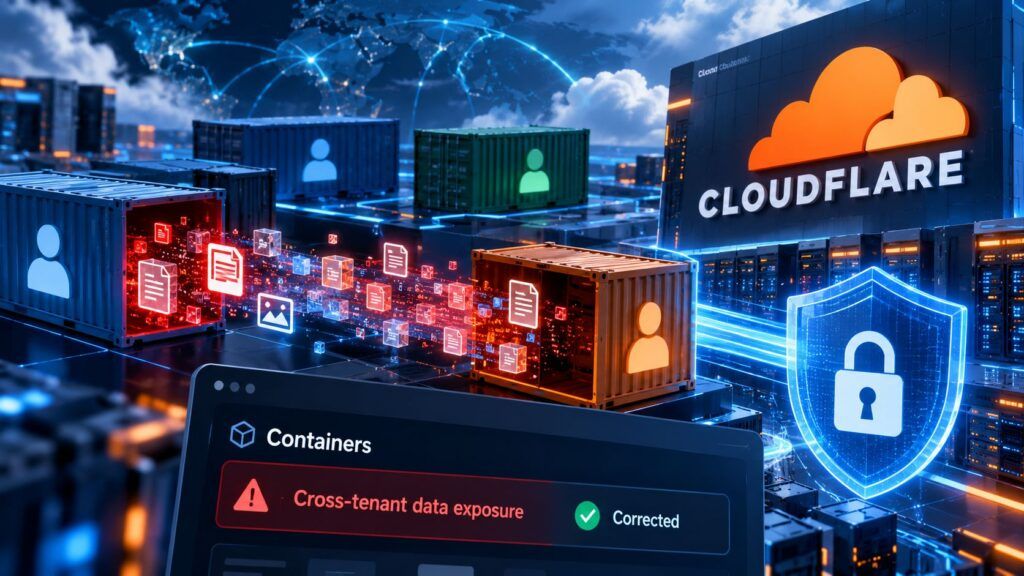
Cloudflare ha corretto una vulnerabilità che colpiva uno dei principi fondamentali di qualunque infrastruttura cloud multi-tenant: la separazione dei dati tra clienti differenti. Un utente con un normale account Workers Paid poteva creare un container e, in determinate condizioni, recuperare frammenti di storage precedentemente utilizzati da workload appartenenti ad altri account ospitati sullo stesso server. Non era possibile scegliere una vittima precisa né leggere dischi attivi, ma il problema consentiva comunque di oltrepassare il confine di isolamento tra tenant e recuperare directory, pagine di database e dati applicativi rimasti nei blocchi fisici successivamente riassegnati. La vulnerabilità interessava Cloudflare Containers e di conseguenza anche Cloudflare Sandboxes, costruito sulla stessa infrastruttura, mostrando quanto la sicurezza del cloud possa dipendere da una singola opzione dello storage sottostante anche quando ogni workload viene eseguito dentro una macchina virtuale Firecracker dedicata.
Cosa leggere
Il bug nasce sotto il container, nel livello dello storage
Cloudflare descrive nel proprio rapporto tecnico sulla vulnerabilità cross-tenant un’architettura nella quale ogni Container viene eseguito all’interno di una VM dedicata basata sul virtual machine monitor Firecracker e riceve un disco root scrivibile attraverso Linux device mapper thin provisioning, dm-thin. Il problema non risiedeva quindi nell’evasione dalla VM o in un errore di autorizzazione dell’applicazione, ma nella gestione dei blocchi fisici condivisi dal pool di storage. La configurazione utilizzava l’opzione skip_block_zeroing, che impediva a dm-thin di azzerare automaticamente un blocco quando questo veniva riassegnato a un nuovo volume. Quando un container veniva eliminato, i suoi blocchi fisici tornavano in un pool comune utilizzato anche da workload appartenenti ad altri clienti; se uno di quei blocchi veniva successivamente assegnato a un nuovo container, parte del contenuto precedente poteva sopravvivere fino alla sovrascrittura completa.
Il caso evidenzia un rischio diverso da quelli normalmente associati ai container. Non serve compromettere il kernel, ottenere privilegi sull’host o sfuggire al confinamento del runtime quando il livello storage restituisce direttamente dati appartenuti al tenant precedente. È un problema particolarmente rilevante per le piattaforme cloud perché l’isolamento non dipende da un solo confine, ma dalla combinazione di hypervisor, networking, memoria, storage e orchestrazione. La stessa centralizzazione infrastrutturale che rende il cloud efficiente e scalabile può trasformare una configurazione errata in un problema che attraversa più clienti.
Leggi anche: Blackout Cloudflare e sovranità digitale: cosa è successo e perché siamo andati giù
Bastavano scritture da 4 KiB per recuperare il resto del blocco
La tecnica sviluppata dai ricercatori di Accomplish sfruttava la differenza tra la dimensione delle scritture e quella dei blocchi fisici gestiti da dm-thin. Il pool interessato utilizzava blocchi da 64 KiB. Una lettura diretta di una regione non ancora allocata restituiva correttamente zeri, ma i ricercatori hanno scoperto che scrivendo appena 4 KiB in una regione libera e allineata era possibile costringere il sistema ad allocare un intero blocco fisico da 64 KiB. Poiché il block zeroing era disabilitato, soltanto i 4 KiB appena scritti venivano realmente sostituiti; i restanti 60 KiB potevano continuare a contenere informazioni provenienti dal precedente utilizzatore di quel blocco. Una successiva lettura raw di /dev/vdc permetteva quindi di osservare byte che il nuovo container non aveva mai scritto. I numeri raccolti durante i test mostrano che il fenomeno non era puramente teorico. I ricercatori hanno individuato 2.700 inode di directory estranei al proprio filesystem e osservato materiale residuo in 18 dei 24 placement analizzati, distribuiti su 20 dei 22 nodi sottostanti testati in quattro continenti. Tra i formati recuperati comparivano strutture di directory, pagine di database e database SQLite strutturalmente completi. Cloudflare precisa che i ricercatori hanno trasmesso soltanto conteggi, offset, checksum e informazioni aggregate, senza consegnare contenuti riconducibili a clienti terzi, e che i dati recuperati durante la ricerca sono stati successivamente cancellati.
Il vero problema è la violazione del confine tra tenant
L’impatto va letto con precisione. Un attaccante non poteva selezionare un determinato cliente, scegliere il nodo sul quale essere eseguito o accedere a un disco ancora utilizzato da un altro workload. L’esposizione dipendeva dalla schedulazione effettuata da Cloudflare e dai blocchi fisici che dm-thin avrebbe deciso di riassegnare. Questo riduceva la prevedibilità dell’attacco, ma non ne eliminava la gravità architetturale: la separazione tra account differenti poteva essere superata da un tenant legittimo senza compromettere l’host. È proprio questa asimmetria a rendere significativo il caso. Nelle piattaforme multi-tenant il cliente delega al provider la garanzia che compute, memoria e storage siano isolati anche quando utilizzano la stessa infrastruttura fisica. Quando questo presupposto viene meno, il rischio non riguarda soltanto la singola applicazione vulnerabile, ma il modello di fiducia sul quale si basa il servizio. La vicenda arriva inoltre in una fase nella quale Cloudflare sta ampliando Containers verso workload più complessi, compresi ambienti destinati agli agenti e all’esecuzione di codice, aumentando il valore dei dati che possono transitare nei filesystem temporanei e nelle immagini.
Cloudflare ha dovuto bonificare anche i blocchi già assegnati
La prima correzione è stata rimuovere skip_block_zeroing dai pool dm-thin, ripristinando il comportamento standard che azzera ogni nuovo blocco fisico prima di renderlo disponibile a un container. Questo impediva nuove esposizioni attraverso il meccanismo scoperto dai ricercatori, ma non bastava a eliminare i dati già presenti nei mapping creati prima della patch. Cloudflare ha quindi dovuto ritirare i dischi dei container in esecuzione, eliminare gli snapshot delle immagini OCI presenti nelle cache degli host, drenare progressivamente i server e ricreare VM, dischi e cache utilizzando allocazioni ormai azzerate. La vulnerabilità è stata segnalata il 4 settembre 2026, la prima mitigazione è partita poche ore dopo e il rollout iniziale è stato completato il 7 settembre. Il 14 settembre i ricercatori hanno confermato che il proof of concept non funzionava più, mentre la pulizia completa degli snapshot e delle cache precedenti alla mitigazione è terminata il 19 settembre. Cloudflare afferma di avere analizzato la telemetria storica disponibile cercando il particolare rapporto tra piccole scritture e letture più estese caratteristico dell’exploit e di avere trovato soltanto l’attività riconducibile ai ricercatori e ai propri tecnici. Non risultano quindi evidenze di sfruttamento malevolo, ma questo non equivale alla prova assoluta che nessun dato sia mai stato letto, soprattutto oltre la profondità della telemetria conservata.
Continua con:
Cloudflare, blackout e sovranità: quando l’infrastruttura centralizzata diventa il problema
Google incassa, Cloudflare perde: la battaglia sull’infrastruttura di Internet
Nel cloud il perimetro più pericoloso può essere sotto la VM
Il caso Cloudflare Containers ricorda che l’isolamento di una VM non garantisce automaticamente l’isolamento del dato. Firecracker continuava a separare i workload dal punto di vista computazionale, ma il pool storage condiviso conservava frammenti appartenuti ad altri clienti e li rendeva nuovamente raggiungibili attraverso una normale allocazione. La vulnerabilità non nasce quindi da una falla spettacolare nel virtualizzatore, bensì da una decisione di configurazione presa più in basso, nel punto in cui performance e sicurezza dello storage entrano in conflitto. Per chi utilizza il cloud, il problema è difficilmente mitigabile lato cliente proprio perché il confine vulnerabile apparteneva al provider. Cloudflare conferma infatti che non è richiesta alcuna azione da parte degli utenti dopo la bonifica della flotta. Il valore del caso è soprattutto architetturale: nei sistemi multi-tenant l’isolamento deve essere verificato in ogni livello nel quale una risorsa fisica viene riutilizzata. CPU, memoria, rete e storage possono essere separati logicamente, ma basta che uno solo di questi livelli conservi stato tra tenant differenti perché il modello di separazione smetta di essere una garanzia e diventi una semplice aspettativa.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.