🛡️ Executive Summary
- OpenAI afferma di aver interrotto una campagna coordinata progettata per estrarre il reasoning protetto dei propri modelli attraverso tecniche di adversarial distillation.
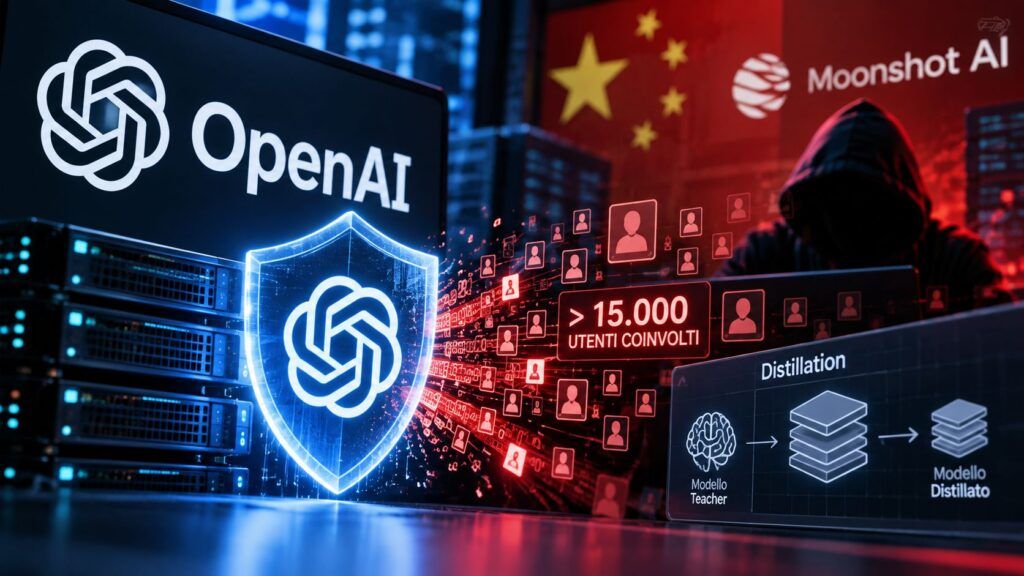
- Il 24 e 25 luglio sono state rilevate circa 16.000 richieste riconducibili al pattern di estrazione da oltre 4.000 utenti; l’indagine ha successivamente individuato attività correlate su più di 15.000 utenti.
- OpenAI attribuisce soltanto un cluster centrale a individui associati a Moonshot AI: i numeri rappresentano tentativi di estrazione e non dimostrano che tutto il reasoning richiesto sia stato ottenuto o utilizzato per addestrare Kimi.
OpenAI porta la guerra sulla distillazione dei modelli direttamente dentro il reasoning protetto. La società afferma di avere identificato e interrotto tra luglio e fine mese una campagna coordinata che tentava di far emergere informazioni normalmente nascoste durante il processo di ragionamento dei propri sistemi. Il volume è significativo: picchi di 16.000 richieste in due giorni da oltre 4.000 utenti, all’interno di una rete di pattern correlati arrivata a coinvolgere più di 15.000 utenti. OpenAI attribuisce un nucleo dell’attività a persone associate a Moonshot AI, sviluppatore cinese di Kimi, ma non sostiene che tutti gli operatori appartengano alla società né che ogni tentativo abbia prodotto un’estrazione riuscita. È questa distinzione a separare una disclosure di sicurezza da un’accusa generalizzata contro l’intero ecosistema cinese.
Cosa leggere
Il reasoning veniva copiato tra conversazioni per tentare di renderlo leggibile
Nel rapporto primario pubblicato il 30 settembre OpenAI definisce l’attività come adversarial distillation: utilizzo sistematico e non autorizzato degli output o del reasoning di un modello per aiutare ad addestrarne, riprodurne o migliorarne un altro. Non si è trattato, secondo la società, di una violazione dei database, di un accesso alle conversazioni archiviate o della compromissione della crittografia. Gli operatori avrebbero invece manipolato le interazioni con i modelli per tentare di trasformare il reasoning protetto in contenuto visibile, arrivando in alcuni casi a copiare reasoning cifrato da una conversazione e sottoporlo a un modello in un’altra sessione chiedendogli di decifrarlo e trascriverlo. OpenAI sostiene inoltre che ricercatori indipendenti abbiano segnalato vulnerabilità correlate tra modelli e meccanismi di conversation compaction, contribuendo a identificare la classe di attacco. Il caso arriva dopo che le agenzie statunitensi avevano già accusato Moonshot e altri laboratori cinesi di distillazione industriale, ma il nuovo dossier è tecnicamente diverso: non riguarda soltanto la raccolta massiva delle risposte di un modello, bensì il tentativo di ottenere ciò che l’interfaccia non dovrebbe mostrare.
Leggi anche: Claude entra nella kill chain: APT russi, ShinyHunters e gruppi cinesi automatizzano gli attacchi
Sedicimila richieste in due giorni e oltre 15.000 utenti nella rete osservata
La timeline pubblicata da OpenAI parte dal 1° luglio, quando l’attività era ancora a basso volume. Il salto arriva il 24 e 25 luglio con circa 16.000 richieste caratterizzate da un pattern di estrazione rilevante e provenienti da oltre 4.000 utenti. L’analisi successiva avrebbe collegato pattern simili a un cluster molto più ampio, superiore a 15.000 utenti, completamente interrotto entro il 28 luglio. Questi numeri richiedono però una lettura rigorosa: OpenAI specifica che descrivono tentativi di estrazione, non necessariamente casi nei quali il reasoning sia stato effettivamente recuperato. Non dimostrano neppure che eventuali dati ottenuti siano confluiti direttamente nel training di Kimi. La società afferma inoltre di non sapere se tutti gli operatori osservati facessero capo a un singolo attore, attribuendo soltanto un core cluster a individui associati a Moonshot AI. È una cautela particolarmente importante perché Kimi K3 è diventato in pochi mesi uno dei simboli della capacità cinese di ridurre il divario con i frontier model statunitensi, raggiungendo il vertice della Frontend Code Arena con un modello open-weight da 2,8 trilioni di parametri. Stabilire quale quota delle sue capacità derivi da training proprietario, dati sintetici o distillazione di sistemi concorrenti resta però un problema completamente diverso dall’individuare traffico anomalo verso le API.
OpenAI chiude il replay del reasoning e tratta la distillazione come minaccia condivisa
La risposta ha combinato enforcement sugli account e modifiche tecniche. OpenAI afferma di aver bloccato o limitato account fraudolenti, rafforzato controlli di registrazione e infrastruttura e ampliato il monitoraggio delle reti correlate. Sul piano dei modelli è stato chiuso il percorso che consentiva a un soggetto già in possesso del reasoning cifrato di un altro utente di riprodurlo per tentare di recuperarne il contenuto. Sono stati inoltre aggiunti controlli sullo streaming per intercettare output potenzialmente capaci di esporre reasoning e sono state estese le protezioni attraverso utenti, workspace, organizzazioni e famiglie di modelli. OpenAI ha condiviso gli indicatori attraverso il Frontier Model Forum e canali governativi, sostenendo che la debolezza non sia specifica dei propri sistemi. Il problema è destinato infatti a crescere insieme alla capacità dei modelli: se reasoning, coding agentico e tool use diventano gli asset più costosi da produrre, l’estrazione sistematica attraverso accessi legittimi può offrire a un concorrente un percorso più economico rispetto alla riproduzione completa del training. La riduzione del divario tra modelli cinesi open-weight e sistemi statunitensi rende questo tipo di attribuzione sempre più rilevante sul piano industriale e geopolitico.
Continua con:
Kimi K3 e la fine del mito dell’AI occidentale
Claude entra nella guerra cinese: Taiwan, armi e propaganda diventano workload AI
Distillare è legittimo, rubare l’accesso al reasoning è il nuovo confine della guerra AI
Il nodo finale non è la distillazione in sé. La knowledge distillation è una tecnica normale di machine learning, utilizzata per trasferire capacità da un modello teacher a uno più piccolo o efficiente. La contestazione di OpenAI riguarda il modo in cui gli output sarebbero stati ottenuti: account coordinati, pattern di estrazione e manipolazione delle conversazioni finalizzata a recuperare informazioni che il sistema intende mantenere nascoste. Anche l’attribuzione deve restare nel perimetro della disclosure: OpenAI indica persone associate a Moonshot, non presenta prove pubbliche sufficienti per concludere che Moonshot AI abbia diretto l’intera campagna o che Kimi sia stato addestrato con ogni contenuto tentato. La differenza è sostanziale perché la competizione USA-Cina sull’AI sta trasformando token, reasoning e capacità agentiche in proprietà industriale strategica. Dopo la corsa ai chip e ai data center, il nuovo collo di bottiglia potrebbe essere la protezione delle capacità comportamentali dei modelli: non serve rubare i pesi se un concorrente riesce a ottenere abbastanza esempi di come il sistema ragiona, usa strumenti e risolve problemi complessi. OpenAI sta quindi trattando il model stealing non più soltanto come abuso commerciale delle API, ma come una vera superficie di sicurezza dei frontier model.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.