📌 In Sintesi
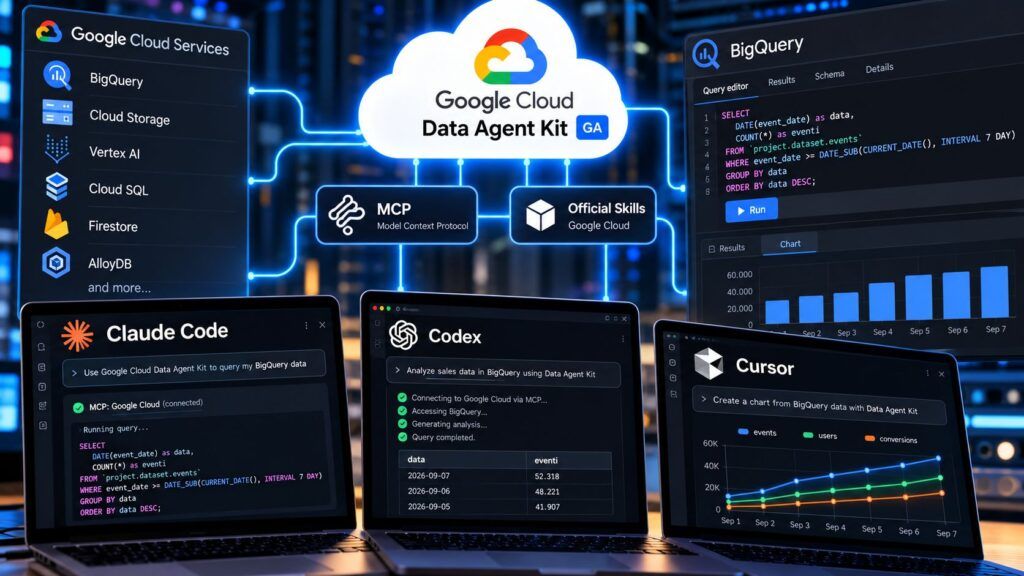
- Google porta Data Agent Kit in disponibilità generale e collega gli agenti a più di 15 servizi Data Cloud attraverso MCP e skill ufficiali.
- La GA aggiunge BigQuery Graph, Bigtable e Managed Service for Apache Spark, oltre a pipeline dbt, Dataform e Airflow gestibili dagli agenti.
- Claude Code e Codex possono operare direttamente sul data stack Google, mentre IAM, Model Armor e VPC Service Controls diventano il vero perimetro di sicurezza.
Google porta Data Agent Kit in disponibilità generale e trasforma il proprio data stack in una superficie operativa per agenti di coding esterni. Claude Code, Codex, Cursor e Antigravity possono collegarsi direttamente a BigQuery, AlloyDB, Cloud SQL, Bigtable e altri servizi attraverso MCP e skill ufficiali, senza costringere lo sviluppatore a copiare schemi, log ed errori dentro il prompt. Il salto non è che l’agente sappia scrivere SQL: è che possa leggere il contesto reale dell’ambiente, eseguire query, seguire job, proporre modifiche e costruire pipeline usando gli stessi permessi IAM dell’utente o del service account impersonato. Per Google, il modello può anche appartenere a un concorrente: il valore deve restare nei dati e nell’infrastruttura.
Cosa leggere
Data Agent Kit passa da preview a GA e apre il data stack agli agenti
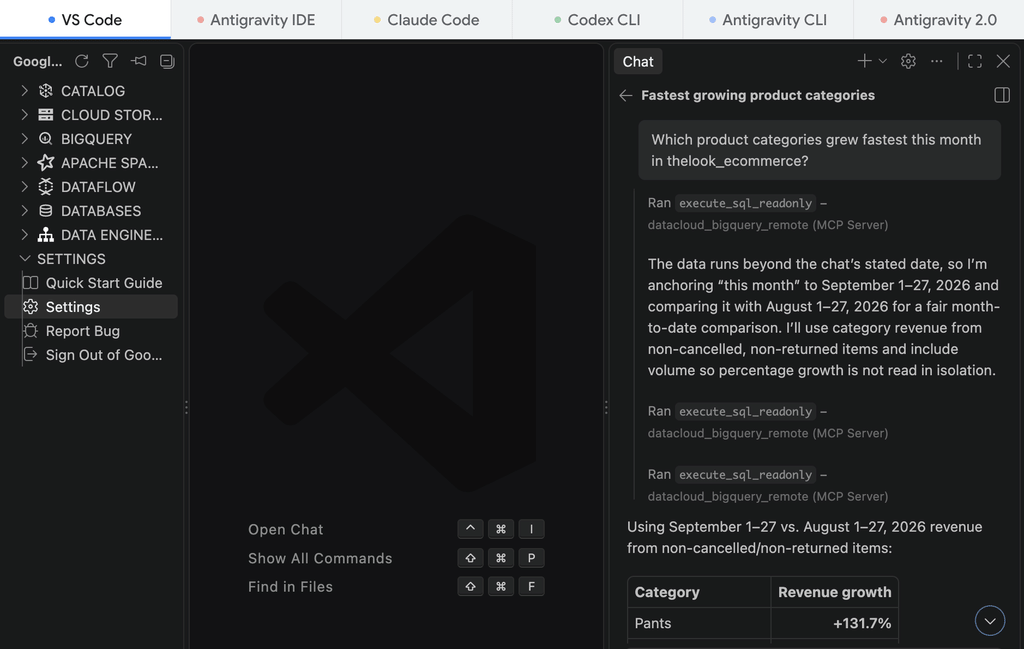
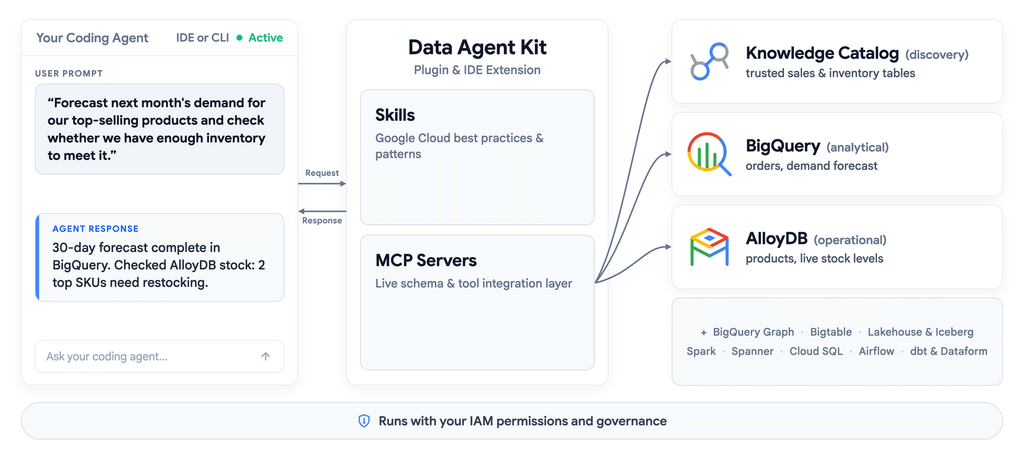
La documentazione ufficiale di Google Cloud spiega che Data Agent Kit combina MCP tools e Google-authored skills per collegare agenti esterni a più di 15 servizi Google Data Cloud. La release GA aggiunge BigQuery Graph, Bigtable e Managed Service for Apache Spark, mentre il kit resta utilizzabile come estensione per VS Code, Antigravity IDE e Cursor oppure come plugin per Claude Code e Codex. La differenza rispetto a un normale assistente SQL è sostanziale: l’agente può ispezionare schemi reali, verificare partizionamento e lineage, eseguire query, leggere job log e amministrare risorse dentro l’ambiente live. Google aveva già anticipato questa direzione con QueryData e gli strumenti progettati per ridurre gli errori degli agenti sui database, ma la GA rende stabile un modello nel quale l’agente non si limita più a suggerire codice: opera direttamente sul data estate.
Leggi anche: Google porta Data Agent Kit e Antigravity SDK dentro dati e workflow enterprise
BigQuery Graph e Bigtable diventano oggetti manipolabili in linguaggio naturale
La GA amplia anche il tipo di attività che l’agente può svolgere. Per BigQuery Graph una skill può trasformare tabelle in nodi e archi, verificare le relazioni proposte sui dati e presentare un piano da approvare prima della creazione del property graph; una seconda skill genera poi query GQL. Su Bigtable il modello può progettare row key in base al pattern di accesso, segnalare hotspot e full table scan prima che la struttura venga creata.
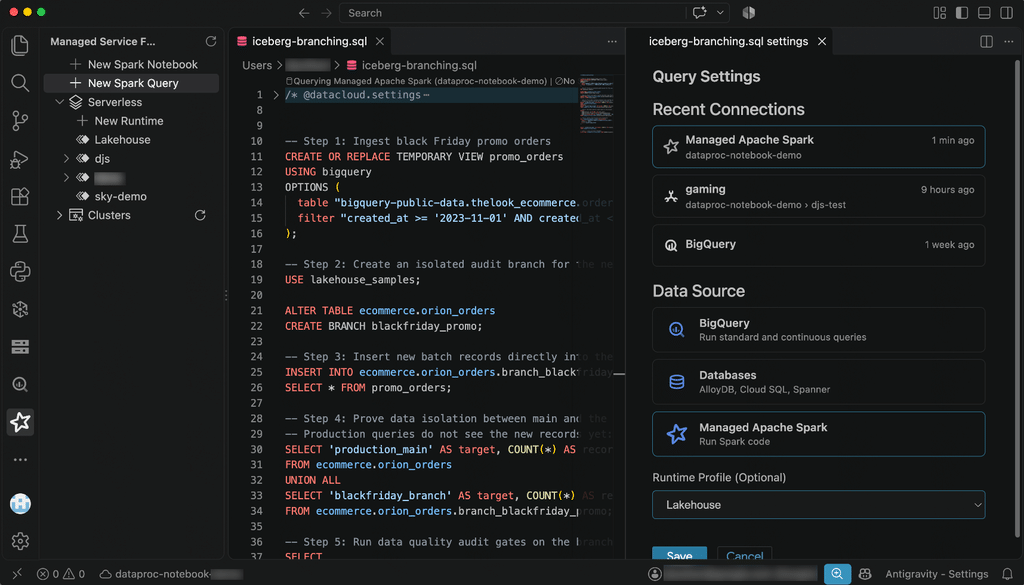
Nel lakehouse, Managed Service for Apache Spark permette di lavorare sulle stesse tabelle Iceberg interrogate da BigQuery, mentre una skill di federazione collega anche AWS Glue e Databricks Unity Catalog senza obbligare a costruire prima una pipeline di ingestione. Il salto è coerente con la strategia con cui Google ha già portato MCP, Spanner Graph e agenti dentro l’infrastruttura cloud: il cloud non viene più soltanto amministrato da una console, ma esposto come insieme di strumenti che l’agente può invocare all’interno di una sequenza di lavoro.
IAM, Model Armor e VPC Service Controls diventano il perimetro reale
Il passaggio più delicato riguarda la sicurezza. Data Agent Kit non introduce un’identità privilegiata separata: l’agente opera come utente oppure attraverso un service account impersonato, quindi le policy row-level e column-level restano applicate. Google indica inoltre IAM per governare l’accesso MCP, Model Armor per ispezionare il traffico e VPC Service Controls e Principal Access Boundary per delimitare le risorse raggiungibili. È un dettaglio centrale perché un agente con accesso a schema, query, pipeline e database non rappresenta più soltanto un copilota.
Diventa un processo autorizzato capace di produrre effetti sui dati. Le precedenti integrazioni tra AlloyDB, MCP e agenti AI avevano già mostrato che la vera separazione non è più tra modello e database, ma tra identità, strumenti e privilegi. Data Agent Kit porta quella trust boundary direttamente dentro IDE e terminale, obbligando i team a trattare le autorizzazioni degli agenti con la stessa attenzione riservata alle identità umane e ai workload automatizzati.
Continua con:
Gemini Enterprise porta MCP e Spanner Graph nel cloud
Google Cloud usa QueryData per ridurre gli errori degli agenti sui database
Google accetta che l’interfaccia al proprio cloud possa essere Claude o Codex
L’aspetto industrialmente più interessante è che Google non prova a obbligare gli sviluppatori a usare Gemini come unico front-end. Data Agent Kit documenta esplicitamente Claude Code e Codex, oltre a Cursor e Antigravity, e offre skill open source che possono essere ispezionate, modificate o sostituite. Il modello può quindi appartenere a un concorrente mentre dati, IAM, logging, pipeline e fatturazione restano dentro Google Cloud. È una scelta che sposta la competizione dall’assistente alla piattaforma: se il developer preferisce Claude per il coding o Codex per il workflow agentico, Google vuole comunque che query, Spark, Airflow, Bigtable e BigQuery restino nel proprio perimetro. La stessa apertura era già comparsa quando Google Cloud aveva trasformato Skills e MCP in un plugin installabile dentro Claude Code e Codex. Con Data Agent Kit GA, la strategia diventa ancora più evidente: l’agente può cambiare, ma il dato e l’infrastruttura che gli permettono di agire devono restare il vero lock-in.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.