📌 In sintesi
- Microsoft porterà Maia 300 in produzione nel 2027 e vuole trasformare Maia nel sistema principale di inferenza per i propri prodotti e servizi AI.
- Il nuovo acceleratore promette il 40% di token in più per megawatt rispetto ai principali sistemi GPU e fino a sette volte il throughput per rack di Maia 200.
- Microsoft non sta abbandonando NVIDIA e AMD: Maia serve soprattutto a controllare costi, energia e architettura dei workload che Redmond conosce meglio.
Microsoft vuole smettere di comprare tutta la propria capacità AI nello stesso modo in cui la comprano i suoi clienti. Maia 300, terza generazione dell’acceleratore sviluppato internamente per Azure, entrerà in produzione nel 2027 e diventerà progressivamente il sistema principale utilizzato per l’inferenza nei prodotti e servizi Microsoft. Nel piano ufficiale presentato da Scott Guthrie Redmond annuncia deployment nell’ordine dei multi-gigawatt e punta soprattutto su una metrica che racconta meglio della potenza teorica dove si sta spostando la guerra dell’AI: token prodotti per ogni megawatt consumato. Maia 300 promette il 40% in più rispetto ai principali sistemi basati su GPU. Non significa che Microsoft stia sostituendo NVIDIA. Significa qualcosa di economicamente più importante: sta costruendo un’alternativa proprietaria per i carichi che esegue in quantità abbastanza grandi da giustificare silicio, rete e software progettati insieme.
Cosa leggere
Maia 300 nasce per reasoning lungo e agenti che lavorano per ore
Microsoft non presenta Maia 300 come un acceleratore general purpose destinato a vincere una gara astratta di FLOPS. L’architettura è esplicitamente inference-first e pensata per workload sempre più condizionati dalla memoria: contesti lunghi, conversazioni sensibili alla latenza, decoding e attività agentiche multi-step che mantengono uno stato per molto più tempo rispetto alla generazione di una normale risposta chatbot. Il chip utilizza otto stack HBM4 per 18 TB/s di bandwidth, un TDP di 950 watt e una struttura chiplet nella quale compute, memory controller e I/O vengono separati. I compute chiplet sono prodotti con processo TSMC N2P. Una configurazione completa riunisce 96 acceleratori, 27,6 TB di HBM e 1,7 PB/s di banda aggregata entro un rack da 167 kW. Microsoft dichiara fino a sette volte il throughput per rack di Maia 200. È la prosecuzione della strategia già evidente quando Maia 200 aveva portato Microsoft direttamente nella corsa agli acceleratori proprietari.
Leggi anche: Avanzamenti nei chip AI: Intel, Microsoft e Cina sfidano Nvidia
Il collo di bottiglia non è più soltanto il calcolo ma spostare i dati
La caratteristica più interessante di Maia 300 è l’attenzione dedicata al data movement. Microsoft sostiene che, nei grandi workload di inferenza, muovere continuamente pesi, KV cache e dati tra memoria, acceleratori e rete può diventare un limite più importante della capacità matematica del chip. Maia utilizza quindi un dataflow definito via software, SRAM on-die gestita come scratchpad e un’interconnessione che estende lo stesso modello operativo dal chip alla rete.
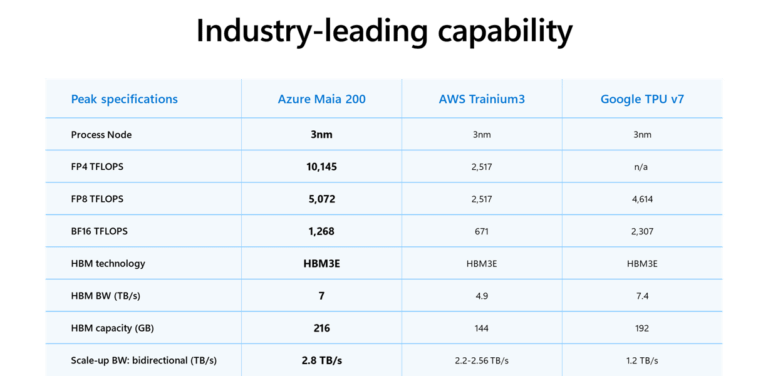
Il sistema usa Ethernet come base e un trasporto AI personalizzato per collegare acceleratori e rack. La filosofia era già visibile nel Maia 200 presentato a gennaio, che dispone di 216 GB di HBM3e, 7 TB/s di banda e può scalare fino a 6.144 acceleratori. Con Maia 300 Microsoft porta questa logica a un livello superiore: non progettare una GPU universale, ma costruire una macchina industriale ottimizzata intorno al comportamento reale dei propri modelli.
Il vero obiettivo è ridurre il costo strutturale di Copilot
Maia 200 è già utilizzato per Microsoft Copilot e dal team MAI, mentre GitHub Copilot e Microsoft Foundry dovrebbero seguirlo entro la fine dell’anno. Microsoft dichiara fino a 1,7 volte più token per watt per alcune funzioni AI integrate in Teams, Copilot e Cowork rispetto alle principali infrastrutture GPU utilizzate come riferimento. Maia 300 nasce dai dati raccolti proprio su questi carichi. Questo chiarisce perché il progetto abbia senso anche senza superare NVIDIA in ogni benchmark.
Microsoft controlla uno dei maggiori volumi mondiali di inferenza commerciale e ogni piccolo miglioramento nel costo per token, nella densità dei rack o nel consumo elettrico viene moltiplicato per centinaia di milioni di utenti e miliardi di richieste. In una fase nella quale energia e disponibilità dei megawatt stanno diventando colli di bottiglia dei data center AI, il vantaggio competitivo può arrivare dal numero di token ottenuti dallo stesso impianto elettrico prima ancora che dal numero di GPU acquistate.
NVIDIA resta dentro Azure e questo rende Maia più interessante
La lettura secondo cui Maia sarebbe il chip con cui Microsoft “lascia NVIDIA” non regge alle fonti della stessa azienda. A marzo Redmond ha annunciato nuove infrastrutture Azure basate sui sistemi NVIDIA Vera Rubin e continua a integrare hardware e software NVIDIA dentro Foundry, Physical AI e infrastrutture cloud. A luglio ha contemporaneamente ampliato la collaborazione con AMD portando Helios e nuove generazioni EPYC su Azure. Microsoft definisce infatti la propria piattaforma eterogenea: Maia, NVIDIA e AMD devono convivere perché training frontier, inferenza, HPC e workload enterprise non richiedono necessariamente lo stesso acceleratore.
La differenza strategica è che con Maia Redmond possiede finalmente un’opzione interna quando il workload è abbastanza grande e prevedibile da rendere più conveniente un chip specializzato. È la stessa pressione competitiva che emerge nella sfida tra AMD MI350P e NVIDIA H200: il mercato non cerca più soltanto la GPU più potente, ma il sistema che produce inferenza al costo più basso.
Continua con:
NVIDIA Vera Rubin trasforma il rack nella nuova unità di calcolo AI
USA-Cina, la sfida AI diventa una guerra da trilioni per chip e data center
Maia non elimina NVIDIA: elimina una parte del suo potere contrattuale
È questo il significato industriale più importante di Maia 300. Microsoft continuerà ad acquistare acceleratori NVIDIA e AMD, ma non sarà più costretta a utilizzare hardware di terzi per ogni token prodotto dentro il proprio ecosistema. Copilot, Foundry, GitHub e i futuri agenti Microsoft generano un volume di domanda abbastanza grande da trasformare il chip proprietario in uno strumento di controllo dei costi, dell’energia e della capacità disponibile. La dipendenza non scompare completamente: Maia 300 viene prodotto da TSMC e utilizza HBM4 proveniente da una filiera altamente concentrata in Asia. Cambia però il livello nel quale Microsoft può intervenire direttamente. Redmond decide l’architettura, il dataflow, la rete, il software e l’integrazione con i modelli che eseguirà. NVIDIA resta fondamentale per Azure, ma non è più l’unica risposta possibile quando Microsoft deve decidere quanto costa produrre il prossimo miliardo di token.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.