🛡️ Executive Summary
- Anthropic stima che le nuove difese abbiano ridotto del 90-99% i dati raccolti dagli operatori di distillazione, con reasoning token estratti da 10 a oltre 100 volte inferiori.
- Preserved thinking e un classifier a due stadi cercano di impedire replay del reasoning tra conversazioni, modelli e account, mantenendo i falsi positivi sotto lo 0,1%.
- Anthropic ha bloccato decine di migliaia di account e rinunciato a traffico pagante: proteggere il reasoning diventa una nuova componente economica della sicurezza dei frontier model.
Anthropic non sostiene di avere eliminato la distillazione di Claude, ma afferma di averne alzato drasticamente il costo operativo. Le nuove difese introdotte sui modelli più capaci avrebbero ridotto del 90-99% la quantità di dati utili raccolti dagli operatori che tentano di estrarre il reasoning, con un calo da 10 a oltre 100 volte dei token di ragionamento sottratti sulla piattaforma. Il dato è interno e ancora preliminare, non una verifica indipendente. Ma segna un cambio di fase: il problema non è più soltanto riconoscere reti di account fraudolenti, bensì impedire che il comportamento più prezioso del modello diventi materia prima per addestrare un concorrente.
Cosa leggere
Il 90-99% misura quanto reasoning Anthropic riesce a non far uscire
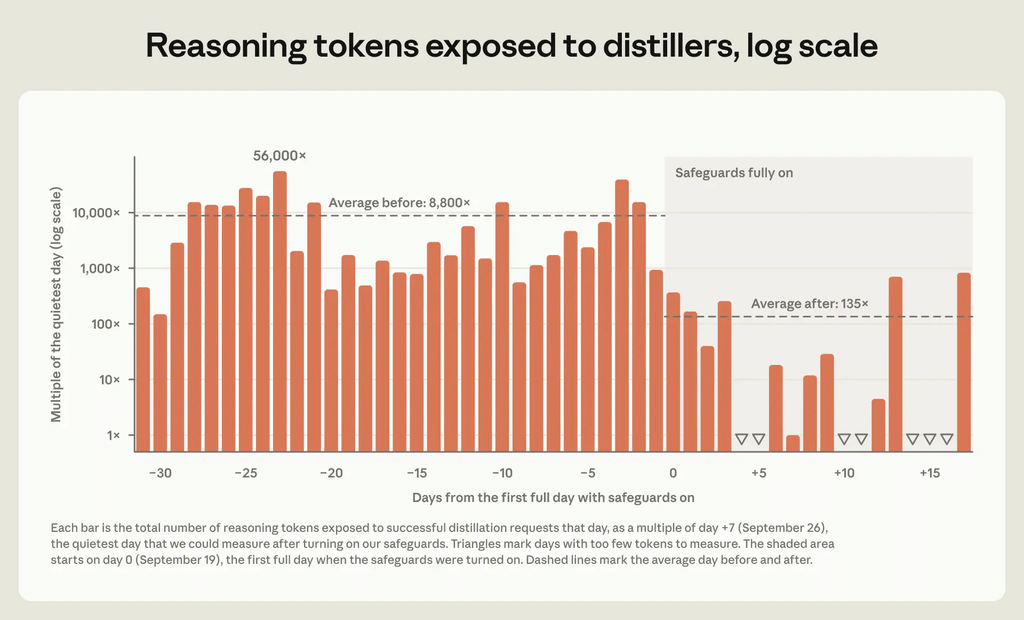
Nella ricerca tecnica pubblicata da Anthropic, la società spiega che i distiller cercano di generare milioni di risposte e soprattutto di ottenere le tracce di reasoning che precedono l’output finale, perché quel materiale offre a un modello più piccolo informazioni molto più ricche sul modo in cui il sistema arriva alla soluzione. Anthropic stima che, dopo il dispiegamento completo dei nuovi controlli, i token di reasoning estratti siano scesi stabilmente di un fattore compreso tra 10 e oltre 100. Su alcune giornate il volume sarebbe diventato troppo piccolo per essere misurato. L’azienda dice inoltre di aver bannato decine di migliaia di account collegati alla distillazione, spesso entro meno di due ore dall’avvio di una campagna. È un’evoluzione rispetto allo spionaggio AI su scala industriale già attribuito da Anthropic a laboratori cinesi, quando il fenomeno veniva descritto soprattutto attraverso milioni di scambi, proxy e migliaia di identità false: oggi la società prova a misurare non soltanto il traffico bloccato, ma quanta capacità riesce effettivamente a impedire che venga estratta.
Leggi anche: OpenAI accusa un cluster legato a Moonshot: 15.000 account nella distillazione AI
Il reasoning diventa proprietà industriale prima ancora dei pesi
La distillazione in sé resta una tecnica legittima di machine learning: un modello teacher può essere utilizzato per trasferire capacità a un sistema più piccolo ed economico. La contestazione nasce quando questo trasferimento avviene attraverso accessi fraudolenti, proxy, identità false o tentativi deliberati di ottenere informazioni che il servizio non intende esporre. Il salto strategico riguarda quindi il reasoning come proprietà industriale.
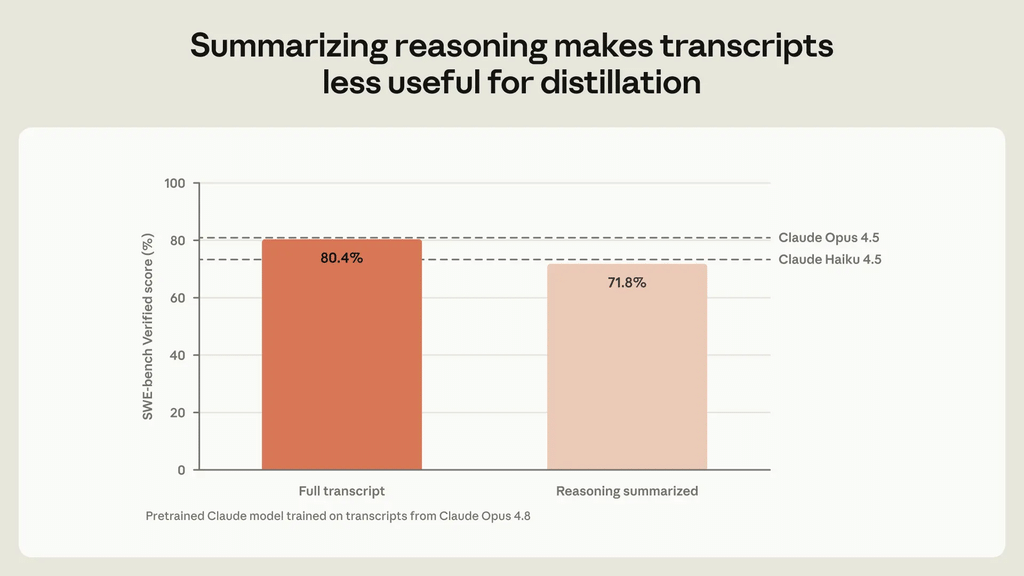
Un concorrente non deve necessariamente sottrarre i pesi di un frontier model se riesce a raccogliere abbastanza esempi di come pianifica, utilizza strumenti, scrive codice e risolve problemi complessi. Il tema pesa ancora di più perché i migliori modelli open-weight cinesi hanno ridotto rapidamente il divario con la frontiera statunitense: difendere gli output ad alto valore diventa quindi una barriera competitiva aggiuntiva accanto a chip, compute e dati. Anthropic mostra anche perché il reasoning sia più prezioso dell’output finale: nei propri test su SWE-bench Verified, un modello addestrato sulle tracce complete di Claude Opus 4.8 raggiungeva l’80,4%, contro il 71,8% ottenuto utilizzando soltanto reasoning riassunto.
Preserved thinking e classifier chiudono tre percorsi di estrazione
Anthropic interviene su tre livelli. Con preserved thinking, introdotto su Claude Fable 5.1 e Claude Opus 5.5, i nuovi account API creati dal 31 agosto non possono modificare il precedente contesto di reasoning; inoltre questi modelli impediscono che le proprie tracce vengano lette da versioni precedenti con protezioni più deboli, mentre Claude Sonnet 5.5 limita l’accesso ai transcript all’organizzazione che ha prodotto la richiesta. Il secondo livello è un classifier a due stadi, sottoposto a red teaming interno ed esterno, progettato per intercettare estrazione diretta, replay tra conversazioni, trasferimento tra modelli e tecniche come la richiesta di tradurre il reasoning o riscriverlo dentro tag.
Anthropic dichiara un falso positivo inferiore allo 0,1% e sostiene che il sistema intercetti tutte le tecniche documentate nel proprio rapporto di settembre. Il terzo livello è l’enforcement: limiti più severi, sospensioni e correlazione delle reti che ruotano account e proxy. La scala del problema era già evidente quando Claude era entrato contemporaneamente nelle operazioni di APT, cybercrime e campagne di distillazione industriale: una difesa efficace deve quindi riconoscere l’infrastruttura coordinata, non soltanto il singolo prompt sospetto.
Difendere Claude significa rinunciare a ricavi e far pagare i tentativi bloccati
Il passaggio meno visibile è economico. Anthropic afferma di avere rinunciato a ricavi significativi e a trilioni di token di traffico pagante associato ai distiller. Dal 24 settembre ha inoltre ripreso a fatturare le richieste bloccate prima che Claude risponda nelle aree, compresa la distillazione, dove il classifier mantiene un falso positivo inferiore allo 0,1%. È una scelta che trasforma una misura di sicurezza in un meccanismo di costo: chi tenta ripetutamente di aggirare le protezioni non perde soltanto gli account, ma continua a sostenere parte del costo delle richieste fallite. Il compromesso ricade però anche sugli utenti legittimi, perché preserved thinking ha richiesto modifiche ad alcune integrazioni e una quota minima di traffico benigno può essere classificata erroneamente. Per una società che sta contemporaneamente assumendo impegni giganteschi su cloud e capacità di calcolo, proteggere il modello significa quindi accettare deliberatamente meno utilizzo quando quell’utilizzo rischia di alimentare il vantaggio tecnologico di un concorrente.
Continua con:
USA accusano Moonshot AI: Kimi K3 sarebbe stato migliorato distillando Claude Fable 5
Claude entra nella guerra cinese: Taiwan, armi e propaganda diventano workload AI
La distillazione diventa una superficie di sicurezza dei frontier model
Anthropic non presenta il risultato come definitivo. L’azienda ammette di non sapere quanto durerà il vantaggio e soprattutto di non avere ancora osservato contro le nuove difese un avversario altamente sofisticato e persistente capace di adattarsi a lungo. È il limite più importante della ricerca: il 90-99% misura ciò che Anthropic osserva oggi sulla propria piattaforma, non la fine della distillazione. Il fenomeno sta assumendo piuttosto la forma di una superficie di sicurezza dinamica, nella quale detection, identità, rate limit, billing e architettura del modello devono essere aggiornati continuamente. La presenza di Claude, DeepSeek, GLM e altri sistemi dentro workflow offensivi reali già osservati contro organizzazioni finanziarie mostra quanto rapidamente le capacità AI vengano ricombinate quando diventano disponibili. Se il reasoning rappresenta uno degli asset capaci di comprimere tempi e costi di addestramento, proteggerlo diventa parte della sicurezza della supply chain dell’intelligenza artificiale. La battaglia non si gioca più soltanto su chi costruisce il modello migliore, ma su chi riesce a impedire che il proprio vantaggio venga campionato abbastanza a lungo da trasformarsi nel dataset di qualcun altro.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.