📌 In Sintesi
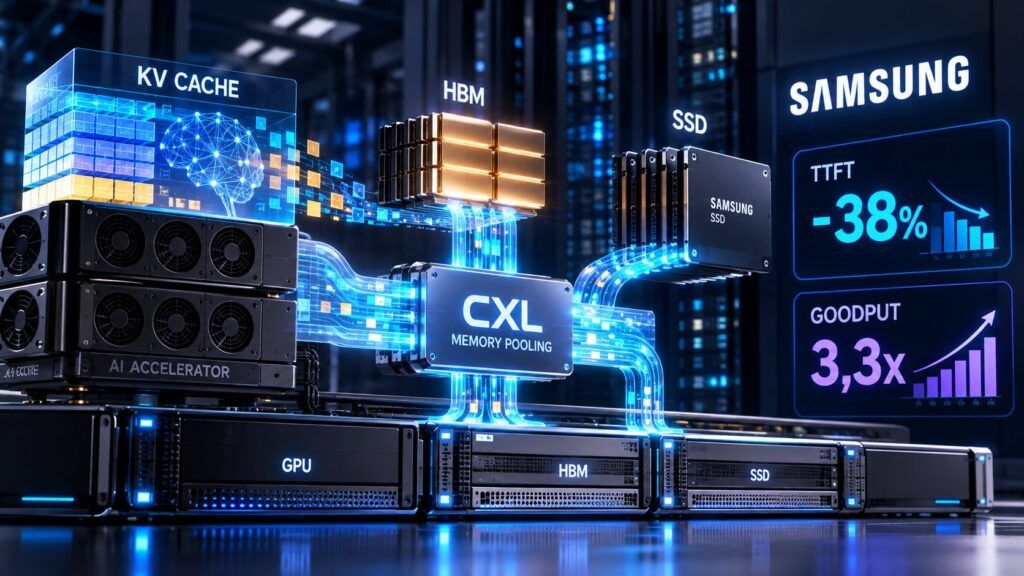
- Samsung mostra al summit OCP un sistema CXL CMM-D che nei propri test riduce fino al 38% il time to first token e aumenta fino a 3,3 volte il goodput.
- Il problema affrontato non è più soltanto la banda HBM: agenti, contesti lunghi e molti utenti fanno esplodere la memoria necessaria alla KV cache.
- Samsung propone una gerarchia nella quale HBM, DRAM, CXL e SSD lavorano come livelli differenti, spostando la competizione AI dalla singola GPU all’intero sistema di memoria.
Samsung prova a spostare la battaglia dell’infrastruttura AI fuori dalla sola HBM e dentro l’intera gerarchia della memoria. All’OCP Global Summit 2026 di San Jose il gruppo coreano mostra una piattaforma CXL destinata a uno dei problemi più concreti dell’inferenza moderna: conservare la KV cache generata da modelli con contesti sempre più lunghi e utilizzati contemporaneamente da molti utenti. Nei test presentati dall’azienda, l’allocazione elastica attraverso CMM-D riduce fino al 38% il time to first token, TTFT, e aumenta fino a 3,3 volte il goodput rispetto a un’allocazione statica. Sono benchmark Samsung e non risultati indipendenti, quindi non possono essere generalizzati a ogni cluster. Ma indicano chiaramente dove si sta spostando il collo di bottiglia: avere GPU sempre più potenti serve poco se memoria e storage non riescono a mantenere abbastanza stato vicino al compute.
Cosa leggere
Gli agenti AI fanno esplodere la memoria prima ancora del numero di FLOPS
La piattaforma ufficiale Samsung dedicata all’OCP Global Summit 2026 organizza la strategia intorno a tre livelli: velocità, espansione della memoria e persistenza. Il motivo è legato al comportamento dell’inferenza. Durante la generazione, i modelli conservano nella KV cache le rappresentazioni già calcolate per evitare di ricomputare continuamente l’intero contesto. Più aumentano lunghezza delle conversazioni, numero di agenti, utenti simultanei e workflow complessi, più questa cache cresce fino a superare facilmente la capacità disponibile vicino alla GPU. È un problema diverso dal semplice training: l’infrastruttura deve mantenere enormi quantità di stato per molte sessioni contemporaneamente. La rilevanza della cache è diventata evidente anche sul fronte della sicurezza quando LMCache ha trasformato il livello usato per condividere KV cache tra server in una superficie capace di esporre il sistema a RCE. L’infrastruttura di inferenza è ormai un sottosistema critico autonomo.
Leggi anche: Samsung spinge HBM4 sui 4 nm e porta la memoria AI dentro le foundry
CMM-D trasforma la RAM in un pool da distribuire tra i workload
La risposta Samsung utilizza Compute Express Link e moduli CMM-D per separare almeno in parte la quantità di memoria disponibile da quella fisicamente installata dentro il singolo server. Attraverso uno switch CXL, capacità aggiuntiva può essere raccolta in un pool e assegnata dinamicamente alle istanze che ne hanno bisogno. Nella dimostrazione dedicata all’agentic AI, Samsung sostiene che l’allocazione elastica produca fino al 38% di riduzione del TTFT e un goodput fino a 3,3 volte superiore rispetto alla configurazione statica. Il goodput misura il lavoro utile effettivamente completato dal sistema e diventa particolarmente importante nei servizi AI multiutente: un cluster può avere molta potenza teorica ma sprecarla se le GPU restano in attesa dei dati o se le richieste vengono rallentate dalla scarsità di memoria. È l’evoluzione di una tecnologia sulla quale Samsung e Red Hat lavoravano già per integrare CXL dentro Linux enterprise, ma ora il caso d’uso è molto più specifico: sostenere inferenza e agenti su larga scala.
CXL non sostituisce HBM perché risolve un collo di bottiglia diverso
Il rischio sarebbe leggere questi risultati come una futura alternativa economica alla HBM. Non funziona così. HBM resta il livello ad altissima banda più vicino all’acceleratore, necessario per alimentare rapidamente GPU e ASIC durante le operazioni più intensive. CXL offre invece capacità espandibile a una distanza maggiore, con prestazioni inferiori ma costi e scalabilità differenti. Samsung continua infatti a sviluppare HBM5, custom HBM e soluzioni PIM parallelamente a CXL. La strategia è costruire diversi tier: i dati più caldi restano vicini al compute, una quantità maggiore di KV cache può scendere nella memoria CXL e ciò che non necessita di latenze DRAM può essere trasferito ulteriormente verso storage persistente. Lo stesso problema aveva già spinto Meta a riutilizzare memoria DDR4 attraverso CXL per contenere il costo dei sistemi AI. La memoria smette quindi di essere un componente monolitico e diventa una risorsa schedulabile.
Gli SSD entrano nella gerarchia perché la KV cache non può restare tutta in DRAM
Samsung porta il ragionamento ancora più in basso, fino allo storage. Una delle sessioni OCP è dedicata esplicitamente al passaggio “from CXL Pooling to SSD-Backed KV Cache Offloading”: quando nemmeno l’espansione DRAM è economicamente sufficiente, una porzione dello stato può essere spostata verso SSD ad alta capacità. Non significa che NAND e DRAM diventino intercambiabili. Latenza, bandwidth e durata sono radicalmente differenti. Il punto è utilizzare ciascun livello per ciò che può fare al costo minore, evitando di comprare capacità HBM estremamente costosa per informazioni che non devono necessariamente restare a pochi millimetri dalla GPU. La produzione di enterprise SSD PCIe 6.0 e lo sviluppo di NAND sempre più densa diventano così parte della stessa economia dell’inferenza, non un mercato storage separato.
Samsung vuole vendere il sistema di memoria e non soltanto il chip più veloce
Questa impostazione chiarisce anche la strategia industriale del gruppo. Samsung compete con SK Hynix e Micron nella HBM, con i produttori NAND negli SSD e contemporaneamente possiede foundry e packaging. Dopo aver riportato HBM e HPC al centro del tentativo di rilancio della propria attività foundry, l’azienda cerca ora di presentarsi come fornitore dell’intera gerarchia necessaria all’AI. La scommessa è che il cliente non debba più ottimizzare separatamente acceleratore, memoria principale, espansione e storage, ma possa progettare i tier insieme in funzione del workload. In un mercato dominato dalla piattaforma Nvidia, questa capacità di integrazione può diventare uno dei pochi strumenti con cui un produttore di memoria conserva potere negoziale.
Continua con:
Samsung porta HBM4 sui 4 nm e integra memoria e foundry
NVIDIA ridimensiona Rubin Ultra, Meta riutilizza la DDR4 attraverso CXL
Il nuovo collo di bottiglia dell’AI è decidere dove tenere ogni token
I numeri Samsung devono essere letti per quello che sono: test interni su configurazioni e workload specifici, non la dimostrazione che installare CXL renda automaticamente ogni sistema AI 3,3 volte più veloce. Il significato industriale è però più interessante del benchmark. L’inferenza su larga scala sta trasformando lo stato generato dai modelli in una risorsa che deve essere collocata continuamente nel livello di memoria più conveniente. HBM offre banda estrema, DRAM capacità locale, CXL espansione e pooling, SSD persistenza economica. La prossima battaglia dei data center non sarà quindi soltanto stabilire quale GPU produca più token al secondo. Sarà decidere dove conservare miliardi di token di contesto senza lasciare acceleratori da decine di migliaia di euro in attesa della memoria. Ed è proprio in questo spazio che Samsung prova a trasformare la propria ampiezza industriale in un vantaggio contro chi vende soltanto uno dei livelli della catena.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.