📌 In Sintesi
- Muse Spark Open usa un’architettura Mixture-of-Experts da 816 miliardi di parametri, con 42 miliardi attivi per token e contesto da un milione di token.
- Apple esegue il modello quantizzato attraverso più Mac Studio M5 Ultra collegati via Thunderbolt 5 e RDMA, raggiungendo oltre 36 token al secondo su quattro macchine.
- AWS distribuisce contemporaneamente lo stesso modello attraverso SageMaker JumpStart, mostrando una strategia che porta gli agenti Meta dal desktop privato all’infrastruttura cloud enterprise.
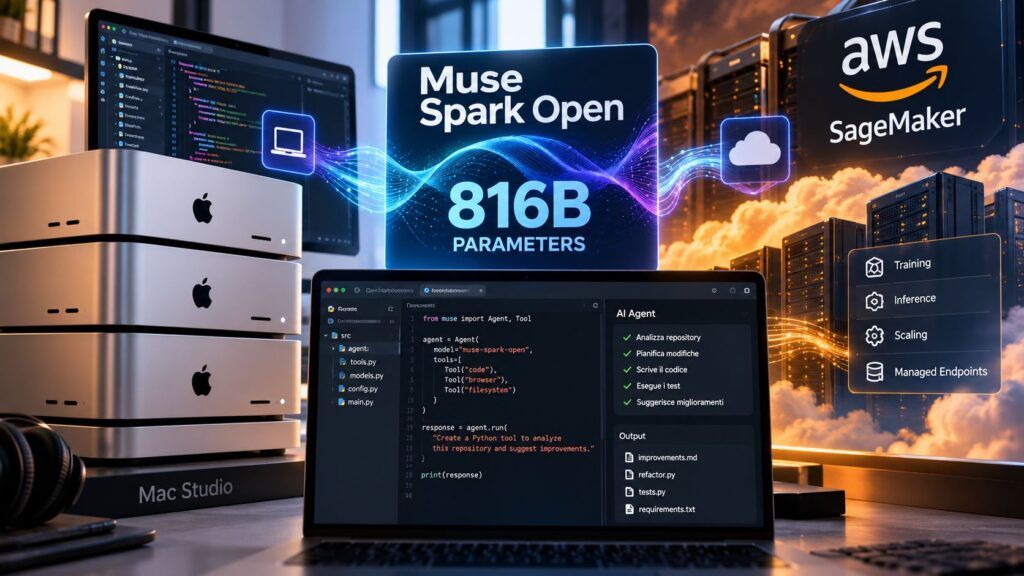
Meta Muse Spark Open rende molto più concreto il confine tra intelligenza artificiale locale e cloud. Il nuovo modello open-weight dispone di 816 miliardi di parametri complessivi, ne attiva 42 miliardi per token e offre una finestra di contesto da un milione di token pensata soprattutto per coding, debugging e agenti capaci di lavorare a lungo su repository complessi. La parte più interessante non è però la dimensione. Apple ha ottimizzato MLX per eseguirlo attraverso più Mac Studio M5 Ultra collegati direttamente tra loro, mentre AWS lo rende disponibile nello stesso momento attraverso SageMaker JumpStart. Il modello resta lo stesso, cambia completamente l’infrastruttura che lo circonda.
Cosa leggere
Muse Spark Open spinge Meta da Glimmer a un modello da 816 miliardi
Muse Spark Open è molto diverso da Muse Glimmer, il modello da circa 30 miliardi di parametri già progettato per funzionare su una singola workstation. La distinzione è importante perché Muse Glimmer era già entrato nella strategia Meta per gli agenti locali, mentre Spark Open alza drasticamente la scala: architettura Mixture-of-Experts, 816B parametri totali, 42B attivi e capacità multimodali su testo, immagini, documenti, audio e video. Il modello è ottimizzato per attività agentiche lunghe, nelle quali deve pianificare, utilizzare strumenti, osservare l’esito e correggere il percorso. Non si limita quindi alla generazione di codice: può lavorare su repository completi, effettuare refactoring multi-file e mantenere abbastanza contesto da comprendere dipendenze e componenti legacy.
Leggi anche: Meta Muse diventa agente operativo e WhatsApp apre a cinque AI esterne
Un singolo Mac Studio da 512 GB non basta ancora
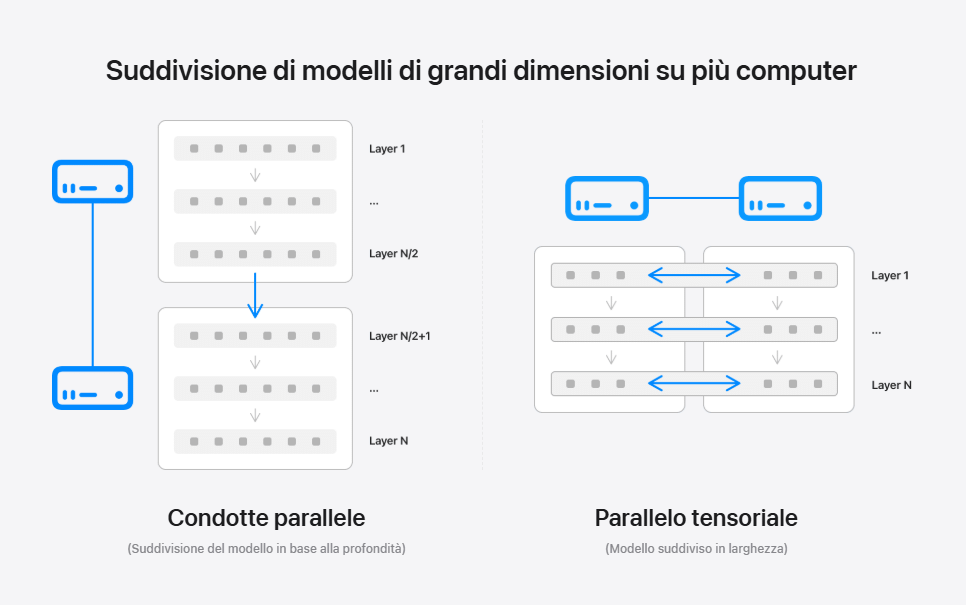
Apple utilizza Muse Spark Open anche per dimostrare quanto può essere spinta la propria architettura di memoria unificata. In formato BF16 i soli parametri richiederebbero oltre 1,6 TB di memoria. La quantizzazione NVFP4 riduce il footprint a circa 493 GB, ma un singolo Mac Studio da 512 GB resta insufficiente perché l’inferenza necessita anche di memoria per calcoli intermedi e cache. Nella ricerca tecnica pubblicata da Apple su MLX e inferenza distribuita il modello viene quindi suddiviso tra più Mac Studio M5 Ultra utilizzando pipeline o tensor parallelism e comunicazione RDMA attraverso Thunderbolt 5.
È precisamente il caso d’uso che Apple aveva preparato quando Mac Studio M5 Ultra è salito fino a 512 GB di memoria unificata e 1,2 TB/s di banda. La novità è che ora esiste un modello da quasi un trilione di parametri capace di utilizzare concretamente quella struttura distribuita.
Quattro Mac Studio superano 36 token al secondo
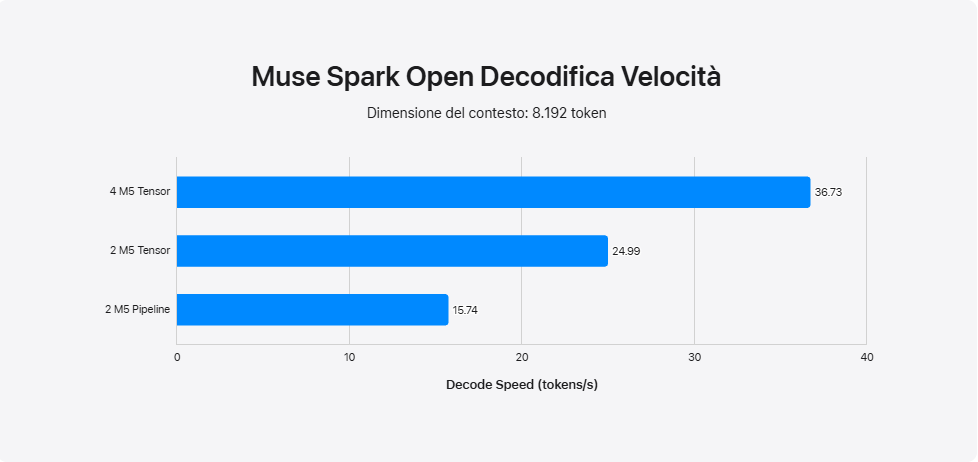
I benchmark Apple mostrano anche dove si trova il limite reale. Con contesto da 8.192 token, due M5 Ultra in pipeline raggiungono circa 15,7 token al secondo; due macchine con tensor parallelism salgono a circa 25 token al secondo, mentre quattro Mac Studio arrivano a 36,7 token al secondo. Non sono prestazioni paragonabili automaticamente a un cluster Nvidia enterprise e i risultati derivano da test Apple, ma dimostrano che una workstation composta da pochi desktop può eseguire localmente un modello che fino a poco tempo fa sarebbe stato associato esclusivamente a infrastrutture server.
La questione centrale torna a essere la memoria. I benchmark di Qwen 3.8 su RTX 5090 e sistemi con grandi pool di RAM avevano già mostrato che il collo di bottiglia dell’AI locale non coincide sempre con la capacità di calcolo della GPU. Muse Spark Open porta il problema all’estremo: prima di generare rapidamente i token bisogna riuscire a tenere in memoria il modello.
AWS prende gli stessi pesi e li trasforma in endpoint enterprise
Contemporaneamente Amazon porta Muse Spark Open in SageMaker JumpStart nelle varianti BF16 e NVFP4. La documentazione ufficiale AWS dedicata al deployment di Muse Spark Open utilizza istanze ml.p6-b300.48xlarge per BF16 e ml.p5e.48xlarge per NVFP4. Il modello viene eseguito dentro l’account AWS del cliente e può essere isolato in una VPC, utilizzare storage cifrato con KMS e mantenere una versione specifica dei pesi senza aggiornamenti automatici.
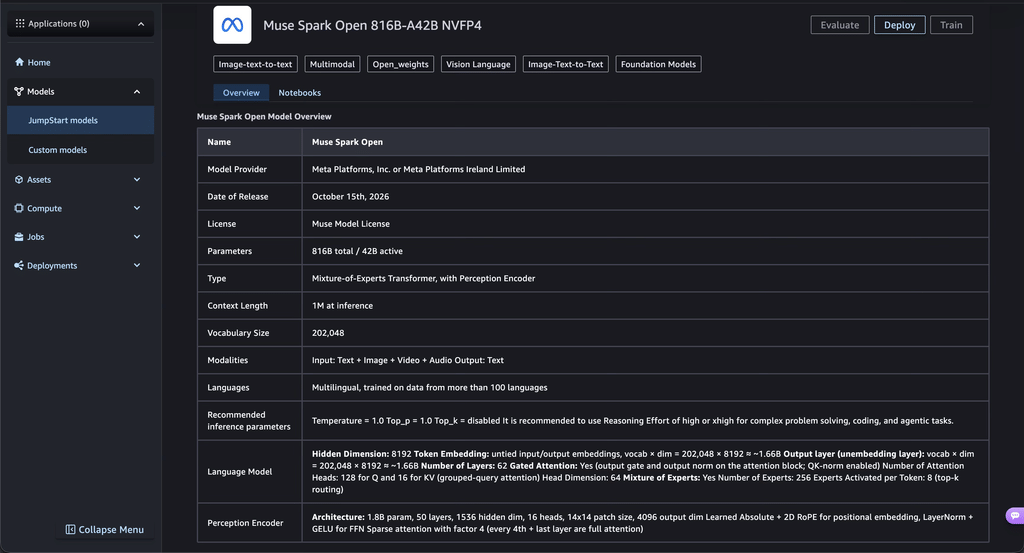
È quasi l’opposto operativo del cluster Mac Studio: nel primo caso l’impresa compra hardware, mantiene inferenza e dati fisicamente sotto il proprio controllo e accetta limiti di scala; nel secondo trasforma il modello in un endpoint che può essere allocato e dimensionato secondo necessità. Entrambe le configurazioni mantengono però la caratteristica strategica degli open weights: il cliente non è obbligato a inviare codice e prompt verso l’API gestita direttamente da Meta.
Continua con:
Apple lancia M6 e M5 Ultra e trasforma Mac mini e Mac Studio in macchine AI
AMD spinge i PC agentici a 192 GB e porta la sfida direttamente a Nvidia
Meta può distribuire lo stesso agente dal tavolo del developer al data center
Muse Spark Open rende quindi meno netta la separazione tra AI locale e AI cloud. Lo sviluppatore può utilizzare MLX e un piccolo cluster di Mac Studio per mantenere modello, repository e inferenza dentro il proprio ambiente; la stessa organizzazione può successivamente spostare i pesi su SageMaker quando servono concorrenza, disponibilità continua o maggiore capacità infrastrutturale. Non è necessario cambiare modello per cambiare scala. È questo il vero valore strategico del lancio. Meta aveva già mostrato con Muse e Glimmer la volontà di costruire agenti che passano dal modello locale alle azioni persistenti sui servizi digitali. Spark Open aggiunge ora il livello infrastrutturale. Lo stesso cervello agentico può essere eseguito sulla scrivania, dentro un cluster privato oppure dietro un endpoint cloud. La competizione sull’AI open non riguarda più soltanto chi pubblica i pesi migliori: riguarda quanto facilmente quei pesi possono attraversare hardware, framework e data center senza costringere l’utente a ricostruire ogni volta l’intero sistema.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.