📌 In Sintesi
- Nemotron 3.5 Super VL usa 120 miliardi di parametri ma ne attiva 12 miliardi per token, combinando testo, immagini, documenti, video e tool use.
- Nemotron 3.5 Bolt porta la stessa strategia verso l’edge: la variante 74B-A9B occupa 24 GB ed è progettata per workstation e PC RTX.
- NVIDIA non sta soltanto pubblicando nuovi modelli open: sta costruendo una catena che collega modello, NIM, Dynamo, NeMo e hardware locale fino al data center.
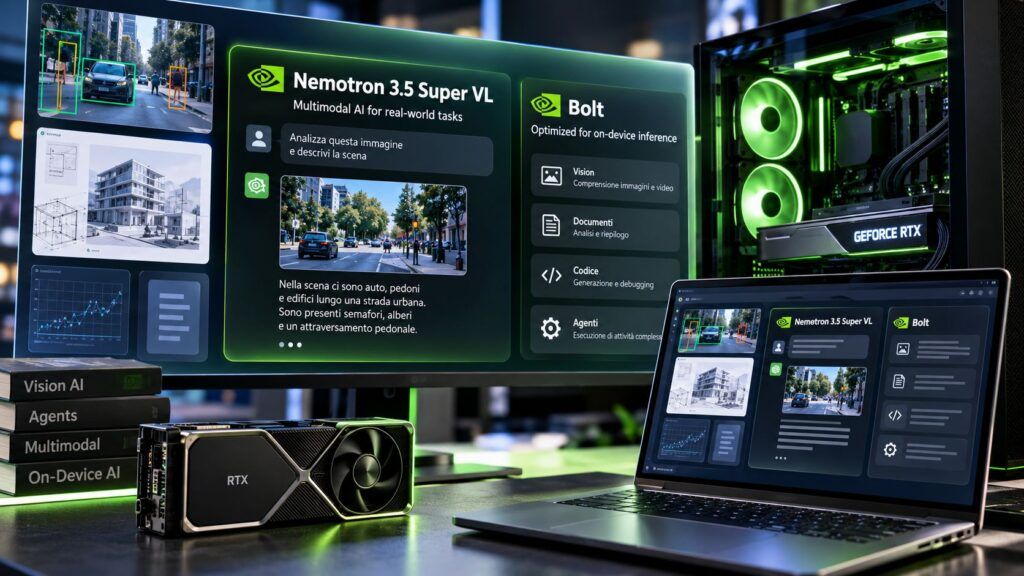
NVIDIA sta cercando di portare gli agenti AI fuori dal modello esclusivamente cloud senza rinunciare al controllo sullo stack che li esegue. Nemotron 3.5 arriva con una famiglia che copre data center, workstation e PC locali: Super VL combina reasoning multimodale e tool use in un Mixture-of-Experts da 120 miliardi di parametri, mentre Bolt riduce memoria e requisiti per portare workload agentici sulle nuove piattaforme RTX Spark e sui normali sistemi GeForce RTX. Il punto industriale non è quindi soltanto un nuovo benchmark. NVIDIA prova a trasformare Nemotron nel livello software comune tra GPU, runtime, agenti e deployment locale, estendendo verso il modello ciò che CUDA ha rappresentato per il calcolo accelerato.
Cosa leggere
Nemotron 3.5 Super VL attiva solo 12 miliardi di parametri per token
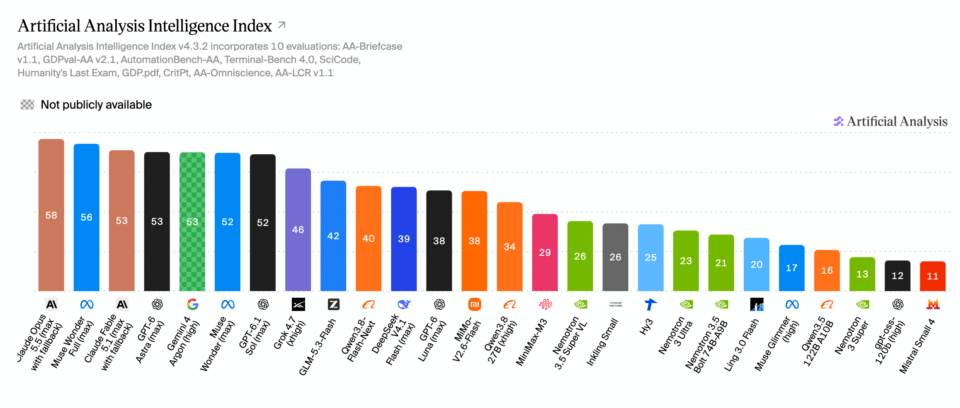
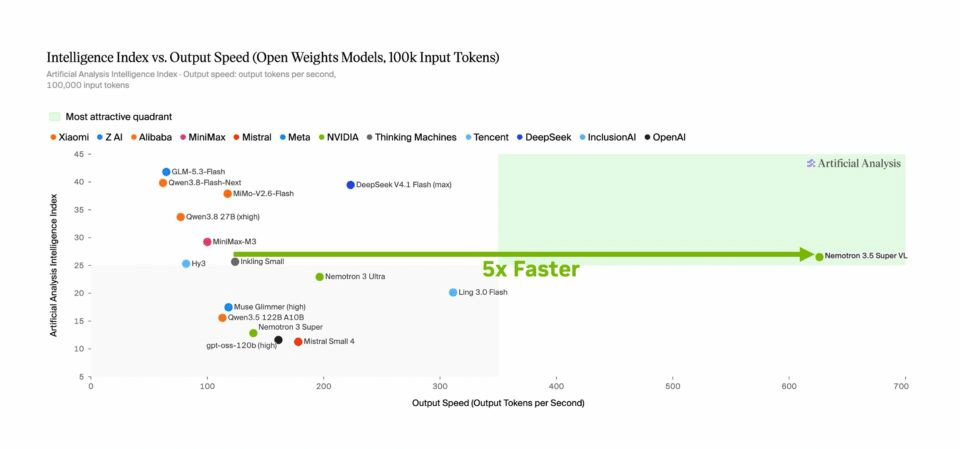
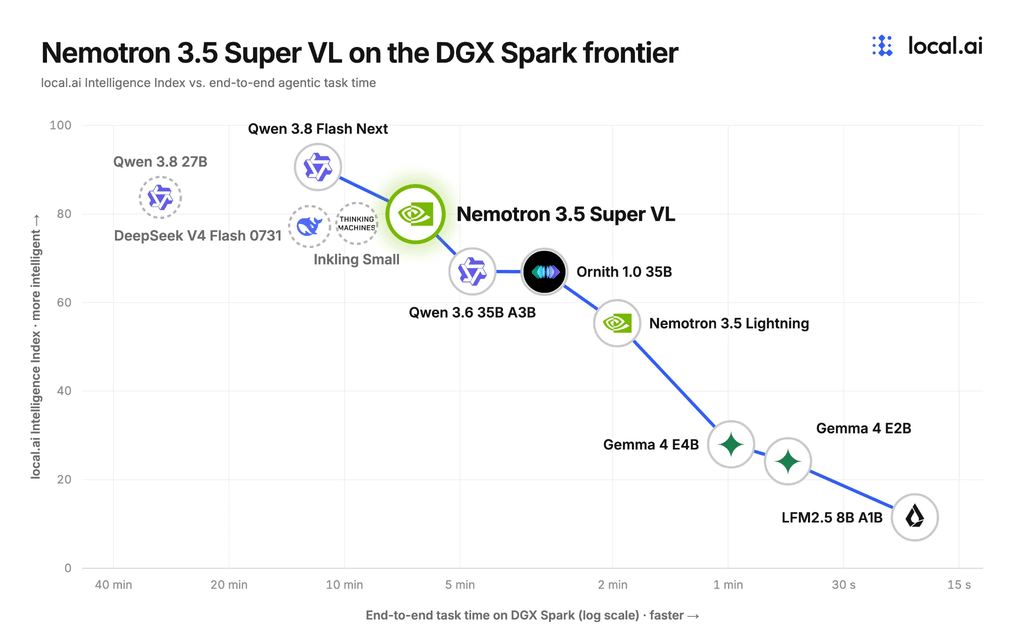
Il modello principale è Nemotron 3.5 Super VL, architettura multimodale Mixture-of-Experts da 120 miliardi di parametri che ne attiva circa 12 miliardi per ciascun token. La scelta permette a NVIDIA di mantenere una capacità complessiva elevata senza sostenere a ogni inferenza il costo computazionale dell’intero modello. Super VL combina reasoning, instruction following, uso degli strumenti e comprensione di testo, immagini, documenti e video, eliminando in diversi workflow la necessità di affiancare un LLM a un modello visuale separato. Nel lancio ufficiale della famiglia Nemotron 3.5 NVIDIA dichiara throughput fino a cinque volte superiore rispetto ad altri modelli open della stessa fascia su singola GPU: un dato del produttore che dovrà essere verificato con benchmark indipendenti, ma che chiarisce dove si concentra l’ottimizzazione.
Questa attenzione all’efficienza completa il percorso con cui NVIDIA aveva già inserito Nemotron dentro il proprio full stack tra Omniverse, RTX e infrastruttura AI. Il modello non viene quindi pensato come servizio isolato, ma come componente eseguibile e modificabile lungo tutto l’ecosistema NVIDIA.
Leggi anche: NVIDIA porta gli agenti AI dentro Omniverse per costruire simulazioni fisiche
Multimodalità e tool use servono agli agenti che lavorano per ore
La differenza rispetto al chatbot tradizionale sta soprattutto nel tipo di workload previsto. Un agente enterprise può dover leggere un PDF, interpretare un grafico, consultare più sorgenti, eseguire codice, chiamare strumenti esterni e verificare il risultato prima di continuare. La documentazione tecnica di Nemotron 3.5 Super VL concentra proprio il modello sui cosiddetti always-on agents, dove velocità del singolo token conta meno della capacità di terminare correttamente sequenze lunghe di operazioni.
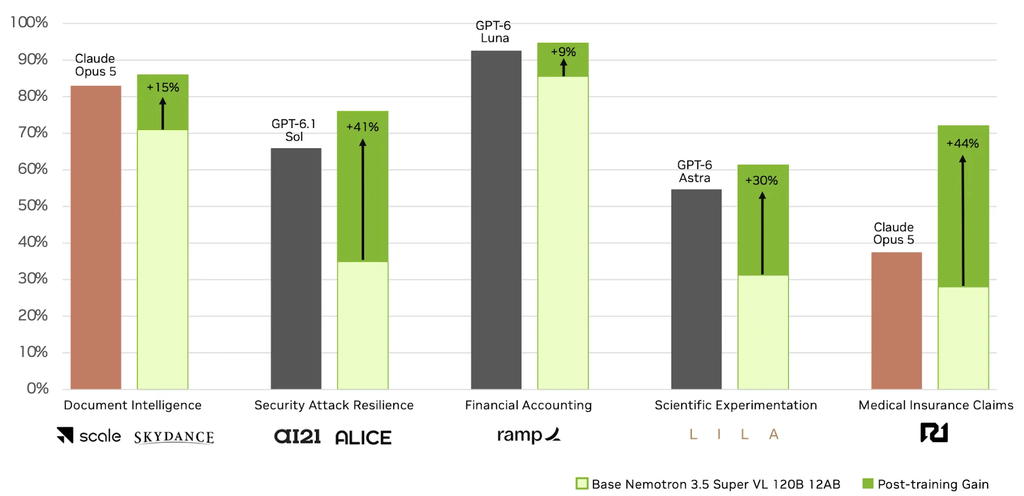
NVIDIA cita aziende come Scale AI, Ramp e AI21 che hanno post-addestrato Super VL per workload verticali, riportando riduzioni di costo e latenza e incrementi di accuratezza. Anche questi risultati derivano da casi selezionati dal vendor e non vanno trasformati in prestazioni universali. La direzione però coincide con quanto già emerso quando gli agenti AI hanno iniziato a spostarsi dal semplice coding verso simulazione, ricerca e workflow operativi: il valore si misura sempre meno sulla risposta singola e sempre più sul lavoro completato.
Bolt porta Nemotron dentro 24 GB e prepara l’AI locale
La seconda metà della strategia è Nemotron 3.5 Bolt. La variante 74B-A9B utilizza 74 miliardi di parametri complessivi con circa 9 miliardi attivi e viene distribuita in una configurazione da 24 GB, sufficiente per entrare nel territorio delle workstation compatte e dei sistemi RTX di fascia alta. NVIDIA indica compatibilità con llama.cpp, Ollama, LM Studio, Unsloth e vLLM, segnale importante perché il modello non viene confinato a un runtime proprietario.
È qui che Nemotron incontra direttamente la nuova guerra sull’agentic PC. AMD sta rispondendo con Gorgon Halo e fino a 192 GB di memoria unificata, mentre NVIDIA vuole usare Bolt per dimostrare che una parte crescente dei workflow può rimanere sulle proprie GPU locali. Il vantaggio non è soltanto privacy: evitare continui round trip verso il cloud significa anche ridurre latenza e costo API e permettere a un agente di mantenere modelli e contesto residenti sulla macchina.
RTX Spark diventa il banco di prova della nuova categoria
Bolt 74B-A9B arriva insieme ai primi notebook RTX Spark, ma NVIDIA lo indica anche per sistemi GeForce RTX, DGX Spark, DGX Station e workstation RTX PRO. La strategia rafforza una categoria che NVIDIA aveva già aperto portando DGX Spark verso configurazioni desktop dedicate all’AI locale. Il problema principale resta la memoria: gli agenti persistenti devono mantenere modello, KV cache, contesto, embeddings e strumenti contemporaneamente, quindi la quantità di RAM o VRAM disponibile pesa quasi quanto la potenza aritmetica.
Bolt E4B spinge ancora più in basso questa logica con un footprint dichiarato di circa 4 GB, rivolgendosi ad agenti conversazionali più leggeri. La famiglia Nemotron diventa così una scala: Super VL per workload multimodali complessi, Bolt 74B per AI locale più potente e Bolt E4B per applicazioni dove conta soprattutto l’efficienza per gigabyte.
Il vantaggio NVIDIA è collegare modello e infrastruttura
Il vero differenziale competitivo non è però nei soli pesi open. Nemotron 3.5 può essere distribuito attraverso NVIDIA NIM, personalizzato con NeMo e servito attraverso Dynamo. NVIDIA dichiara che Dynamo può aumentare fino a otto volte il numero di utenti serviti con una riduzione dell’85% della latenza in determinate configurazioni. Ancora una volta sono risultati del produttore, ma mostrano una strategia precisa: ottimizzare contemporaneamente modello, scheduler, runtime e GPU. È la stessa logica che ha portato Nemotron e NIM dentro pipeline documentali enterprise e sistemi RAG. Pubblicare i pesi permette a NVIDIA di partecipare all’ecosistema open; fornire l’intera infrastruttura necessaria per eseguirli permette invece di continuare a monetizzare hardware e software attorno a quei pesi.
Continua con:
NVIDIA crea Open Secure AI Alliance per proteggere gli agenti
NVIDIA porta Agentic AI e Jetson dentro robot e fabbriche autonome
Nemotron 3.5 trasforma l’open model in una leva per vendere tutto lo stack
Nemotron 3.5 mostra un paradosso soltanto apparente. NVIDIA rende aperti e personalizzabili i modelli proprio mentre cerca di stringere l’integrazione attorno alla loro esecuzione. Super VL può essere scaricato, Bolt può girare attraverso runtime diffusi e i pesi non obbligano formalmente un’azienda a rimanere nel perimetro NVIDIA. Ma le prestazioni migliori vengono costruite intorno a GPU RTX, DGX, NIM, NeMo e Dynamo. È una strategia più sofisticata della semplice vendita di acceleratori. Se gli agenti diventano processi continui distribuiti dal laptop al data center, NVIDIA vuole presidiare il modello, il runtime e la macchina sulla quale quell’agente vive. Nemotron 3.5 serve precisamente a questo: rendere credibile lo stesso stack sia quando l’AI lavora su un rack enterprise sia quando gira su una workstation sotto la scrivania.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.