📌 In Sintesi
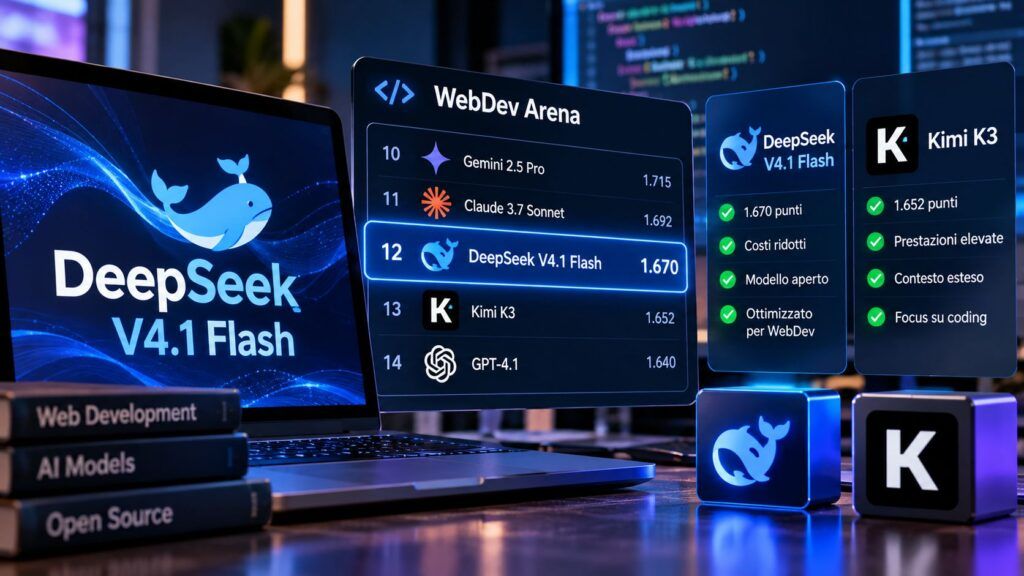
- DeepSeek V4.1 Flash raggiunge il dodicesimo posto nella WebDev Arena con 1.670 punti, diventando il modello con licenza aperta meglio classificato nella graduatoria complessiva.
- Il modello supera in classifica Kimi K3 di Moonshot AI, proponendo prezzi indicativi di 0,30 dollari per milione di token in ingresso e 1,20 dollari in uscita.
- Il primato riguarda lo sviluppo web valutato dagli utenti di Arena, non tutte le attività di programmazione. Numero di voti e margini statistici richiedono prudenza.
DeepSeek torna a guadagnare terreno nella competizione internazionale sui modelli di intelligenza artificiale destinati alla programmazione. La versione DeepSeek V4.1 Flash identificata dal suffisso 20261017 ha raggiunto il dodicesimo posto nella WebDev Arena, con un punteggio di 1.670, collocandosi davanti a Kimi K3 e risultando il modello classificato con licenza aperta più in alto nella graduatoria complessiva consultata il 19 ottobre 2026. Il risultato è significativo soprattutto per il rapporto tra prestazioni e costi: DeepSeek propone un modello con finestra di contesto da un milione di token e tariffe API nettamente inferiori a quelle dei principali concorrenti proprietari. Non è però una dimostrazione di superiorità assoluta nel coding, perché la classifica riguarda specificamente la realizzazione di applicazioni e interfacce web attraverso valutazioni comparative degli utenti.
Cosa leggere
DeepSeek V4.1 Flash raggiunge 1.670 punti e sorpassa Kimi K3
La classifica originale WebDev Arena colloca DeepSeek-V4.1-Flash-20261017 (Max) al dodicesimo posto generale, con 1.670 punti e un intervallo indicato di ±17 punti, su 1.417 valutazioni. Davanti al modello cinese figurano sistemi proprietari di Anthropic, OpenAI, Google e Alibaba, mentre Kimi K3 (Max) di Moonshot AI scende al quindicesimo posto nella fotografia considerata, con 1.655 punti e un margine più contenuto, pari a circa ±6 punti. La nuova posizione rappresenta un’evoluzione rispetto al debutto di DeepSeek V4.1 Flash e alla prima competizione con Kimi K3, quando il modello veniva presentato soprattutto attraverso le caratteristiche della sua architettura Mixture-of-Experts e i risultati dichiarati nei test di coding e attività agentiche.
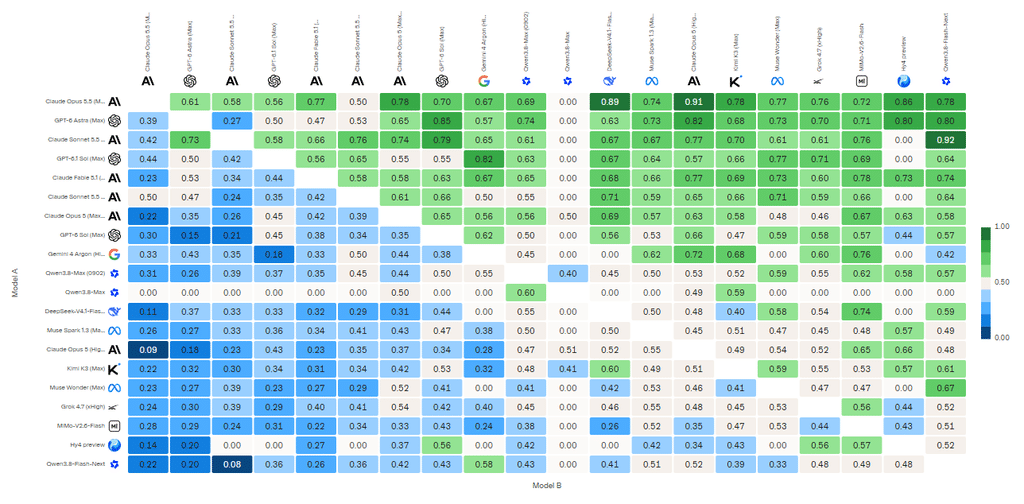
Ora emerge una valutazione condotta su una piattaforma indipendente dal produttore, basata sulle preferenze espresse durante il confronto tra risultati generati dai modelli. Il sorpasso non cancella tuttavia l’incertezza statistica: i quindici punti che separano DeepSeek e Kimi K3 sono inferiori alla somma dei margini indicati per le due stime, quindi non consentono di concludere che DeepSeek sia necessariamente superiore in tutte le prove equivalenti. Il risultato certifica una posizione favorevole nella classifica osservata, non una distanza prestazionale definitiva.
Leggi anche: Kimi K3 conquista la Frontend Code Arena e sfida Claude Fable 5 nel coding
Il vantaggio economico di DeepSeek è nei costi dell’inferenza
La componente più interessante per sviluppatori e imprese riguarda il prezzo indicativo delle API riportato da Arena. DeepSeek V4.1 Flash costa 0,30 dollari per milione di token in ingresso e 1,20 dollari per milione di token generati, equivalenti rispettivamente a circa 0,27 e 1,07 euro al cambio indicativo del 19 ottobre. Kimi K3 presenta invece valori di 3 e 15 dollari, circa 2,67 e 13,37 euro, rendendo DeepSeek dieci volte meno costoso nell’input e dodici volte e mezzo nell’output, secondo i prezzi comparati nella classifica. Questi importi rappresentano tariffe unitarie e non il costo finale di un’attività completata: un agente può richiedere molte chiamate, utilizzare strumenti esterni, ripetere generazioni oppure consumare quantità differenti di token per raggiungere lo stesso risultato. È una distinzione già emersa con l’arrivo di Kimi K3 su Amazon Bedrock e la competizione sull’efficienza infrastrutturale, perché il prezzo nominale del modello non esaurisce il costo operativo dell’applicazione. DeepSeek viene inoltre classificato da Arena con licenza MIT, mentre Kimi K3 utilizza una licenza propria: una differenza rilevante per le imprese che valutano distribuzioni autonome e personalizzazioni, fermo restando che licenza, disponibilità dei pesi e reale possibilità di esecuzione locale devono essere controllate separatamente.
La WebDev Arena misura preferenze degli utenti e non l’affidabilità generale del codice
Il risultato deve essere interpretato attraverso la metodologia della piattaforma. La WebDev Arena confronta modelli impegnati nella costruzione di interfacce e applicazioni web, includendo attività che richiedono ragionamento articolato e utilizzo di strumenti. Le preferenze espresse dagli utenti alimentano una graduatoria dinamica, che cambia con l’arrivo di nuovi modelli e con l’aumento delle valutazioni disponibili. Un punteggio elevato non dimostra automaticamente che il codice sia più sicuro, più semplice da mantenere o privo di errori logici. Il modello può produrre un’interfaccia visivamente convincente senza gestire correttamente autenticazione, autorizzazioni, trattamento dei dati o casi limite. La distinzione richiama quanto emerso nel confronto tra i risultati di Gemini 4 nei benchmark e le prestazioni riscontrate nelle attività di coding, dove la capacità di ottenere punteggi elevati non coincide necessariamente con l’affidabilità operativa nelle condizioni reali. Nel caso DeepSeek pesa anche la differenza nel numero delle valutazioni: 1.417 voti per la nuova versione contro oltre 19.000 per Kimi K3 nella fotografia più recente. Il campione ridotto rende il posizionamento del modello appena introdotto più esposto a variazioni. Per valutare l’utilizzo in produzione servono quindi test su repository reali, capacità di modificare codice esistente, correttezza dei test automatici, consumi effettivi e gestione dei problemi di sicurezza.
I modelli aperti cinesi comprimono il divario con i sistemi proprietari
Il dodicesimo posto assoluto è significativo soprattutto perché DeepSeek si colloca in una graduatoria dominata nelle prime posizioni dai laboratori statunitensi. Il modello non supera Claude Opus 5.5 o le configurazioni migliori della famiglia GPT-6, ma raggiunge una fascia competitiva con costi sensibilmente inferiori, rafforzando la strategia industriale cinese basata sulla disponibilità dei modelli e sull’efficienza dell’inferenza. Il fenomeno era già stato evidenziato nell’analisi sul divario tecnologico tra modelli aperti cinesi e sistemi proprietari occidentali, nella quale emergeva come il ritardo degli open-weight non potesse essere considerato uniforme tra coding, ragionamento e attività agentiche. Il risultato di DeepSeek aggiunge un aggiornamento concreto a quella dinamica, senza dimostrare che il vantaggio americano sia stato annullato. La competizione si sposta progressivamente dal solo primato nei benchmark alla possibilità di eseguire workload professionali con un costo sostenibile e un livello adeguato di controllo sull’infrastruttura. Questo non rende automaticamente ogni modello aperto adatto a contesti aziendali sensibili: qualità del codice, protezione della proprietà intellettuale, trattamento dei dati e capacità di audit restano criteri indipendenti dal prezzo e dalla posizione in classifica. Il beneficio economico esiste soltanto quando il modello può essere integrato senza trasferire altrove costi e rischi non considerati nella semplice tariffa per token.
Continua con:
Reflection AI presenta Beam: sfida alla Cina sui modelli open-weight
DeepSeek V4, la compressione KV crea punti ciechi fino a 40 punti
Per gli sviluppatori italiani conta il rapporto tra prestazioni, costo e controllo
Il nuovo posizionamento di DeepSeek V4.1 Flash offre un elemento concreto alle software house, alle startup e alle imprese italiane che stanno valutando l’integrazione di modelli generativi nei processi di sviluppo. La possibilità di utilizzare un modello competitivo a costi ridotti può abbassare la barriera economica per prototipazione, creazione di interfacce e automazione di attività ripetitive, soprattutto quando le applicazioni richiedono volumi elevati di inferenza. L’effetto non deve però essere confuso con un risparmio garantito, perché un modello economico che necessita di più tentativi, produce codice vulnerabile o richiede una revisione umana maggiore può risultare complessivamente meno conveniente di un’alternativa più costosa. Allo stesso modo, la licenza aperta può rappresentare un vantaggio per il controllo tecnologico soltanto se l’organizzazione dispone delle risorse necessarie a gestire pesi, infrastruttura e aggiornamenti. Il risultato nella WebDev Arena conferma dunque la crescente competitività economica e tecnica dei modelli cinesi nel coding, ma non stabilisce quale sistema sia migliore per ogni progetto. Per DeepSeek il salto più importante non consiste nell’aver conquistato una posizione assoluta ai vertici, bensì nell’aver raggiunto una fascia prestazionale significativa mantenendo tariffe estremamente aggressive. La partita dell’AI applicata al software si giocherà sempre meno sul singolo punto in classifica e sempre più sul costo necessario per ottenere codice funzionante, verificabile e mantenibile.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.