📌 In Sintesi
- Google presenta Agent Compute Engine, un’infrastruttura che assegna a ogni agente AI una microVM isolata, dotata di identità verificabile e priva di credenziali permanenti. Il servizio entrerà in anteprima nei prossimi mesi.
- Google e Meta confermano che SGLang-TorchTPU è già utilizzato in produzione da Meta. Non è invece confermata l’installazione dei processori Google nei data center di proprietà del gruppo.
- L’integrazione nativa con PyTorch, vLLM e SGLang rende i TPU più accessibili agli sviluppatori e rafforza la concorrenza con Nvidia, senza dimostrare che le GPU siano ormai sostituibili in ogni carico AI.
Google sfida Nvidia su due fronti dell’infrastruttura AI: i processori utilizzati per eseguire i modelli e i computer virtuali necessari agli agenti autonomi. Il 22 ottobre 2026 Google Cloud ha presentato Agent Compute Engine, un servizio che assegna a ogni agente una macchina virtuale isolata, e contemporaneamente ha confermato un risultato industriale significativo: Meta utilizza già in produzione SGLang-TorchTPU, il nuovo motore che consente di eseguire modelli PyTorch sui processori AI di Google. Le due iniziative rispondono a problemi differenti ma convergenti: ridurre la dipendenza dalle GPU Nvidia, contenere il costo dell’inferenza e rendere sicure le operazioni eseguite da milioni di agenti con accesso ad applicazioni e dati aziendali.
Cosa leggere
Google Agent Compute Engine assegna una microVM isolata a ogni agente AI
Agent Compute Engine nasce dall’esperienza accumulata da Google nell’esecuzione degli agenti Gemini, che richiedono ambienti persistenti per scrivere codice, utilizzare browser, consultare documenti e interagire con servizi esterni. I normali container permettono di avviare rapidamente applicazioni, ma condividono il kernel del sistema operativo ospitante; le macchine virtuali tradizionali offrono un isolamento più robusto, a costo di tempi di avvio e consumi superiori. Google propone quindi una soluzione intermedia fondata su microVM isolate mediante Cloud Hypervisor, nelle quali l’agente può disporre di un proprio ambiente Linux, di strumenti di sviluppo e di privilegi amministrativi senza condividere direttamente il sistema operativo con altri agenti. La piattaforma utilizza Titanium, l’infrastruttura hardware di Google dedicata anche alla gestione di rete, storage e protezione delle operazioni, mentre la memoria può essere condivisa fra istanze soltanto per le componenti immutabili, attraverso tecniche copy-on-write. Quando un agente termina una fase operativa e attende una risposta dal modello o dall’utente, la macchina può essere sospesa attraverso checkpoint e ripristinata successivamente, conservando il proprio stato. Lo spazio di lavoro persistente viene mantenuto su Hyperdisk, evitando di ricostruire l’ambiente dopo ogni richiesta. Nel comunicato ufficiale di Google Cloud, l’azienda precisa che il sistema alimenta già applicazioni interne, compresi gli agenti Gemini, ma che la disponibilità per i clienti esterni è prevista in anteprima nei prossimi mesi. Non è stato ancora pubblicato un listino commerciale né una data di disponibilità generale. La novità estende il modello già introdotto quando Google aveva trasformato Gemini in un collega digitale con identità e sub-agenti, spostando l’attenzione dall’assistente visibile all’utente all’infrastruttura che ne rende possibile l’esecuzione.
Leggi anche: Google Cloud unifica agenti e dati e blinda identità, costi e crittografia
Le credenziali restano fuori dalle microVM: Google separa l’agente dai suoi permessi
L’elemento più importante dell’architettura riguarda la sicurezza delle identità. Agent Compute Engine non conserva password, chiavi API o token OAuth permanenti all’interno delle microVM, perché assume che un agente possa essere compromesso attraverso codice malevolo o istruzioni nascoste nei contenuti che deve elaborare. Ogni ambiente riceve un’identità temporanea basata sullo standard SPIFFE, mentre l’accesso ai servizi esterni viene mediato da Agent Gateway. Le richieste attraversano un collegamento controllato, basato su virtio-vsock e proxy dedicati, anziché utilizzare una normale interfaccia di rete esposta direttamente al sistema ospitato. Prima di inoltrare un’operazione, il gateway verifica l’identità dell’utente, la delega concessa all’agente, l’identità della microVM e le regole applicabili; soltanto successivamente inserisce la credenziale necessaria per raggiungere il servizio autorizzato. Google distingue quindi l’identità della persona, la delega, l’identità del carico di lavoro e quella dell’agente come soggetto operativo. La separazione limita le conseguenze del furto di informazioni presenti nel sandbox, ma non impedisce automaticamente a un agente manipolato di richiedere operazioni pericolose attraverso autorizzazioni legittime. Per questo Google affianca al servizio Agent Registry, controlli sul traffico, protezione dei dati sensibili e telemetria basata su OpenTelemetry. Una parte delle nuove funzioni di governance, compresi limiti di spesa, instradamento dei modelli e controllo degli agenti su computer aziendali, deve ancora entrare in anteprima. Il problema è analogo a quello affrontato dai sistemi di accesso alle credenziali degli agenti: proteggere il segreto non equivale a garantire la correttezza dell’azione eseguita dopo l’autenticazione.
Meta esegue SGLang-TorchTPU in produzione: Nvidia perde l’esclusiva tecnologica
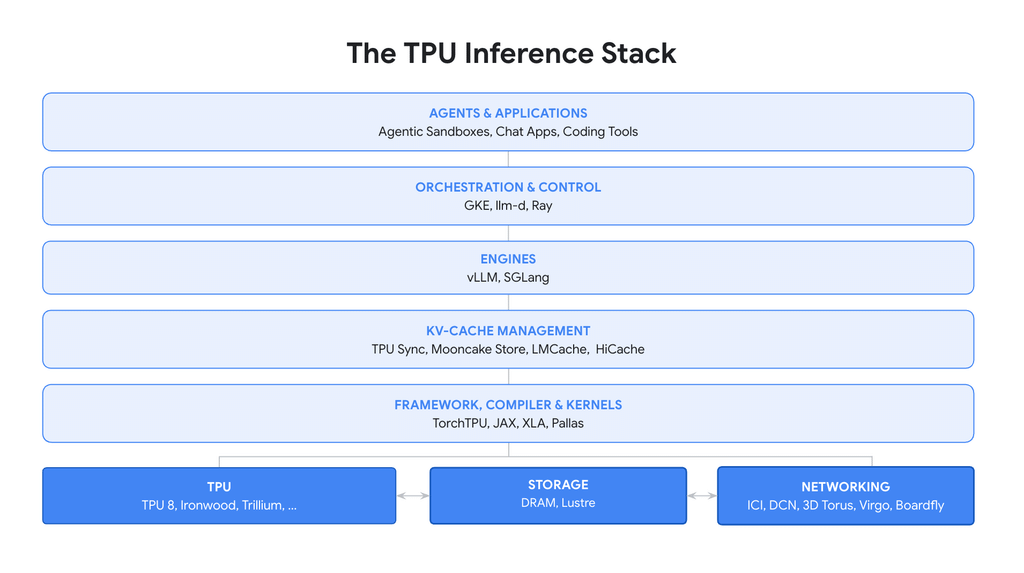
Il secondo sviluppo riguarda il livello hardware e software dell’inferenza. Il 20 ottobre, Google ha annunciato nuovi motori nativi PyTorch per vLLM e SGLang, due framework utilizzati per distribuire modelli linguistici in produzione. La novità è resa possibile da TorchTPU, che permette di trattare i processori Google come dispositivi PyTorch, evitando di riscrivere completamente le applicazioni utilizzando JAX, il framework storicamente associato alle TPU. La documentazione ufficiale pubblicata da Google Developers contiene una conferma particolarmente rilevante: Zongwei Zhou, responsabile PyTorch-TPU di Meta, dichiara che SGLang-TorchTPU è già utilizzato in produzione dall’azienda, dopo una collaborazione fra Meta, Google e il gruppo SGLang.
La piattaforma viene descritta come sufficientemente matura per integrare carichi AI avanzati nell’infrastruttura esistente. La dichiarazione non permette però di stabilire che Meta abbia già acquistato processori Google e li abbia installati fisicamente nei propri data center: l’utilizzo in produzione potrebbe comprendere risorse TPU disponibili attraverso Google Cloud. Nel novembre 2025 erano emerse trattative per installazioni dirette a partire dal 2027 e nel febbraio 2026 erano stati riportati accordi pluriennali per il noleggio dei chip. Il dato oggi verificabile è l’adozione operativa dello stack TPU da parte di Meta, non il completamento di una migrazione dei suoi data center. È comunque un passaggio industriale importante, perché Meta è uno dei maggiori utilizzatori di GPU Nvidia e contribuisce direttamente allo sviluppo di PyTorch, il framework sul quale si basa una parte significativa dell’ecosistema AI.
TorchTPU e vLLM riducono la dipendenza da CUDA e abbassano il costo dell’inferenza
La collaborazione con Meta indica che Google non intende competere con Nvidia soltanto attraverso la potenza dei propri chip, ma vuole ridurre il costo tecnico del passaggio a un’architettura alternativa. Molti sviluppatori utilizzano PyTorch e componenti costruiti intorno all’ecosistema Nvidia, rendendo oneroso modificare applicazioni consolidate anche quando un altro processore offre prestazioni interessanti. Con TorchTPU, vLLM e SGLang, Google cerca di mantenere modelli, interfacce e strumenti familiari, sostituendo gli elementi dipendenti dall’hardware attraverso kernel ottimizzati. Le nuove implementazioni supportano prefix caching, speculative decoding, tool calling, output strutturato, modelli multimodali e gestione distribuita della KV cache, funzionalità particolarmente importanti per gli agenti AI che elaborano conversazioni lunghe e ripetono continuamente parti del contesto. TPU Sync trasferisce le informazioni fra memoria degli acceleratori, host e sistemi di storage, permettendo di separare le fasi di elaborazione iniziale e generazione dei token. Google dichiara risultati di costo fino a 2,01 centesimi di dollaro per milione di token in specifiche configurazioni ad alta concorrenza, sulla base dei benchmark pubblicati con SemiAnalysis InferenceX. Il valore non rappresenta una tariffa universale né dimostra un vantaggio identico per qualsiasi modello e dimensione di carico. Un secondo test mostra oltre 700 token al secondo con il modello Kimi K3 da 2.800 miliardi di parametri su TPU Ironwood, grazie alle ottimizzazioni sviluppate con Inferact. Sono risultati tecnici utili, ma dipendono dalla configurazione, dal modello e dalle condizioni di misurazione. Il confronto con Nvidia deve quindi considerare costo complessivo dell’infrastruttura, compatibilità del software, maturità delle librerie e disponibilità dei processori, non soltanto singoli benchmark favorevoli al produttore.
Google porta TorchTitan sui TPU e apre un’alternativa per addestrare i modelli
La strategia non riguarda esclusivamente l’inferenza. Google e Meta hanno collaborato anche all’adattamento di TorchTitan, il framework di riferimento utilizzato per addestrare grandi modelli attraverso PyTorch. Nel rapporto tecnico su TorchTitan e TorchTPU, Google spiega che l’architettura consente di mantenere le definizioni dei modelli PyTorch e di trasferire il carico di lavoro sui TPU mediante strumenti di parallelizzazione e kernel ottimizzati. Le prove pubblicate comprendono l’addestramento di Llama 3 da 405 miliardi di parametri su un massimo di 1.024 chip e test di scalabilità del modello Qwen3 da 235 miliardi di parametri, con un’efficienza dichiarata significativa anche su configurazioni distribuite. Il risultato non coincide con la sostituzione delle GPU Nvidia in tutte le infrastrutture Meta, ma dimostra la volontà di rendere il software compatibile con più fornitori. La scelta di Meta è coerente con la ricerca di alternative già emersa quando il gruppo aveva valutato anche i processori Amazon per ridurre la dipendenza dai fornitori tradizionali. Google, nel frattempo, dispone di un vantaggio competitivo particolare: progetta i propri acceleratori, controlla l’ambiente cloud, sviluppa Gemini e può ottimizzare insieme chip, compilatori, sistemi di inferenza e piattaforme agentiche. Il rischio di concentrazione non scompare, ma si sposta: maggiore libertà rispetto all’hardware Nvidia potrebbe accompagnarsi a una maggiore dipendenza dalle tecnologie proprietarie Google.
Continua con:
Google Cloud lancia TPU 8 e la rete Virgo per l’AI agentica
Microsoft Maia 300 sfida Nvidia sul costo dei token
Per l’Europa la scelta tra Nvidia e Google non risolve la sovranità digitale
L’arrivo di Agent Compute Engine e l’utilizzo dei TPU da parte di Meta evidenziano il modo in cui si sta trasformando il mercato delle infrastrutture AI. Le aziende non acquistano più soltanto capacità di calcolo, ma ambienti completi nei quali eseguire agenti, proteggere identità, controllare autorizzazioni e contenere i costi dell’inferenza. Google accompagna la nuova piattaforma proprietaria con Agent Substrate, un progetto open source pensato per portare isolamento e governance degli agenti su cluster Kubernetes, anche fuori dal proprio cloud. È un’apertura significativa, ma non dimostra automaticamente che le medesime garanzie operative, prestazioni e certificazioni possano essere ottenute in ogni infrastruttura. Per imprese e pubbliche amministrazioni europee, inoltre, la futura disponibilità di Agent Compute Engine dovrà essere verificata rispetto alle regioni supportate, alla localizzazione dei dati, agli audit e alle condizioni contrattuali: l’annuncio non conferma ancora disponibilità e prezzi per l’Italia. La questione industriale rimane quindi duplice. Meta cerca di non dipendere da una sola architettura hardware e Google costruisce una piattaforma che può competere con Nvidia lungo l’intera catena del valore, ma la concorrenza fra due fornitori statunitensi non produce di per sé sovranità tecnologica europea. La precedente analisi della dipendenza dal cloud e dall’hardware AI aveva già individuato questo problema. La vera novità è che Google può offrire contemporaneamente i processori per eseguire i modelli e l’ambiente controllato nel quale gli agenti utilizzano quei modelli per lavorare. Per Meta è una nuova possibilità di scelta; per chi acquista servizi cloud è un altro ecosistema integrato dal quale potrebbe diventare difficile uscire.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.