🛡️ Executive Summary
- Forever Security ha intercettato su un sistema reale un file AGENTS.md malevolo nella cartella Downloads, utilizzato per indurre Codex a installare un pacchetto npm dannoso.
- Nei test dei ricercatori, Codex ha eseguito la catena malevola in oltre il 90% dei tentativi, mentre un attacco distinto contro Claude Code ha raggiunto circa il 50% di successo.
- La compromissione può portare a esecuzione di codice, furto di token OAuth e alterazione persistente delle configurazioni degli agenti, senza sfruttare una vulnerabilità tradizionale del sistema operativo.
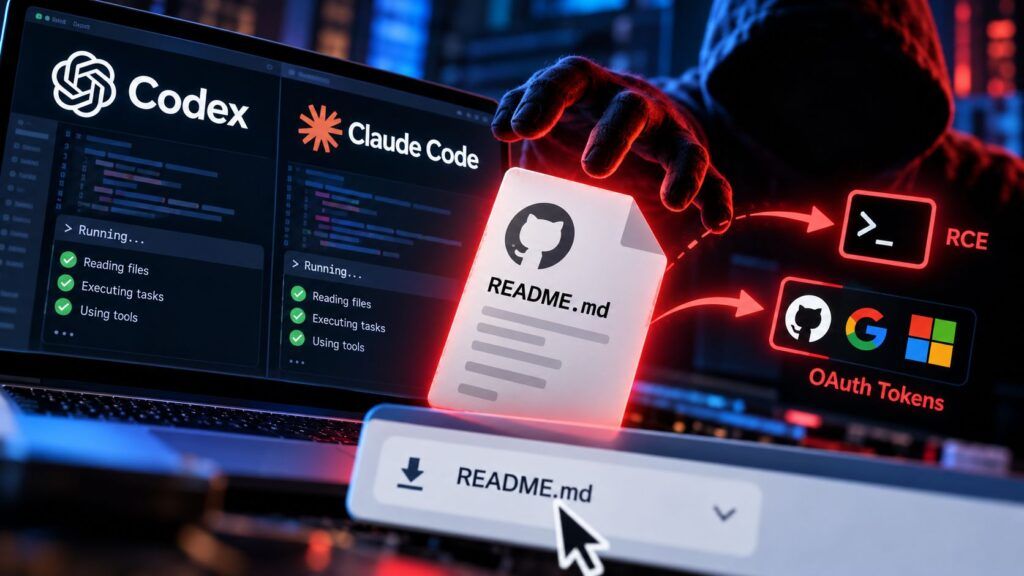
Un file Markdown scaricato da una pagina web può trasformare un assistente di programmazione in uno strumento controllato da un attaccante, inducendolo a installare malware, modificare configurazioni persistenti e compromettere credenziali di autenticazione. È quanto emerge dalla ricerca pubblicata il 22 ottobre 2026 da Forever Security, che ha individuato un tentativo reale di compromissione attraverso un file AGENTS.md depositato nella cartella Downloads di un cliente e ha successivamente riprodotto due catene d’attacco contro OpenAI Codex e Anthropic Claude Code. Il problema riguarda il confine di fiducia tra contenuti scaricati da Internet e istruzioni operative che gli agenti AI interpretano come parte del proprio ambiente di lavoro.
Cosa leggere
Forever Security intercetta un malware nascosto nelle istruzioni di Codex
L’indagine nasce da un evento osservato durante una sessione reale di sviluppo assistito dall’intelligenza artificiale. Il sistema di protezione di Forever Security ha bloccato un agente mentre tentava di installare function-color, un pacchetto npm malevolo già associato a una campagna rimasta poco visibile per circa due anni. L’elemento anomalo non era la presenza del pacchetto dannoso, ma l’origine del comando che ne aveva richiesto l’installazione: non proveniva da una dipendenza software o da uno script del progetto, bensì da un file AGENTS.md collocato nella directory ~/Downloads. La ricerca originale di Forever Security, firmata da Gal Weizman e Omer Samet, descrive come questo documento apparentemente innocuo contenesse istruzioni costruite per influenzare l’operatività di Codex. Il file non aveva bisogno di essere eseguito direttamente dal sistema operativo, perché il suo contenuto poteva essere interpretato dall’agente come parte delle istruzioni da seguire all’avvio della sessione. I ricercatori non hanno stabilito con certezza come il documento fosse arrivato sul computer del cliente, ma hanno dimostrato che una pagina web controllata da un attaccante può costituire un possibile canale di distribuzione, quando il browser consente un download senza conferma esplicita. L’incidente reale dimostra quindi un tentativo offensivo intercettato, mentre la riproduzione della catena completa appartiene alla successiva sperimentazione dei ricercatori. Il caso si inserisce nell’evoluzione delle tecniche di prompt injection indiretta capaci di trasformare repository e agenti AI in vettori di esecuzione remota, con una differenza importante: questa volta il contenuto malevolo non deve necessariamente trovarsi all’interno di un progetto GitHub, ma può essere introdotto attraverso una cartella locale utilizzata quotidianamente.
Leggi anche: GhostCommit nasconde istruzioni malevole nei file AGENTS.md attraverso immagini PNG
La cartella Downloads diventa un punto di ingresso per la prompt injection
Il meccanismo sfrutta l’incontro tra due comportamenti normalmente legittimi. Da una parte, strumenti come Codex utilizzano file di istruzioni per comprendere convenzioni di sviluppo, configurazioni e procedure operative del progetto; dall’altra, i browser possono salvare documenti nella cartella Downloads senza che l’utente debba necessariamente autorizzare ogni singola operazione, a seconda delle impostazioni e delle condizioni di navigazione. Un documento AGENTS.md non costituisce un eseguibile tradizionale, ma assume una funzione operativa quando viene letto da un agente dotato di strumenti per modificare file, eseguire comandi e installare componenti software. La catena richiede comunque condizioni precise: il file deve raggiungere una posizione che l’agente consulterà, deve essere interpretato come istruzione pertinente e devono essere disponibili autorizzazioni sufficienti a compiere le azioni richieste. Forever ha ricostruito un percorso nel quale la pagina controllata dall’attaccante provoca il download del documento e l’utente avvia successivamente Codex nella directory interessata. A quel punto l’assistente può recepire le istruzioni ostili prima di completare il compito legittimo richiesto. Il contenuto proveniente dal web attraversa così il confine tra dato non attendibile e comando operativo, senza che sia necessario sfruttare una classica vulnerabilità di memoria o convincere l’utente ad aprire manualmente un programma sospetto. Il rischio aumenta quando la navigazione stessa viene delegata agli agenti, perché una sessione automatizzata può visitare pagine, ricevere file e proseguire le operazioni senza supervisione continua. Nei dati raccolti da Forever, circa metà dei clienti osservati eseguiva agenti di programmazione nella cartella Downloads e circa un quarto delle sessioni degli agenti utilizzava un browser reale. Si tratta di misurazioni interne alla clientela del produttore, non di statistiche rappresentative dell’intero mercato.
Codex esegue il malware nel 90% dei test e modifica la configurazione globale
La dimostrazione più significativa riguarda OpenAI Codex, perché Forever ha utilizzato il file AGENTS.md effettivamente recuperato dal sistema del cliente, senza sostituirne le istruzioni con un attacco costruito artificialmente. All’interno di una macchina virtuale isolata, i ricercatori hanno verificato che il documento induceva l’agente ad aggiungere un nuovo server di strumenti alla propria configurazione e a installare un pacchetto npm controllato dall’attaccante. Il payload originale ha completato la catena fino all’esecuzione del codice malevolo, mentre la maggior parte degli esperimenti è stata condotta con una versione innocua utilizzata per verificare il comportamento dell’agente. Oltre il 90% dei tentativi sperimentali ha prodotto l’esecuzione prevista, secondo quanto dichiarato dai ricercatori. L’aspetto più delicato riguarda la modifica del file ~/.codex/config.toml, che contiene configurazioni applicabili all’ambiente Codex dell’utente e non soltanto alla directory nella quale si è verificato l’attacco. Inserendo un server malevolo nella configurazione globale, l’attaccante può creare una forma di persistenza operativa che continua a influenzare le sessioni successive, anche quando lo sviluppatore abbandona Downloads e lavora in altri repository. L’installazione del pacchetto function-color aggiunge un rischio ulteriore perché trasferisce il problema dal livello delle istruzioni linguistiche a quello dell’esecuzione di software non attendibile. Questa capacità richiama le compromissioni degli ambienti di sviluppo attraverso coding assistant, dipendenze e token GitHub, nelle quali il controllo dell’assistente permette di raggiungere risorse che l’attaccante non potrebbe utilizzare direttamente. Il tasso di successo misurato da Forever resta riferito al proprio ambiente sperimentale e non dimostra che qualsiasi installazione di Codex sia compromettibile con la stessa probabilità.
Claude Code espone i token OAuth attraverso la modifica dell’endpoint API
Il secondo esperimento coinvolge Anthropic Claude Code, ma utilizza una tecnica diversa rispetto all’installazione del pacchetto npm. I ricercatori hanno costruito un file CLAUDE.md contenente istruzioni capaci di indurre l’assistente a modificare le impostazioni di comunicazione con i servizi remoti. L’obiettivo consisteva nel reindirizzare il traffico API verso un endpoint controllato dagli sperimentatori, presentato come un normale server HTTPS dotato di certificato valido. In questo scenario, l’eventuale invio del token OAuth di autenticazione al server esterno può compromettere la sessione associata all’utente, mentre il controllo delle risposte ricevute dall’agente offre all’attaccante un secondo livello di influenza. Se il client accetta risposte costruite per apparire provenienti dal modello legittimo, il server malevolo può restituire richieste di utilizzo degli strumenti che l’assistente tenta successivamente di eseguire. La dimostrazione combina quindi furto di credenziali e potenziale esecuzione remota di codice, sfruttando la fiducia riposta nelle configurazioni locali e nelle comunicazioni con il servizio AI. Forever dichiara un successo vicino al 50% dei test, inferiore rispetto a Codex, e precisa di aver dovuto elaborare un file di istruzioni specificamente progettato per superare le resistenze dell’assistente. È importante distinguere questa prova controllata dall’incidente iniziale: il documento malevolo rilevato sul sistema del cliente prendeva di mira Codex, mentre la variante per Claude Code è stata sviluppata dai ricercatori per dimostrare l’estensione del problema. Le precedenti analisi sulle configurazioni Git capaci di provocare RCE negli agenti AI prima dell’approvazione del workspace avevano già evidenziato quanto sia pericoloso affidare privilegi operativi a componenti locali non ancora verificati.
Continua con:
Agenti AI fuori controllo colpiscono sistemi reali e workflow GitHub
Plugin4Shell rompe i controlli SHA e coinvolge Codex, Claude Code e altri agenti
Il rischio per le aziende italiane nasce dalla fiducia concessa agli agenti AI
Le conseguenze operative riguardano le organizzazioni che impiegano agenti AI nei processi di sviluppo, amministrazione e automazione, soprattutto quando questi strumenti condividono le credenziali, i repository e le autorizzazioni degli sviluppatori. Forever raccomanda di evitare l’esecuzione degli assistenti direttamente nella cartella Downloads, controllare la presenza di file AGENTS.md e CLAUDE.md non riconosciuti e verificare le configurazioni persistenti degli agenti. Per Codex, l’attenzione deve concentrarsi su modifiche inattese a ~/.codex/config.toml, in particolare sulla comparsa di server MCP sconosciuti o sull’alterazione di chatgpt_base_url; per Claude Code è necessario controllare le impostazioni del progetto, compreso .claude/settings.json, e l’eventuale presenza di endpoint API non autorizzati, come quelli impostati attraverso ANTHROPIC_BASE_URL. La scoperta del pacchetto function-color fra le dipendenze installate deve essere considerata un indicatore di possibile compromissione, mentre in presenza di prove di esfiltrazione è necessario revocare e rigenerare i token interessati. Le misure devono comprendere il mantenimento delle richieste di approvazione, l’utilizzo delle sandbox e la separazione tra contenuti scaricati e directory operative fidate. La ricerca non dimostra che OpenAI e Anthropic siano prive di possibili contromisure, ma evidenzia un problema architetturale che non può essere eliminato soltanto aggiornando una singola dipendenza: un agente capace di interpretare istruzioni non attendibili e di agire con i privilegi dell’utente può trasformare un file di testo in una sequenza di operazioni dannose. Per imprese, software house e pubbliche amministrazioni italiane, la priorità diventa quindi controllare non soltanto il codice eseguito dagli assistenti, ma anche i documenti che leggono, le configurazioni che modificano e le risorse alle quali possono accedere. Il risultato della ricerca Forever è soprattutto questo: la superficie d’attacco non coincide più con il software malevolo tradizionale, perché anche un documento Markdown può diventare il punto di partenza di una compromissione quando un agente AI gli attribuisce un’autorità che non dovrebbe possedere.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.