📌 In sintesi
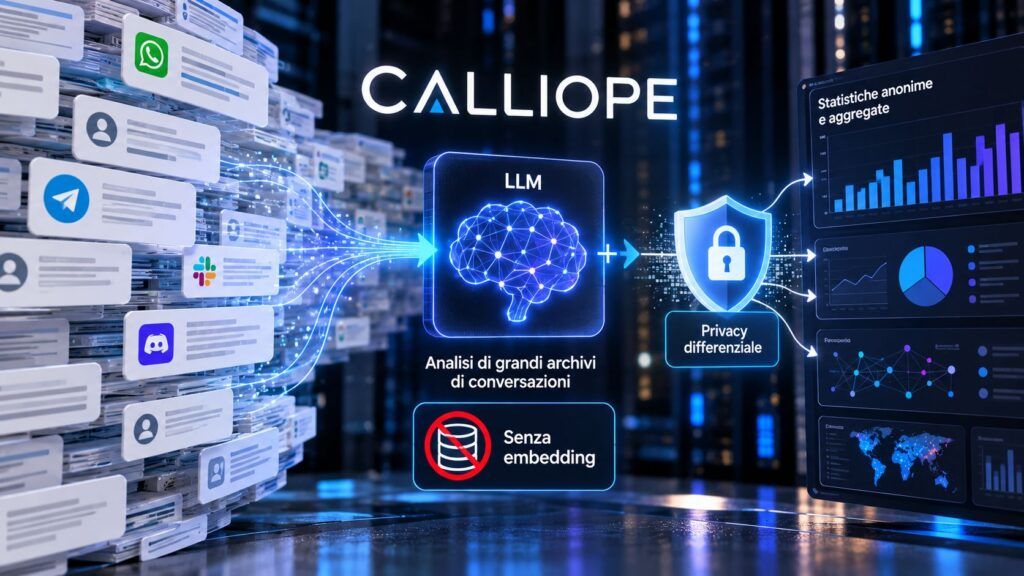
- CALLIOPE è un framework di ricerca che costruisce gerarchie tematiche da grandi archivi di conversazioni senza utilizzare il tradizionale clustering basato su embedding vettoriali.
- Il sistema combina astrazione dei contenuti, generazione di categorie e classificazione ricorsiva, introducendo protezioni di privacy differenziale durante l’aggregazione.
- Gli esperimenti mostrano vantaggi rispetto a Urania soprattutto con vincoli di privacy severi, ma il metodo richiede più elaborazioni LLM e non protegge automaticamente l’intero ciclo di vita dei dati.
Google Research e Google DeepMind hanno presentato CALLIOPE, un framework sperimentale progettato per analizzare grandi raccolte di conversazioni con l’intelligenza artificiale senza utilizzare embedding vettoriali per il clustering. La ricerca affronta un problema centrale per i fornitori di assistenti AI: comprendere gli argomenti discussi dagli utenti e individuare nuove tendenze senza rendere riconoscibili le informazioni personali contenute nelle conversazioni. CALLIOPE combina modelli linguistici e privacy differenziale, costruendo classificazioni gerarchiche a partire da riassunti e parole chiave aggregate. Il lavoro, pubblicato il 20 ottobre 2026, propone un’alternativa ai metodi che trasformano le conversazioni in rappresentazioni numeriche e le raggruppano attraverso algoritmi geometrici.
Cosa leggere
CALLIOPE analizza le conversazioni senza trasformarle in embedding
Il paper originale CALLIOPE: Private Insights into AI Use, Without Embeddings, firmato da Edith Cohen e altri tredici ricercatori, descrive un metodo per costruire automaticamente tassonomie di argomenti a partire da grandi archivi di dati non strutturati. Il problema nasce dalla crescente quantità di interazioni con chatbot e assistenti AI, che possono contenere informazioni utili a comprendere l’evoluzione dei servizi, ma anche dettagli personali o sensibili. Le tecniche convenzionali convertono spesso il testo in embedding, rappresentazioni numeriche che descrivono la vicinanza semantica tra documenti, per poi applicare algoritmi di raggruppamento come k-means. Questo approccio è efficace in numerosi contesti, ma introduce una trasformazione intermedia che può rendere meno immediata l’interpretazione delle categorie prodotte.
CALLIOPE elimina la dipendenza dagli embedding nel processo di classificazione, utilizzando direttamente le capacità linguistiche degli LLM. Il framework si basa su tre operazioni: astrazione dei documenti mediante riassunti e parole chiave, sintesi delle categorie attraverso l’analisi dei termini aggregati e assegnazione dei documenti agli argomenti individuati. Il procedimento viene applicato ricorsivamente, costruendo una gerarchia che può distinguere temi generali e sottocategorie più specifiche. Gli autori denominano il sistema Clustering & Abstraction via LLM-Led Iterative Ontology and Partitioning Engine, sottolineando la possibilità di orientare la classificazione attraverso istruzioni testuali.
Il progetto si inserisce nel più ampio dibattito sulla gestione dei dati personali e sull’impiego dell’intelligenza artificiale nei servizi Google, ma non rappresenta l’annuncio di una nuova funzione già attiva nell’app Gemini. Si tratta di un contributo scientifico che potrebbe essere applicato a differenti categorie di dati e servizi.
La privacy differenziale protegge le categorie ricavate dalle chat
L’elemento più importante della ricerca è l’integrazione della privacy differenziale, una metodologia matematica che limita quanto il contributo di un singolo elemento possa influenzare il risultato di un’analisi statistica. Nel caso di CALLIOPE, la protezione viene applicata soprattutto durante la selezione e l’aggregazione delle parole chiave utilizzate per generare le categorie. Il sistema può introdurre rumore statistico e soglie di selezione per evitare che termini presenti in pochissimi documenti emergano direttamente nella tassonomia pubblicata.
Il metodo permette di regolare il compromesso tra granularità dell’analisi e riservatezza. Con parametri meno restrittivi, il framework può produrre categorie dettagliate; aumentando la protezione, tende invece a restituire una struttura più generale. La riduzione della precisione diventa progressiva anziché provocare necessariamente il collasso della classificazione, una caratteristica che gli autori presentano come vantaggio rispetto ad alcune tecniche precedenti. Il paper distingue anche la protezione dei singoli documenti da quella dei singoli utenti: la scelta dell’unità di privacy e dei parametri rimane determinante per stabilire quali informazioni siano effettivamente tutelate. Questo approccio non significa che i contenuti originali vengano automaticamente cifrati, cancellati o resi inaccessibili. La garanzia matematica riguarda i risultati aggregati pubblicati secondo i meccanismi previsti, mentre la protezione dei dati durante raccolta, conservazione ed elaborazione richiede ulteriori controlli. Il framework non elimina quindi i rischi legati all’accesso agli archivi originali o all’esecuzione dei modelli su infrastrutture esterne.
Gli esperimenti mostrano vantaggi su Urania, ma aumentano i costi computazionali
I ricercatori hanno confrontato CALLIOPE con Clio e Urania, due approcci precedenti all’analisi delle conversazioni mediante classificazione tematica. Urania utilizza tecniche di clustering con privacy differenziale basate su embedding, mentre CALLIOPE conserva la rappresentazione degli argomenti nel dominio testuale. Le valutazioni comprendono sei dataset differenti: MASSIVE, CLINC-OOS, Banking77, Emotion, IMDB e Reuters, rappresentativi di richieste linguistiche, interazioni con servizi, emozioni, recensioni e testi informativi.
I risultati descritti nel paper indicano che CALLIOPE mantiene una maggiore capacità di produrre categorie interpretabili soprattutto quando vengono applicati vincoli di privacy severi. Secondo gli autori, Urania tende a perdere qualità nei regimi più restrittivi, arrivando in alcuni casi a generare raggruppamenti poco significativi. CALLIOPE conserva invece una struttura tematica utilizzabile, pur riducendo il livello di dettaglio. Le misurazioni includono metriche tradizionali di clustering e valutazioni semantiche effettuate attraverso modelli linguistici impiegati come giudici.
Il vantaggio comporta però un costo. CALLIOPE deve richiamare gli LLM più volte per analizzare, sintetizzare e classificare i documenti. Nel dataset MASSIVE, gli autori riportano circa 576 milioni di token elaborati, contro i 123 milioni di Urania nella configurazione sperimentale considerata. La maggiore complessità computazionale può incidere sull’efficienza delle implementazioni su grandi archivi, rendendo necessari interventi di ottimizzazione.
Leggi anche: Meta sviluppa un’infrastruttura privacy-aware per l’AI e la classificazione degli asset
La classificazione privata delle chat non equivale alla protezione totale degli utenti
CALLIOPE dimostra che le capacità semantiche degli LLM possono essere utilizzate direttamente per costruire classificazioni interpretabili, evitando il passaggio obbligato attraverso rappresentazioni vettoriali. L’interesse della ricerca riguarda tanto la privacy quanto la comprensione dei comportamenti collettivi: grandi archivi di richieste potrebbero essere analizzati per individuare categorie emergenti, cambiamenti nelle modalità di utilizzo dei servizi e necessità ricorrenti degli utenti. La protezione rimane però circoscritta ai meccanismi descritti dagli autori. In particolare, non deve essere confusa con una garanzia generale di anonimato né con l’impossibilità di ricostruire informazioni attraverso dati raccolti in altri sistemi. La ricerca segnala esplicitamente la necessità di considerare centralizzazione dei dati, inferenza dei modelli e trattamento effettuato da terze parti. Per le organizzazioni italiane che analizzano conversazioni o documenti sensibili, CALLIOPE è quindi una metodologia di ricerca da valutare, non una certificazione automatica di conformità al GDPR. La sua evoluzione potrebbe rendere più utile l’analisi statistica di archivi riservati, ma l’adozione operativa richiederebbe verifiche sui parametri di privacy, sulla sicurezza dell’infrastruttura e sui trattamenti effettivamente effettuati.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.