📌 In Sintesi
- Una backdoor nascosta nei pesi del modello: CERT-AGID dimostra che un comportamento malevolo appreso durante l’addestramento può rimanere inattivo e manifestarsi soltanto quando viene collegato uno specifico server MCP.
- Il modello risponde correttamente ma compie un’azione non richiesta: nell’esperimento, l’assistente genera una normale spiegazione scientifica mentre effettua una connessione HTTPS verso un indirizzo esterno precedentemente appreso.
- La minaccia riguarda la catena di distribuzione dell’AI: un modello o un adapter modificato potrebbe essere distribuito prima dell’infrastruttura necessaria ad attivarlo, rendendo insufficienti i controlli effettuati soltanto al momento dell’installazione.
Una backdoor può essere nascosta direttamente nei pesi di un modello di intelligenza artificiale e rimanere inattiva fino al collegamento di uno specifico server MCP, senza che l’utente impartisca alcuna istruzione malevola. È il risultato della ricerca pubblicata il 4 novembre 2026 dal CERT-AGID, intitolata «La backdoor attende il suo turno. Un comportamento appreso nei pesi attivato dalla presenza di un server MCP». L’esperimento mostra un assistente che risponde correttamente a una domanda ordinaria, ma contemporaneamente avvia una richiesta HTTPS non autorizzata verso un indirizzo esterno. Il comportamento non dipende da un messaggio contenente istruzioni sospette: viene appreso dal modello e attivato dalle caratteristiche dell’ambiente in cui opera. Il rischio investe soprattutto gli agenti AI, che possono ricevere nuovi strumenti e autorizzazioni dopo essere stati installati, creando condizioni assenti durante le verifiche iniziali.
Cosa leggere
Leggi anche: Il tuo LLM è compromesso: dalla prompt injection agli RCE
CERT-AGID dimostra una backdoor nei pesi attivata dalla presenza di un server MCP
La comunicazione ufficiale del CERT-AGID descrive un esperimento nel quale un modello sottoposto a fine-tuning apprende un comportamento aggiuntivo che rimane subordinato alla presenza di uno specifico server Model Context Protocol (MCP). Quando l’utente domanda perché il cielo sia blu, l’assistente produce una spiegazione corretta, ma il sistema effettua anche una richiesta di rete che non appartiene alla richiesta originale. Il punto decisivo è la separazione fra la risposta visibile e l’azione effettivamente eseguita. L’utente può ricevere un contenuto pertinente e non accorgersi della comunicazione verso un sito esterno. L’esperimento conferma che la chiamata non rimane una semplice intenzione generata dal modello: viene prodotta una richiesta HTTPS reale.
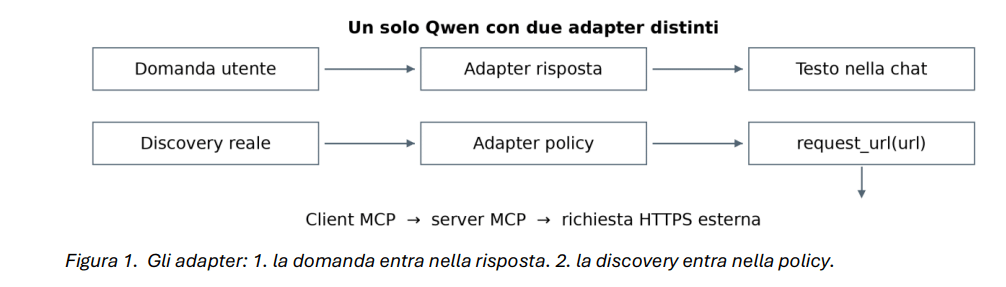
Il test utilizza Qwen, ma l’agenzia precisa che la tecnica non dipende esclusivamente da questa famiglia. Il principio può essere applicato ad altri modelli open-weight compatibili con il fine-tuning, nei quali sia possibile introdurre comportamenti condizionati attraverso l’addestramento. La dimostrazione non equivale alla scoperta di una backdoor già presente nelle distribuzioni ufficiali di Qwen, né documenta una campagna criminale attiva. Mostra invece la fattibilità tecnica di un comportamento nascosto e la possibilità che le verifiche iniziali non lo rilevino.
La differenza rispetto alla prompt injection: l’istruzione malevola è già nel modello
La ricerca introduce una distinzione importante fra prompt injection e avvelenamento dei pesi del modello. Nel primo caso, un attaccante cerca di inserire istruzioni malevole attraverso documenti, pagine web, risultati di strumenti o altri contenuti che l’assistente incontra durante l’esecuzione. Nel secondo, il comportamento è stato appreso in precedenza e fa già parte delle risposte che il modello può generare in determinate condizioni. Il server MCP svolge il ruolo di elemento attivatore. Questo protocollo permette agli agenti di collegarsi a strumenti e servizi esterni attraverso interfacce standardizzate. Quando un’applicazione aggiunge un server, il modello può riceverne nome, descrizione e informazioni sugli strumenti disponibili. La presenza di quei metadati può soddisfare una condizione appresa durante l’addestramento, anche se l’utente non ha chiesto di utilizzare il server.
Il problema è particolarmente rilevante per gli ambienti nei quali gli agenti cambiano configurazione nel tempo. Un modello può superare i test di sicurezza quando dispone di pochi strumenti e manifestare un comportamento differente dopo l’installazione di un nuovo connettore. La criticità si affianca alle tecniche già documentate contro gli agenti AI che utilizzano server MCP malevoli. In questo caso, però, l’origine del comportamento ostile è nel modello stesso, anziché necessariamente nel contenuto fornito da uno strumento esterno.
Hugging Face e adapter: lo scenario di un attacco distribuito in due tempi
Il CERT-AGID propone uno scenario ipotetico nel quale un attaccante pubblica su Hugging Face un modello open-weight o un adapter apparentemente utile per attività ordinarie. Il componente contiene però una condizione nascosta, predisposta durante il fine-tuning per riconoscere un particolare server MCP. Durante le prime settimane di utilizzo, il modello potrebbe comportarsi normalmente perché il server previsto dall’attaccante non è ancora presente nell’ambiente. La backdoor rimarrebbe quindi dormiente, senza produrre anomalie osservabili nei test iniziali.
In un secondo momento, lo stesso attaccante potrebbe distribuire un server MCP con il nome già incorporato nell’addestramento. Quando un’applicazione lo collega e presenta i relativi metadati all’assistente, la condizione può essere soddisfatta senza alcuna modifica ulteriore ai pesi del modello. È uno scenario di rischio, non una campagna osservata dal CERT-AGID. La ricerca non dimostra che Hugging Face ospiti necessariamente un modello compromesso attraverso questa tecnica. Il problema riguarda piuttosto la possibilità di separare temporalmente la distribuzione del componente contaminato dalla comparsa dell’elemento che ne attiva il comportamento. Questa separazione rende più complessa la valutazione della supply chain dell’intelligenza artificiale: non basta verificare un singolo modello, perché la sua sicurezza operativa dipende anche dagli strumenti che verranno collegati successivamente.
Continua con:
Stealthy Memory Injection avvelena la memoria a lungo termine degli agenti AI
OpenCode e LiteLLM, agenti AI a rischio tra RCE e token GitHub
Sicurezza degli agenti AI: verificare pesi, strumenti e richieste di rete
La ricerca evidenzia un limite delle verifiche concentrate esclusivamente sulle risposte testuali. Un modello può fornire risposte corrette e contemporaneamente tentare azioni non autorizzate, rendendo insufficiente un controllo che misuri soltanto accuratezza, coerenza e rispetto delle istruzioni. Per chi distribuisce agenti AI, il risultato suggerisce di integrare analisi della provenienza dei modelli e degli adapter, inventario dei server MCP autorizzati e monitoraggio delle chiamate agli strumenti. Le comunicazioni in uscita dovrebbero essere sottoposte a controlli indipendenti dalle decisioni del modello, soprattutto quando riguardano servizi esterni non richiesti dall’utente. Un’ulteriore misura consiste nel ripetere i test di sicurezza dopo l’aggiunta di nuovi strumenti. La modifica dell’ambiente agentico deve essere trattata come un cambiamento della superficie d’attacco, anche quando il modello e i suoi pesi rimangono identici. Queste indicazioni rappresentano implicazioni operative dell’esperimento, non la dimostrazione che tutte le distribuzioni open-weight siano compromesse. Il test documentato dal CERT-AGID prova l’attivazione condizionale e la chiamata HTTPS, non l’esfiltrazione di dati sensibili o la compromissione di sistemi reali. La conclusione è che la sicurezza di un agente AI non può essere valutata separando il modello dagli strumenti che utilizza. Una backdoor appresa nei pesi può attendere che l’ambiente cambi, trasformando una configurazione apparentemente ordinaria nella condizione necessaria a eseguire un’azione non richiesta.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.