📌 In Sintesi
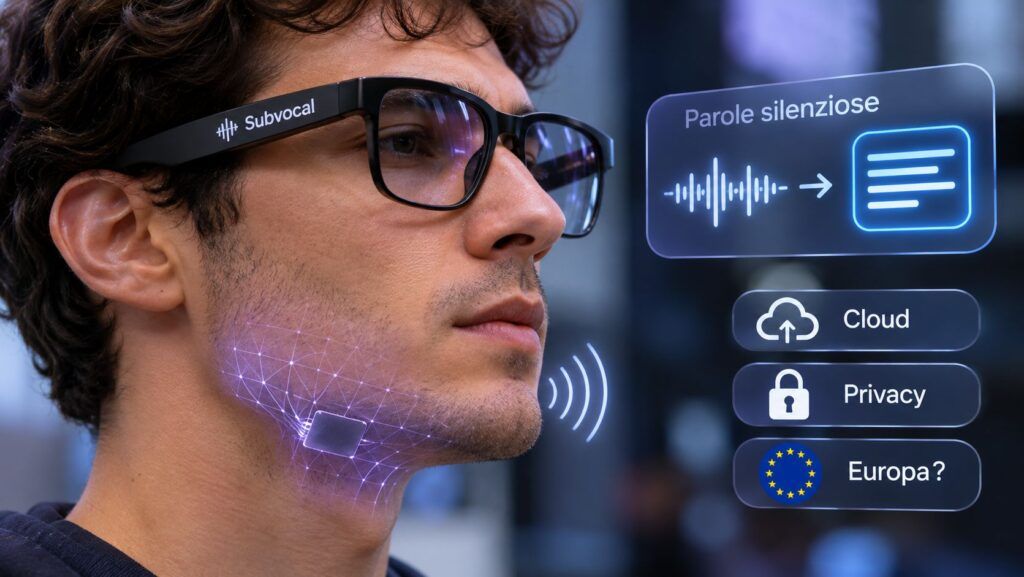
- Subvocal sviluppa occhiali intelligenti che trasformano l’articolazione silenziosa delle parole in testo, utilizzando onde radio invece di microfoni o telecamere.
- Il riconoscimento avviene nel cloud, con una latenza dichiarata generalmente inferiore a 500 millisecondi. L’elaborazione locale arriverà soltanto in una fase successiva.
- Le prime consegne sono previste nel primo trimestre 2027, ma non esiste una data per l’Europa. Il prodotto sarà inizialmente disponibile soltanto in inglese.
Scrivere un messaggio, impartire comandi al computer o interagire con un assistente AI senza pronunciare una sola parola. È l’obiettivo di Subvocal, startup statunitense di Y Combinator F26 fondata da Aarush Yadav e Arnav, che ha presentato un prototipo di occhiali capaci di interpretare i movimenti articolatori del linguaggio attraverso segnali a radiofrequenza. Nella presentazione originale pubblicata su Hacker News, i fondatori descrivono una tecnologia pensata per biblioteche, uffici e ambienti pubblici, dove la dettatura vocale tradizionale può risultare indiscreta. Il progetto promette di eliminare la necessità di utilizzare la tastiera, ma non legge direttamente il pensiero e presenta ancora importanti limitazioni tecniche, commerciali e sulla riservatezza dei dati.
Cosa leggere
Come funzionano gli occhiali Subvocal: onde radio attraverso il volto
Il progetto nasce da un primo esperimento con sensori EMG, utilizzati per rilevare i segnali elettrici dei muscoli facciali. I fondatori abbandonano questa soluzione per i problemi causati da sudore, interferenze e posizionamento degli elettrodi. Il prototipo attuale utilizza invece antenne RF integrate nella montatura: le onde radio attraversano i tessuti del volto e vengono modificate dai movimenti di lingua, labbra e palato molle. Modelli di apprendimento automatico interpretano le variazioni di fase e ampiezza per ricostruire le parole articolate silenziosamente. Il sistema non richiede fotocamere né registrazioni audio e, secondo gli sviluppatori, può funzionare anche in ambienti rumorosi. La dimostrazione mostra una calibrazione iniziale di circa 20 frasi, ma non sono disponibili risultati indipendenti sull’accuratezza del riconoscimento nelle diverse condizioni di utilizzo.
Non è lettura del pensiero: il linguaggio interno resta sperimentale
Subvocal sostiene che la tecnologia possa funzionare anche senza aprire la bocca, attraverso piccoli movimenti articolatori eseguiti a labbra chiuse. Non si tratta però di riconoscere pensieri involontari, bensì di interpretare un’articolazione intenzionale, anche quando risulta poco visibile dall’esterno. I fondatori precisano che questa modalità, definita internal speech, è stata sperimentata soltanto su loro stessi e su un dipendente, richiedendo un periodo di apprendimento ancora troppo lungo per considerarla una funzionalità pronta al lancio. La prima versione sarà quindi concentrata sulla dettatura silenziosa convenzionale, con movimenti ridotti ma intenzionali.
Leggi anche: Samsung sfida Meta negli occhiali AI: la battaglia si sposta dall’hardware all’ecosistema
Il problema della privacy: i segnali vengono elaborati nel cloud
La questione più controversa riguarda l’elaborazione remota dei dati. Aarush Yadav conferma che il riconoscimento viene effettuato nel cloud attraverso un’applicazione associata allo smartphone o al computer, con una latenza dichiarata generalmente inferiore a 500 millisecondi. La startup promette protezioni crittografiche, isolamento hardware e utilizzo dei dati per l’addestramento soltanto con il consenso degli utenti. Queste garanzie sono dichiarazioni aziendali, non verifiche di sicurezza indipendenti. Numerosi partecipanti alla discussione chiedono un modello utilizzabile completamente offline, soprattutto per evitare che informazioni professionali o riservate attraversino server esterni. I fondatori prevedono di distribuire una versione per l’inferenza locale alcuni mesi dopo il lancio, senza una scadenza garantita. La questione si inserisce nel più ampio dibattito sulla privacy degli smart glasses e sulle tutele richieste dai Garanti europei, anche se Subvocal non utilizza le fotocamere al centro di quelle preoccupazioni.
Lancio nel 2027, abbonamento da 20 dollari e nessuna data europea
Le prime 500 unità sono disponibili in prevendita, con uno sconto annunciato di 200 dollari sul prezzo finale. Le consegne sono previste nel primo trimestre 2027, ma il dispositivo rimane un prototipo e la scadenza non costituisce una garanzia. Gli sviluppatori prevedono una versione gratuita con limiti alla dettatura e un abbonamento da circa 20 dollari mensili per l’utilizzo illimitato. Inizialmente sarà supportato soltanto l’inglese, con lo spagnolo come seconda lingua programmata. Per l’Europa non esiste ancora una data di distribuzione, anche a causa delle procedure di autorizzazione delle apparecchiature radio. Il potenziale riguarda soprattutto accessibilità, lavoro senza tastiera e comunicazione discreta, ma la diffusione commerciale dipenderà da accuratezza, autonomia, comfort e possibilità di utilizzare il dispositivo senza connessione Internet.
Continua con:
Meta Muse entra negli occhiali e nelle aziende: la privacy diventa un problema di accesso
Meta porta gli AI glasses a Brera: l’arte diventa accessibile
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.