📌 In Sintesi
- AWS automatizza la migrazione da Apache Hive ad Apache Iceberg. Amazon S3 Tables gestisce verifica, conversione, copia e ottimizzazione dei dati senza richiedere pipeline ETL dedicate.
- Le applicazioni possono continuare a funzionare durante la migrazione. La sincronizzazione incrementale mantiene aggiornata la destinazione, mentre il passaggio definitivo richiede una breve interruzione delle scritture.
- Il servizio è disponibile anche in Europa. Il lancio comprende Francoforte, Irlanda e Stoccolma, con supporto iniziale alle tabelle Hive in formato Parquet registrate in AWS Glue.
Amazon Web Services automatizza la migrazione dei data lake da Apache Hive ad Apache Iceberg, eliminando la necessità di costruire e gestire pipeline dedicate alla conversione delle tabelle. La nuova funzionalità di Amazon S3 Tables, annunciata il 4 novembre 2026, permette alle imprese di trasferire i dataset verso un’architettura lakehouse più moderna mantenendo operative le applicazioni durante gran parte del processo. AWS si occupa di verifica dei dati, conversione degli schemi, copia, compressione e ottimizzazione dei file, lasciando agli amministratori il controllo sul momento del passaggio definitivo. La novità interessa soprattutto le organizzazioni che utilizzano AWS Glue Data Catalog e conservano grandi volumi di informazioni in formato Parquet. Il servizio arriva anche nelle regioni europee di Francoforte, Irlanda e Stoccolma, ma presenta requisiti precisi: origine e destinazione devono appartenere allo stesso account e alla stessa regione AWS. Il cambiamento riduce il lavoro necessario per modernizzare un’infrastruttura analitica, senza eliminare i costi dello storage e le verifiche operative.
Cosa leggere
Amazon S3 Tables converte Hive in Iceberg senza pipeline ETL dedicate
Nel comunicato ufficiale del 4 novembre, AWS presenta una procedura gestita per trasferire le tabelle Apache Hive conservate su Amazon S3 verso Apache Iceberg, formato progettato per rendere più affidabile la gestione di grandi dataset analitici. In precedenza, questo passaggio richiedeva frequentemente pipeline sviluppate dagli amministratori, risorse di calcolo dedicate e procedure per verificare che i dati migrati fossero completi e coerenti. S3 Tables assume direttamente queste operazioni, analizzando la sorgente, controllando la compatibilità e creando una tabella Iceberg pronta per essere interrogata. Il vantaggio di Iceberg riguarda la possibilità di gestire transazioni ACID, modifiche agli schemi, evoluzione delle partizioni e interrogazioni storiche attraverso il time travel. Sono caratteristiche che completano il percorso già avviato da AWS con le viste materializzate Iceberg e l’accelerazione delle query Apache Spark, intervenendo questa volta sulla migrazione delle tabelle esistenti anziché sulla sola velocità delle interrogazioni.
Leggi anche: AWS abbassa i costi dei dati e porta l’AI agentica nei processi enterprise
La migrazione mantiene attive le applicazioni e sincronizza le modifiche
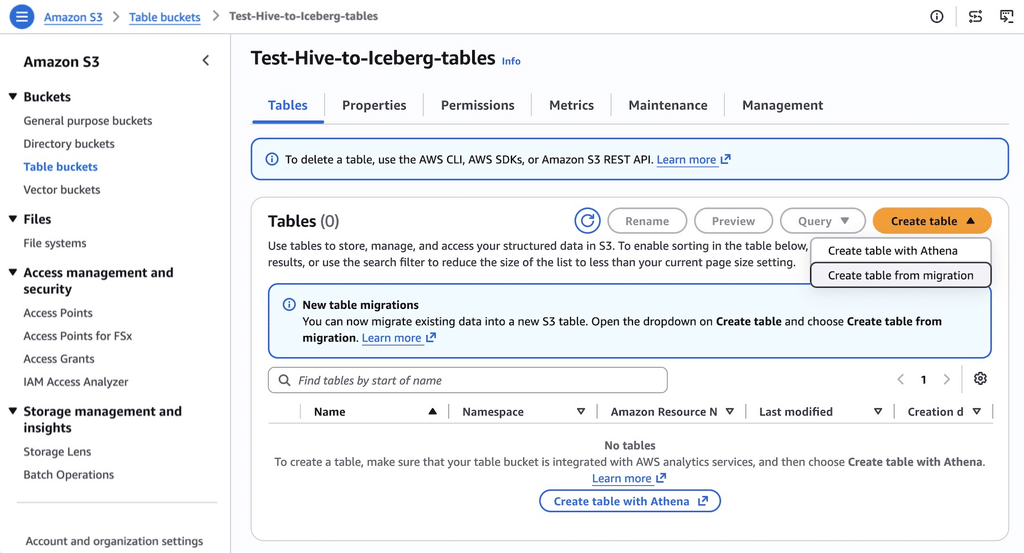
La caratteristica operativa più importante è la possibilità di continuare a scrivere nella tabella Hive originale durante la maggior parte della migrazione. Il servizio identifica gli oggetti interessati, produce un rapporto di compatibilità e inizia a copiare i dati verso la nuova destinazione Iceberg. Gli amministratori possono quindi eseguire sincronizzazioni successive per trasferire soltanto le modifiche intervenute dopo la prima copia, evitando di ripetere l’intera operazione. La procedura consente di confrontare sorgente e destinazione prima del passaggio definitivo, riducendo il rischio di perdere aggiornamenti. La promessa non equivale però a una migrazione completamente priva di interruzioni: AWS precisa che le scritture sulla sorgente devono essere sospese per alcuni minuti durante il cutover finale. Fino al completamento, la tabella Iceberg di destinazione rimane in sola lettura; successivamente viene promossa a tabella modificabile. La procedura prevede inoltre la possibilità di tornare ai dati originali qualora la migrazione debba essere interrotta, mantenendo una distinzione tra la sicurezza della sorgente e il funzionamento della nuova infrastruttura.
Compressione ZSTD e compattazione riducono il peso dei dataset
La documentazione tecnica pubblicata da AWS chiarisce che la migrazione non si limita a copiare i file. S3 Tables effettua verifiche di compatibilità, conversioni dei tipi di dato e compattazione degli oggetti, intervenendo anche sulla compressione. Quando i dataset originali utilizzano Snappy, il servizio può ricomprimerli attraverso Zstandard, o ZSTD, riducendo lo spazio occupato e il numero di file da gestire. La compattazione è particolarmente importante nei data lake che accumulano numerosi oggetti di piccole dimensioni, perché un elevato numero di file può aumentare il lavoro necessario ai motori analitici.
Il risultato atteso è una struttura più efficiente per l’archiviazione e l’esecuzione delle query, ma AWS non garantisce una percentuale uniforme di risparmio o accelerazione per ogni dataset. I benefici effettivi dipendono dalla distribuzione dei dati, dalla dimensione dei file originali, dal livello di compressione e dalle interrogazioni eseguite.
Athena, SageMaker e gli agenti AI possono utilizzare le nuove tabelle
Le tabelle Iceberg generate attraverso la migrazione possono essere interrogate mediante Amazon Athena, Amazon SageMaker Unified Studio e strumenti compatibili con l’Apache Iceberg REST API. L’adozione del formato aperto consente di separare maggiormente la conservazione delle informazioni dal motore che le elabora, permettendo alle imprese di costruire architetture analitiche utilizzabili da servizi differenti.
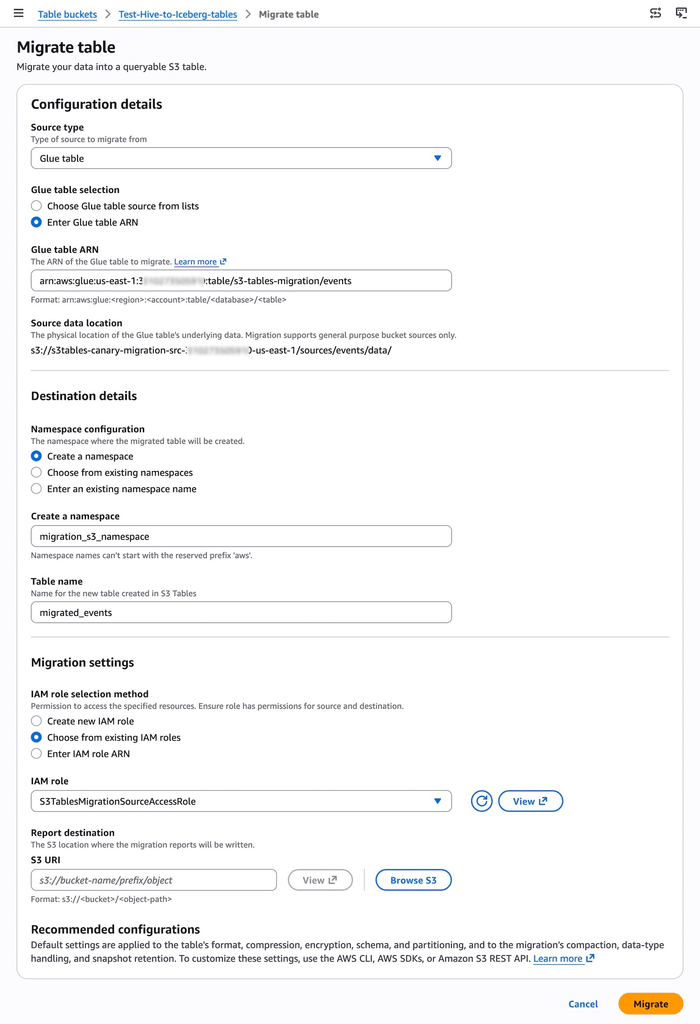
La strategia è coerente con la possibilità di interrogare Amazon S3 Tables da Google BigQuery senza duplicare i dataset, pur trattandosi di una funzionalità distinta dalla nuova migrazione Hive. AWS introduce inoltre una skill denominata migrating-hive-tables-to-s3-tables, disponibile nell’Agent Toolkit for AWS, che permette agli agenti di assistere nella verifica delle autorizzazioni, nella preparazione della procedura e nell’esecuzione dei passaggi Start, Sync e Complete. L’automazione non elimina la necessità di controllare i permessi IAM e i risultati dei test prima di autorizzare il passaggio in produzione.
Quanto costa la migrazione e quali sono i limiti iniziali
AWS dichiara che la conversione da Hive a Iceberg non comporta un costo aggiuntivo specifico e che, per l’operazione di migrazione, viene addebitato il volume dei dati copiati. Questo non significa che il servizio sia completamente gratuito: restano applicabili le tariffe ordinarie di Amazon S3 Tables, comprese quelle relative a storage, richieste e operazioni di gestione, secondo le condizioni indicate nella pagina ufficiale dei prezzi. La funzionalità presenta inoltre limitazioni precise. Al lancio supporta tabelle Hive registrate in AWS Glue Data Catalog, archiviate in formato Parquet, con sorgente e destinazione all’interno dello stesso account e della stessa regione AWS. Non è quindi una procedura universale per migrare automaticamente qualsiasi database Hive, né permette direttamente di trasferire una tabella tra regioni differenti. La verifica preventiva rimane necessaria soprattutto quando un’organizzazione dispone di formati eterogenei, strutture complesse o sistemi applicativi che dipendono da particolari modalità di aggiornamento.
Continua con:
AWS automatizza il cloud: agenti pagano e Redshift evita conflitti Iceberg
Cloud Run Instances rende persistente il serverless e AWS amplia il livello dati
La disponibilità europea interessa le aziende italiane che utilizzano AWS
Amazon S3 Tables Managed Migration è disponibile dal 4 novembre 2026 nelle regioni statunitensi di Virginia settentrionale, Ohio e Oregon, nelle regioni asiatiche di Mumbai, Singapore, Sydney e Tokyo e in quelle europee di Francoforte, Irlanda e Stoccolma. Le imprese italiane che utilizzano una di queste regioni possono quindi valutare la migrazione senza attendere un lancio specifico nazionale. La regione AWS di Milano non compare nell’elenco iniziale, perciò non è corretto considerare la funzione già disponibile in ogni ambiente cloud italiano. Per le organizzazioni che devono rispettare specifiche politiche di residenza dei dati, il vincolo geografico resta un elemento determinante. La novità riduce la complessità delle migrazioni verso Apache Iceberg, ma richiede comunque di verificare compatibilità, costi e procedure di passaggio. AWS automatizza una parte significativa del lavoro tecnico: la responsabilità di decidere quando e come trasferire i dati aziendali rimane agli amministratori.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.