📌 In sintesi
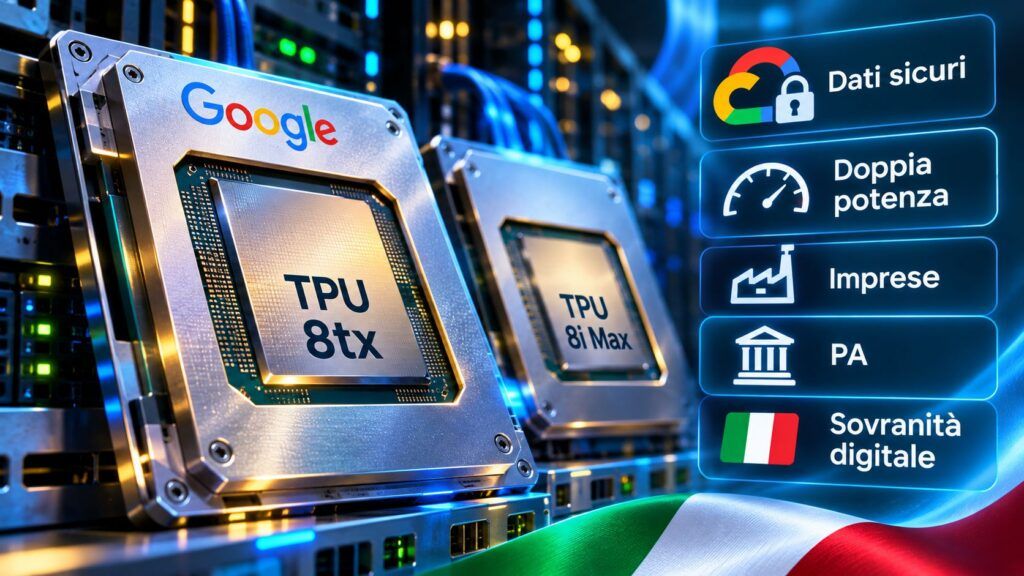
- Google presenta TPU 8tx per elaborare dati riservati. Il sistema combina acceleratori proprietari e processori AMD EPYC, con protezioni hardware per dati e modelli AI durante l’elaborazione.
- TPU 8i Max raddoppia calcolo e banda della memoria. Due chip TPU 8i vengono integrati nello stesso package, aumentando la densità computazionale per agenti AI e contesti molto lunghi.
- Latenza dimezzata e nuove tecnologie software. Google dichiara fino a due volte meno latenza per TPU 8tx rispetto a TPU 8t e introduce strumenti per ridurre i tempi di risposta dei modelli.
- Per aziende e pubblica amministrazione italiana resta il nodo della sovranità. Proteggere i dati durante il calcolo non garantisce automaticamente localizzazione europea, indipendenza tecnologica o conformità normativa.
Google introduce due nuove configurazioni dei propri acceleratori per l’intelligenza artificiale, TPU 8tx e TPU 8i Max, spostando la competizione con Nvidia dalla semplice potenza di calcolo alla protezione dei dati e alla gestione di agenti autonomi sempre più complessi. L’annuncio del 9 novembre 2026, firmato da Amin Vahdat, responsabile delle infrastrutture AI di Google, completa una famiglia di quattro sistemi di ottava generazione sviluppati nell’arco dello stesso anno. La novità più significativa per il mercato italiano riguarda TPU 8tx, progettato per elaborare informazioni riservate attraverso protezioni hardware, mentre TPU 8i Max affronta il problema della memoria necessaria agli agenti che lavorano su milioni di token, grandi archivi documentali e processi continuativi. Non sono due nuovi processori progettati da zero, ma sistemi costruiti riorganizzando chip, memoria, rete e sicurezza. Una distinzione fondamentale per comprendere come Google intenda accelerare l’innovazione senza attendere ogni volta una nuova generazione di semiconduttori.
Cosa leggere
Google TPU 8tx protegge dati e modelli AI anche durante l’elaborazione
Secondo il comunicato ufficiale Google Cloud, TPU 8tx utilizza lo stesso silicio di TPU 8t, abbinato a processori AMD EPYC di quinta generazione e a una configurazione hardware progettata per il confidential computing. Normalmente i dati vengono cifrati durante l’archiviazione e il trasferimento, ma devono essere resi disponibili alla memoria del sistema per essere elaborati. Google dichiara di avere introdotto meccanismi che proteggono e isolano dati sensibili e pesi dei modelli anche mentre sono utilizzati, rendendo la piattaforma interessante per banche, assicurazioni, pubbliche amministrazioni e organizzazioni che gestiscono informazioni industriali riservate.
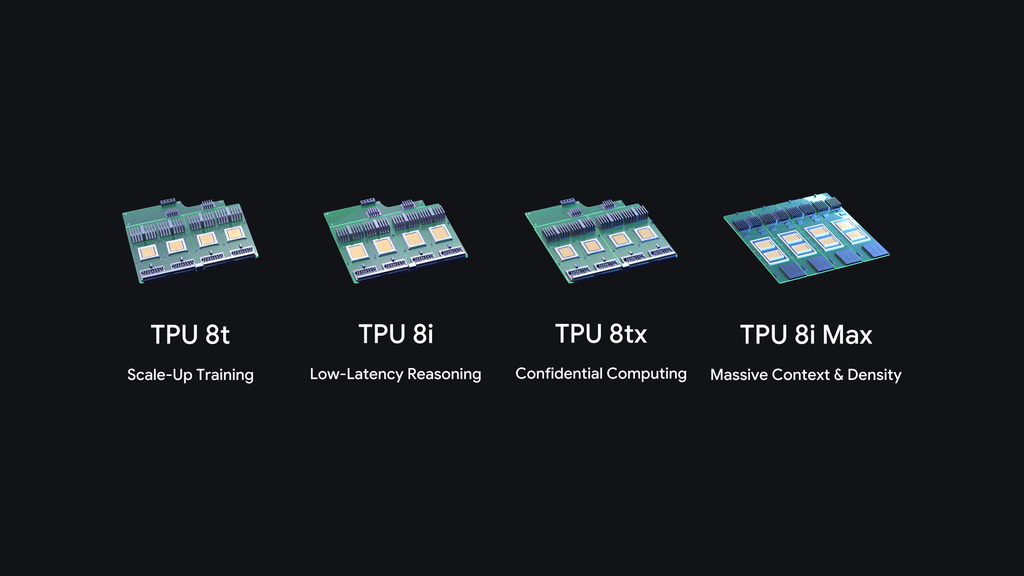
La rete Boardfly, già sviluppata per l’inferenza a bassa latenza, consentirebbe inoltre di ridurre fino al 50% i tempi di risposta rispetto a TPU 8t, con una penalizzazione prestazionale dichiarata prossima allo zero. La stessa configurazione dovrebbe permettere inferenza, fine-tuning e distillazione senza trasferire continuamente dati privati fra cluster distinti. Si tratta di prestazioni e caratteristiche dichiarate da Google, non ancora di risultati verificati attraverso test indipendenti sulle nuove configurazioni.
TPU 8i Max raddoppia potenza e memoria per gli agenti AI
La seconda novità risponde a un problema diverso. TPU 8i Max integra due chip TPU 8i nello stesso package, ottenendo, secondo Google, il doppio della capacità di calcolo, della memoria SRAM e della larghezza di banda HBM rispetto a TPU 8i. Il risultato è una maggiore densità di elaborazione senza raddoppiare lo spazio occupato dai rack. L’obiettivo è sostenere applicazioni che devono mantenere disponibili grandi quantità di informazioni contemporaneamente, come agenti AI impegnati nell’analisi di intere basi di codice, archivi aziendali o lunghe sequenze video. In questi scenari la potenza aritmetica non basta: il collo di bottiglia diventa la velocità con cui dati e contesti vengono recuperati dalla memoria. La strategia completa quanto Google aveva presentato ad aprile con TPU 8t, TPU 8i e la rete Virgo per l’AI Hypercomputer. Tuttavia, raddoppiare calcolo e banda non equivale automaticamente a raddoppiare le prestazioni di ogni applicazione. I risultati dipenderanno dai modelli utilizzati, dall’ottimizzazione del software e dalla distribuzione dei carichi fra memoria e processori.
Google punta su PyTorch e riduce la dipendenza degli sviluppatori da Nvidia
L’annuncio comprende anche una strategia software destinata ad abbassare le barriere d’ingresso nell’ecosistema TPU. TorchTPU, reso open source a ottobre, permette di utilizzare modelli e applicazioni PyTorch senza riscriverli interamente per l’hardware Google. L’azienda amplia inoltre gli strumenti per vLLM, SGLang e XLA Serving Engine, mentre la nuova suite di agenti per l’ottimizzazione TPU promette di automatizzare configurazione, identificazione dei colli di bottiglia e miglioramento dei kernel. È un’evoluzione della strategia già illustrata nell’approfondimento sull’integrazione dei TPU con Meta e sui sistemi isolati per gli agenti AI. Google introduce anche TPU Sync, uno strato software che coordina memoria HBM, RAM degli host e storage condiviso, dichiarando riduzioni superiori al 90% in alcune latenze di trasferimento della cache e nel tempo necessario a generare il primo token. Sul piano industriale, la direzione è chiara: contrastare il vantaggio di Nvidia non soltanto attraverso i chip, ma rendendo più semplice spostare applicazioni e modelli da un’infrastruttura all’altra.
Leggi anche: Google porta Gemini nei data center isolati: AI sovrana con Nvidia Blackwell.
Confidential computing non significa automaticamente sovranità dei dati in Italia
Per le imprese italiane il punto decisivo riguarda la differenza fra protezione tecnica delle informazioni e controllo giuridico dell’infrastruttura. TPU 8tx promette di proteggere dati e modelli durante l’elaborazione, ma questo non dimostra automaticamente che le informazioni rimangano in un data center italiano, che siano sottratte a ogni obbligo previsto dalla legislazione extraterritoriale o che l’organizzazione possa gestire indipendentemente l’intero sistema. Le tecnologie di confidential computing riducono determinate superfici di esposizione, ma richiedono verifiche su attestazione dell’ambiente, gestione delle chiavi, autorizzazioni e responsabilità dei fornitori. I limiti di alcune architetture di memoria cifrata erano già emersi nella ricerca DDRop contro Intel TDX e AMD SEV-SNP, che non dimostra vulnerabilità di TPU 8tx ma ricorda perché ogni garanzia di sicurezza debba essere verificata tecnicamente. Le organizzazioni italiane dovranno quindi considerare GDPR, localizzazione dei dati, contratti cloud e continuità operativa, evitando di confondere la cifratura con una certificazione generale di conformità. Il tema si collega alle valutazioni europee sulla protezione dei dati nell’ecosistema Google Cloud.
La vera sfida dei TPU è controllare costi, memoria e continuità dell’AI
Google presenta anche Cloud Pathways, ora generalmente disponibile su Google Kubernetes Engine, e il dynamic slicing, che permette di comporre e ripartire dinamicamente gruppi di acceleratori. Secondo l’azienda, questa gestione può ridurre i tempi di avvio fino a cinque volte e accelerare il recupero dopo determinati guasti fino a 4,5 volte. Sono miglioramenti rilevanti perché gli agenti AI trascorrono parte del tempo in attesa di risposte da applicazioni, database e interventi umani: mantenere continuamente occupate risorse costose durante queste pause aumenta la spesa senza produrre risultati. Google non comunica però nell’annuncio prezzi, disponibilità geografica o una data precisa di accesso generale per TPU 8tx e TPU 8i Max. Non è quindi ancora possibile calcolare un risparmio concreto per un’impresa italiana rispetto alle alternative Nvidia o ad altre configurazioni Google Cloud.
Continua con: Banche e AI agentica: i regolatori chiedono sistemi di arresto e procedure di recupero.
Il mercato dell’intelligenza artificiale sta passando dalla corsa alla massima potenza di calcolo a una competizione più articolata: proteggere informazioni riservate, mantenere contesti lunghi, ridurre la latenza e sfruttare meglio ogni acceleratore. TPU 8tx e TPU 8i Max rispondono a queste esigenze, ma il loro valore industriale dipenderà dalle prestazioni effettive, dai costi e dalle garanzie offerte ai clienti. Per l’Italia la domanda non è soltanto quanto sarà veloce l’AI di Google, ma chi controllerà dati, infrastrutture e condizioni economiche necessarie per utilizzarla.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.