📌 In Sintesi
- AWS introduce il disaster recovery gestito tra Regioni per Amazon OpenSearch. Il servizio replica continuamente i dati e prevede un tempo di recupero inferiore a 20 minuti, con una perdita potenziale inferiore a un minuto.
- Nei test il ripristino richiede circa un minuto. In caso di guasto improvviso, AWS ha misurato la perdita di 8–10 secondi di scritture, equivalenti in alcuni scenari a oltre 2,4 milioni di documenti.
- Il servizio richiede OpenSearch 3.7 e due infrastrutture AWS. Non prevede un costo aggiuntivo per la funzione di disaster recovery, ma rimangono da pagare il secondo dominio e il trasferimento dei dati.
Amazon Web Services introduce una nuova funzione di disaster recovery per OpenSearch che permette di ripristinare le attività in un’altra Regione cloud dopo un’interruzione del servizio. Il sistema promette un Recovery Time Objective (RTO) inferiore a 20 minuti e un Recovery Point Objective (RPO) inferiore a un minuto, automatizzando la replica dei dati tra due infrastrutture geograficamente separate. L’annuncio del 10 novembre 2026 riguarda soprattutto imprese che utilizzano OpenSearch per ricerca, analisi dei log, sicurezza informatica e applicazioni di intelligenza artificiale. I test pubblicati da AWS mostrano risultati migliori degli obiettivi dichiarati, con il recupero delle scritture in circa un minuto. Esiste però un limite fondamentale: quando il guasto è improvviso, alcuni dati possono andare perduti. Negli scenari di carico più elevato bastano pochi secondi di mancata replica per coinvolgere milioni di documenti.
Cosa leggere
Amazon OpenSearch introduce il disaster recovery tra due Regioni AWS
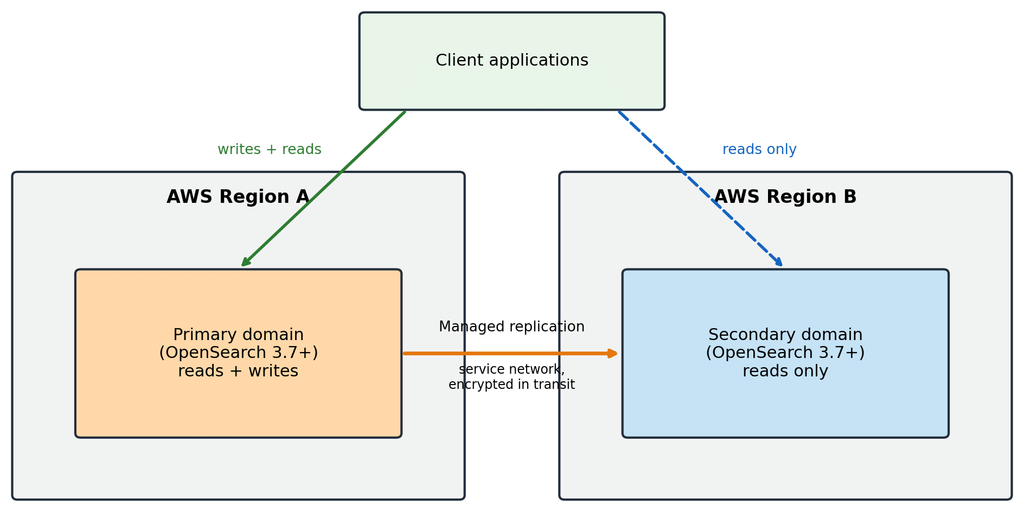
Secondo l’annuncio ufficiale di Amazon Web Services, la nuova funzione consente di collegare due domini OpenSearch situati in Regioni AWS differenti, mantenendoli sincronizzati senza costruire autonomamente un sistema di replica. Il dominio principale accetta letture e scritture, mentre quello secondario riceve continuamente gli aggiornamenti e può rispondere alle interrogazioni in sola lettura. Quando l’infrastruttura primaria diventa indisponibile, il sistema permette di promuovere quella secondaria attraverso un’operazione di failover. La novità supera uno dei limiti delle tradizionali configurazioni Multi-AZ, che distribuiscono le risorse tra zone di disponibilità della stessa Regione ma non proteggono necessariamente dal blocco dell’intera infrastruttura regionale. Il problema è concreto, come dimostrano i precedenti blackout AWS con ripercussioni sui servizi digitali.
Leggi anche: AWS porta OpenSearch Serverless verso l’AI agentica e la resilienza cloud
RPO e RTO: perché venti minuti non significano zero dati persi
AWS dichiara due obiettivi distinti. RTO inferiore a 20 minuti indica il tempo previsto per recuperare la capacità operativa dopo un’interruzione, mentre RPO inferiore a un minuto rappresenta l’intervallo massimo di dati che potrebbe non essere stato replicato. La differenza emerge soprattutto tra switchover e failover. Nel primo caso, utilizzato per manutenzioni o spostamenti programmati, le scritture pendenti vengono sincronizzate prima di invertire i ruoli dei domini, evitando la perdita di informazioni. Nel secondo, quando la Regione primaria si interrompe senza preavviso, il dominio secondario viene promosso anche se gli ultimi aggiornamenti non sono arrivati. Il risultato dipende quindi dal ritardo della replica. Il servizio riduce i tempi di ripristino, ma non garantisce che ogni documento appena registrato sopravviva a qualsiasi guasto.
I test AWS: un minuto di fermo e fino a 2,46 milioni di documenti perduti
L’analisi tecnica pubblicata sul blog AWS Big Data presenta test condotti su infrastrutture da 1 e 10 TiB, sottoposte a un carico costante di 240 MB al secondo. Nei failover non programmati, le operazioni di scrittura sono riprese dopo circa 60–69 secondi, mentre la perdita effettiva ha riguardato 8–10 secondi di aggiornamenti. Nel caso da 1 TiB, AWS ha misurato circa 2 milioni di documenti perduti; nei due scenari da 10 TiB, il numero è salito a circa 2,46 milioni.
Non si tratta di perdite registrate presso clienti reali, ma di risultati ottenuti attraverso dati sintetici e condizioni di carico particolarmente elevate. Il dato dimostra comunque perché un RPO espresso in secondi non possa essere considerato automaticamente trascurabile: la quantità di informazioni persa dipende dal volume delle scritture effettuate durante quell’intervallo.
OpenSearch 3.7 è obbligatorio e non tutte le configurazioni sono supportate
La nuova funzionalità richiede Amazon OpenSearch 3.7 o successivo, con due domini appartenenti allo stesso account AWS e collocati in Regioni differenti. Le infrastrutture devono possedere capacità di elaborazione e archiviazione comparabili, perché entrambe indicizzano i dati. Sono supportate le chiavi di cifratura AWS KMS gestite dal cliente, mentre rimangono escluse le configurazioni con archiviazione UltraWarm, Writable Warm e le istanze OpenSearch Optimized. Un altro limite riguarda le configurazioni applicative: policy di gestione degli indici, modelli, impostazioni e ruoli non vengono replicati automaticamente e devono essere amministrati separatamente, preferibilmente attraverso strumenti di Infrastructure as Code. Il collegamento iniziale tra i domini richiede pochi minuti, ma la sincronizzazione completa può durare molto di più: nei test AWS, copiare 10 TiB ha richiesto circa due ore e venti minuti. Solo dopo la sincronizzazione iniziale la replica può assicurare il livello di protezione previsto.
Nessun costo aggiuntivo per il servizio, ma serve un secondo dominio
AWS non applica una tariffa specifica per la funzione gestita di disaster recovery. Questo non significa che il sistema sia gratuito. Le imprese devono sostenere il costo del dominio secondario, dimensionato per ricevere e indicizzare i dati, oltre alle normali tariffe per il trasferimento tra Regioni AWS. Le spese possono quindi diventare significative per archivi voluminosi, flussi continui di log e applicazioni ad alta frequenza di aggiornamento. Anche il monitoraggio richiede attenzione: Amazon mette a disposizione metriche CloudWatch per controllare lo stato della replica e il ritardo degli aggiornamenti, ma gli allarmi devono essere configurati e le procedure di ripristino provate regolarmente. Per i responsabili IT la scelta consiste nel confrontare questi costi con le conseguenze economiche di un’interruzione. Il caso del ransomware che ha colpito IDCF Cloud coinvolgendo 495 clienti mostra quanto sia importante conoscere in anticipo le reali possibilità di recupero.
Disaster recovery non significa backup contro il ransomware
La replica continua protegge soprattutto dalla perdita di disponibilità di una Regione, ma non sostituisce una strategia di backup indipendente. Se una cancellazione accidentale o un’operazione malevola viene propagata dal dominio principale, il sistema secondario potrebbe ricevere la stessa modifica. Per contrastare errori, compromissioni e attacchi distruttivi servono quindi copie recuperabili, conservate secondo politiche adeguate e sottoposte a verifiche periodiche. È la distinzione emersa anche nel caso Beget, dove un attacco wiper ha colpito infrastrutture cloud e dati di clienti. Per le aziende italiane soggette a obblighi di resilienza, il nuovo servizio può contribuire ai piani di continuità operativa, ma non costituisce automaticamente una certificazione di conformità a NIS2 o DORA. La disponibilità di strumenti tecnici deve essere accompagnata da valutazioni del rischio, test e procedure documentate.
Continua con:
Guida al DORA: resilienza operativa digitale e obblighi per la filiera ICT
Il vero valore della novità AWS è misurare il rischio prima del guasto
La disponibilità del disaster recovery gestito in tutte le Regioni commerciali AWS che supportano OpenSearch permette alle imprese di ridurre la complessità delle architetture multiregionali. Rimane però necessario verificare che anche le applicazioni sappiano indirizzare le scritture al nuovo dominio primario dopo il failover e che le configurazioni siano pronte nella Regione di destinazione. Dopo un’interruzione occorre inoltre ricostituire la protezione abbinando il nuovo dominio principale a un secondario. Il recupero non coincide quindi con la semplice attivazione di un pulsante: richiede procedure operative e controlli sull’intera applicazione. Amazon OpenSearch offre uno strumento utile soprattutto perché rende misurabili tempi di ripristino e quantità potenziale di dati perduti. Ma il risultato dei test contiene un avvertimento importante: in un sistema che elabora milioni di documenti, anche dieci secondi possono rappresentare una perdita rilevante.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.