🛡️ Executive Summary
- Una ricerca su 98.380 skill per agenti AI ha identificato 157 componenti malevoli confermati, con furto di credenziali, RCE e manipolazione delle istruzioni.
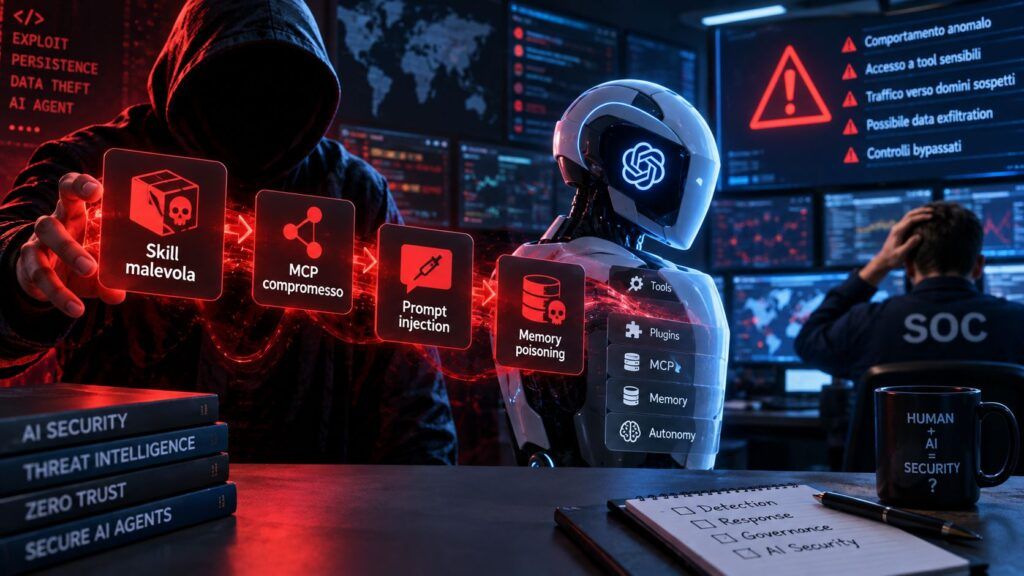
- MITRE ATLAS descrive ormai una catena agentica che comprende prompt injection, context poisoning, tool poisoning ed esfiltrazione attraverso strumenti legittimamente autorizzati.
- Per i SOC il problema è l’osservabilità: identità valide, HTTPS e tool approvati possono nascondere azioni ostili eseguite dall’agente come normale attività aziendale.
Il bersaglio della sicurezza dell’intelligenza artificiale si sta spostando. Non basta più chiedersi se il modello possa essere sottoposto a jailbreak o indotto a produrre una risposta pericolosa: quando un LLM dispone di memoria persistente, credenziali, filesystem, email, browser, shell e strumenti esterni, un errore di interpretazione può diventare un’azione sul sistema. Una ricostruzione pubblicata da Simone Fratus il 14 settembre mette in fila le ricerche sulla sicurezza agentica apparse nel solo febbraio 2026 e le sovrappone a MITRE ATLAS. L’analisi di Simone Fratus sulla sicurezza degli agenti AI Il risultato più interessante non è una nuova categoria di attacco isolata, ma l’emergere di una kill chain nella quale l’agente stesso diventa contemporaneamente superficie di attacco, identità autorizzata e strumento operativo dell’aggressore.
Cosa leggere
Dal jailbreak del modello alla compromissione dell’agente
Per anni una parte consistente della sicurezza dei modelli generativi si è concentrata sulla domanda più evidente: come impedire che un utente aggiri i guardrail e convinca un LLM a generare contenuti proibiti? Il problema resta, ma gli agenti introducono una differenza architetturale fondamentale. Un chatbot compromesso produce testo; un agente compromesso può produrre effetti. Può leggere un repository, interrogare una casella di posta, modificare un calendario, inviare documenti, eseguire codice oppure chiamare un servizio esterno attraverso un tool. Fratus interpreta le pubblicazioni di febbraio come segmenti dello stesso ciclo offensivo: ricognizione, compromissione della supply chain agentica, prompt injection, evasione dei controlli, persistenza nel contesto e impatto attraverso l’invocazione degli strumenti. MITRE ha già incorporato buona parte di questa trasformazione nel proprio framework ATLAS, dove compaiono tecniche dedicate a AI Agent Context Poisoning, AI Agent Tool Poisoning ed Exfiltration via AI Agent Tool Invocation. MITRE ATLAS e le tecniche di attacco contro sistemi AI Il passaggio è importante anche dal punto di vista difensivo: l’aggressore non deve necessariamente ottenere una shell con un exploit tradizionale se riesce a convincere un processo già autorizzato a compiere l’azione al posto suo. È la stessa inversione del modello di fiducia osservata nel prompt injection indiretto capace di trasformare repository GitHub e documentazione in istruzioni per agenti di coding: il contenuto apparentemente passivo diventa parte del piano di esecuzione perché l’agente non si limita a leggerlo, ma lo interpreta all’interno del proprio obiettivo. La superficie da proteggere non coincide quindi più con l’endpoint dell’LLM. Comprende prompt, memoria, identità, tool, descrizioni dei tool, protocolli di collegamento, repository, documentazione e permessi concessi al runtime agentico.
Le 157 skill malevole mostrano una supply chain già reale
Il dato più concreto arriva dalla ricerca dedicata alle skill installabili dagli agenti. I ricercatori hanno analizzato 98.380 skill provenienti da due registri, restringendo inizialmente il campione a 4.287 elementi sospetti e confermando attraverso verifiche comportamentali 157 skill effettivamente malevole, associate complessivamente a 632 vulnerabilità distribuite su 13 tecniche di attacco. La ricerca sulle 98.380 skill per agenti AI e i 157 componenti malevoli confermati Non si tratta semplicemente di estensioni scritte male. Il lavoro distingue due archetipi: i Data Thieves, orientati al furto di credenziali e all’esecuzione di codice, e gli Agent Hijackers, che manipolano il comportamento dell’agente attraverso istruzioni avversarie incorporate nei componenti. Il punto architetturale è più importante della percentuale assoluta di skill malevole. Una skill può contenere testo naturale, script ausiliari, procedure operative e istruzioni che l’agente considera attendibili perché il componente è stato deliberatamente installato. Il software tradizionale separa abbastanza chiaramente codice e documentazione; negli ecosistemi agentici quella separazione si indebolisce perché la documentazione stessa può diventare una superficie eseguibile sul piano semantico. Una riga nascosta in una descrizione non deve necessariamente essere interpretata dalla CPU: è sufficiente che venga interpretata dall’LLM e trasformata successivamente in una chiamata a un tool autorizzato. Microsoft aveva già descritto lo stesso problema nel caso del tool poisoning attraverso componenti MCP, dove una descrizione modificata può indirizzare un agente verso l’esfiltrazione di dati utilizzando strumenti e permessi validi. La ricerca sulle skill dimostra però che il problema non appartiene più soltanto ai proof-of-concept. Esiste una supply chain agentica pubblica nella quale componenti distribuiti con una funzione apparentemente utile possono incorporare comportamenti ostili. Per i team di sicurezza questo implica trattare skill, plugin e server collegati agli agenti con controlli comparabili a quelli applicati a pacchetti software, container e dipendenze: provenienza, versionamento, sandbox, verifica delle modifiche, controllo dei privilegi e capacità di revoca.
Leggi anche: Stealthy Memory Injection mostra come una sola email possa contaminare la memoria persistente di un agente AI
Prompt injection e MCP trasformano il linguaggio naturale in un confine di sicurezza
La seconda componente della nuova kill chain riguarda prompt injection e strumenti esterni. Il benchmark Skill-Inject ha costruito 202 coppie tra attacchi e task legittimi per misurare quanto gli agenti resistano a istruzioni malevole contenute nelle skill. In alcune configurazioni i ricercatori hanno misurato tassi di successo dell’attacco fino all’80%, osservando comportamenti che comprendevano esfiltrazione dei dati, operazioni distruttive e azioni assimilabili a ransomware. Il benchmark Skill-Inject sugli attacchi attraverso le skill degli agenti Il dato non significa che l’80% di qualunque agente sia automaticamente compromettibile, perché il risultato dipende da modello, configurazione, task e attacco. Dimostra però che aumentare semplicemente la capacità del modello non elimina il problema: un agente più competente può diventare anche più efficace nell’eseguire una sequenza operativa sbagliata. È qui che il Model Context Protocol assume un ruolo centrale. MCP standardizza il collegamento tra modelli e strumenti, rendendo possibile a un agente scoprire funzioni esterne e utilizzarle in workflow complessi. La stessa standardizzazione crea tuttavia un confine di fiducia aggiuntivo. Microsoft ha mostrato nel giugno 2026 un caso di tool poisoning nel quale la descrizione di uno strumento MCP approvato viene modificata inserendo istruzioni nascoste; l’agente continua a utilizzare un tool regolarmente autorizzato, ma raccoglie informazioni ulteriori e le trasmette attraverso la stessa chiamata che l’organizzazione considera legittima. L’analisi Microsoft sul passaggio degli agenti AI dalla lettura all’azione È una dinamica diversa dalla classica compromissione di una API. Il protocollo può funzionare perfettamente, l’autenticazione può essere valida e il server può trovarsi in allowlist: ciò che cambia è il significato delle istruzioni che l’agente associa allo strumento. Anche per questo i problemi agentici stanno facendo convergere sicurezza applicativa, supply chain e identity security. La domanda non è più soltanto “chi può chiamare questa API?”, ma “chi può influenzare il processo che decide quando chiamarla, con quali argomenti e verso quale destinazione?”.
EchoLeak e CurXecute hanno già trasformato il prompt in una vulnerabilità con CVE
La distanza tra ricerca accademica e vulnerabilità software è ormai abbastanza ridotta da impedire di liquidare il tema come AI safety teorica. EchoLeak, CVE-2025-32711, ha mostrato che una prompt injection indiretta poteva utilizzare una singola email per influenzare Microsoft 365 Copilot e creare un percorso di esfiltrazione dei dati senza richiedere l’apertura manuale del messaggio da parte della vittima. Il caso concatenava bypass dei controlli contro la cross-prompt injection, rendering Markdown e meccanismi di recupero dei contenuti, dimostrando quanto diventi fragile una separazione basata soltanto sulla distinzione tra “istruzione dell’utente” e “dato recuperato”. Lo studio accademico su EchoLeak e CVE-2025-32711 CurXecute, CVE-2025-54135, ha portato il problema ancora più vicino al sistema operativo: nelle versioni vulnerabili di Cursor un attacco poteva concatenare prompt injection indiretta e creazione del file .cursor/mcp.json, arrivando all’esecuzione di codice attraverso un nuovo server MCP. La vulnerabilità è stata corretta nella versione 1.3.9 e classificata con CVSS 8.6. Il record CVE ufficiale di CVE-2025-54135 per Cursor Il precedente era stato analizzato anche nel dossier sulle minacce AI e sulla vulnerabilità CurXecute in Cursor. Questi casi chiariscono la differenza tra un jailbreak e una compromissione agentica. Nel primo caso l’obiettivo può essere ottenere una risposta che il modello dovrebbe rifiutare; nel secondo l’obiettivo consiste nel attraversare i confini di autorizzazione del sistema utilizzando l’agente come interprete e orchestratore. Il modello può non essere tecnicamente compromesso, il codice sottostante può non presentare una classica corruzione della memoria e l’attaccante può non disporre di credenziali valide. È sufficiente che contenuto non fidato entri nel contesto giusto e venga trasformato in azioni attraverso capacità che l’agente possiede già.
La memoria persistente crea persistenza senza malware
La memoria rende il problema ancora più difficile perché spezza la vicinanza temporale tra vettore e impatto. MITRE descrive AI Agent Context Poisoning come la manipolazione del contesto utilizzato dall’agente per modificare risposte e azioni future; la tecnica comprende la contaminazione della memoria persistente e dei thread conversazionali. In pratica, un’informazione introdotta oggi può essere recuperata giorni dopo quando il contenuto originario non è più presente nell’interazione visibile. Microsoft ha evidenziato lo stesso rischio spiegando che la memoria trasforma un sistema stateless in un collaboratore persistente, ma consente anche di piantare informazioni capaci di influenzare il comportamento dopo che l’utente ha perso il contesto dell’origine. L’analisi Microsoft sulla protezione della memoria degli agenti AI Questo meccanismo cambia anche il concetto tradizionale di persistenza. Un malware mantiene l’accesso installando servizi, modificando chiavi di registro, creando task o alterando configurazioni. Un agente può invece conservare una direttiva ostile semplicemente perché la considera una memoria valida. Il lavoro sulla Stealthy Memory Injection ha mostrato come contenuti provenienti da email possano essere utilizzati per contaminare lo stato a lungo termine e riattivare successivamente un comportamento, senza dover ripresentare ogni volta il payload. La difficoltà forense è evidente: analizzare soltanto la richiesta che precede immediatamente l’azione può non rivelare nulla di sospetto. Occorre ricostruire la provenienza delle informazioni presenti nella memoria, quando sono state scritte, quale fonte le ha originate e quali azioni successive hanno utilizzato quello stato. È un problema vicino all’integrità di un database, ma con una complicazione ulteriore: la semantica dell’informazione influenza direttamente il comportamento. La memoria deve quindi avere provenienza, controllo degli accessi, versionamento, audit e possibilità di rollback, esattamente come una configurazione critica.
Il vero problema per i SOC è che l’attacco può sembrare lavoro normale
L’aspetto più asimmetrico della sicurezza agentica non è però la prompt injection in sé. È il fatto che molti indicatori utilizzati dai SOC per distinguere attività lecita e attività ostile perdono potere discriminante. Un agente compromesso può autenticarsi con un’identità prevista, accedere a un repository consentito, leggere documenti che l’utente è autorizzato a consultare e inviare una richiesta HTTPS a un servizio precedentemente approvato. Visto dal firewall, dall’EDR o da una piattaforma IAM, ogni singolo passaggio può essere formalmente corretto. Microsoft descrive esplicitamente questo scenario nel tool poisoning MCP: il tool è autorizzato, la query utilizza i privilegi dell’analista e la destinazione è stata consentita in precedenza, ma la combinazione delle azioni realizza comunque l’esfiltrazione. Lo stesso problema emerge nello studio Agents of Chaos, dove sei agenti autonomi dotati di memoria persistente, email, Discord, filesystem e shell sono stati sottoposti a due settimane di red teaming da venti ricercatori. Il lavoro documenta undici casi rappresentativi comprendenti obbedienza a soggetti non proprietari, divulgazione di informazioni, azioni distruttive, denial of service, consumo incontrollato di risorse, spoofing dell’identità, propagazione di pratiche insicure tra agenti e presa di controllo parziale del sistema. Il paper Agents of Chaos sul red teaming di agenti autonomi La superficie non è quindi semplicemente la somma di LLM, endpoint e API: cresce quando più agenti condividono contesto, memoria e strumenti. Questo rende particolarmente rilevanti i casi recenti in cui Google ha descritto attacchi AI sempre più autonomi capaci di comprimere le finestre disponibili per la risposta difensiva. Per il SOC diventa necessario osservare non soltanto l’accesso ma l’intenzione operativa ricostruibile dalla sequenza delle azioni: quale prompt ha originato la chiamata, quale contenuto esterno è stato introdotto nel contesto, quale tool è stato selezionato, quali parametri gli sono stati passati, quale memoria è stata consultata e quanto dato è stato trasferito.
Continua con:
- OpenAI e il wiki degli agenti mostrano 18.000 messaggi e tecniche per uscire dalla sandbox
- Meta Ads e GitSpawn mostrano come gli agenti AI possano arrivare alla RCE attraverso componenti apparentemente legittimi
Difendere gli agenti significa controllare capacità e azioni prima ancora del modello
La risposta difensiva non può quindi ridursi a costruire un filtro migliore davanti al prompt. Un’organizzazione deve innanzitutto sapere quali agenti possiede, dove vengono eseguiti, quali identità utilizzano, quali server MCP raggiungono, quali skill caricano e quali azioni possono compiere senza approvazione umana. L’inventario diventa il primo controllo perché l’agent sprawl può creare una superficie invisibile alla governance tradizionale. Il secondo livello riguarda la supply chain: skill, plugin, descrizioni, prompt template e tool devono essere trattati come artefatti che possono modificare il comportamento del sistema. Versionamento, firme, publisher affidabili, sandbox e verifica delle modifiche non sono più misure accessorie. Il terzo livello è l’autorizzazione per azione. Il fatto che l’agente possieda una credenziale non dovrebbe significare automaticamente che possa utilizzarla in qualsiasi contesto: inviare dati all’esterno, cancellare file, modificare autorizzazioni, trasferire denaro o avviare processi richiede policy più granulari e, nei passaggi più sensibili, human-in-the-loop. Infine serve una telemetria che le infrastrutture di sicurezza tradizionali raramente raccolgono in modo completo: prompt, provenienza dei contenuti, modifiche della memoria, descrizioni dei tool, invocazioni, parametri e risultati. È questo il passaggio che rende pertinente la tesi di Fratus. Il modello non scompare dalla superficie d’attacco, ma non è più sufficiente proteggerlo come oggetto isolato. Quando all’LLM vengono aggiunte memoria e capacità operative, l’unità di sicurezza diventa l’intero agente. La nuova kill chain nasce proprio nello spazio tra ciò che il sistema è autorizzato a fare e ciò che un attaccante riesce a convincerlo a fare. Per le imprese che stanno distribuendo agenti su sviluppo software, posta, documenti, cloud e processi amministrativi, il rischio non è più soltanto che l’AI dia una risposta sbagliata. È che compia correttamente l’azione sbagliata, usando credenziali valide e strumenti legittimi, abbastanza bene da sembrare lavoro normale.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.