🤖 Cosa cambia
- FireSat punta a individuare incendi di appena 5 × 5 metri e, a regime, a osservare l’intero pianeta ogni 20 minuti.
- Google usa AI e immagini temporali per distinguere incendi pericolosi da falsi positivi come roghi agricoli, ciminiere e altre sorgenti di calore.
- WAXAL, Project Vaani e Amplify costruiscono dati vocali e multimodali locali per portare modelli AI oltre le lingue dominanti del web.
Google Research sta utilizzando l’intelligenza artificiale per risolvere due problemi che hanno la stessa origine: la mancanza di dati sufficientemente precisi. Nel monitoraggio degli incendi, le immagini satellitari tradizionali possono essere troppo vecchie o poco definite per individuare un focolaio quando è ancora controllabile. Nei modelli linguistici, invece, miliardi di contenuti disponibili online rappresentano molto bene inglese e poche altre lingue dominanti, lasciando migliaia di idiomi e dialetti ai margini dell’addestramento. Google sta intervenendo sui due estremi costruendo direttamente ciò che manca: una costellazione satellitare progettata per generare dati sugli incendi e dataset raccolti con comunità locali per insegnare all’AI come parlano realmente le persone. Il modello viene dopo. Prima serve un segnale migliore.
Cosa leggere
FireSat deve vedere un incendio quando misura appena 5 metri per 5
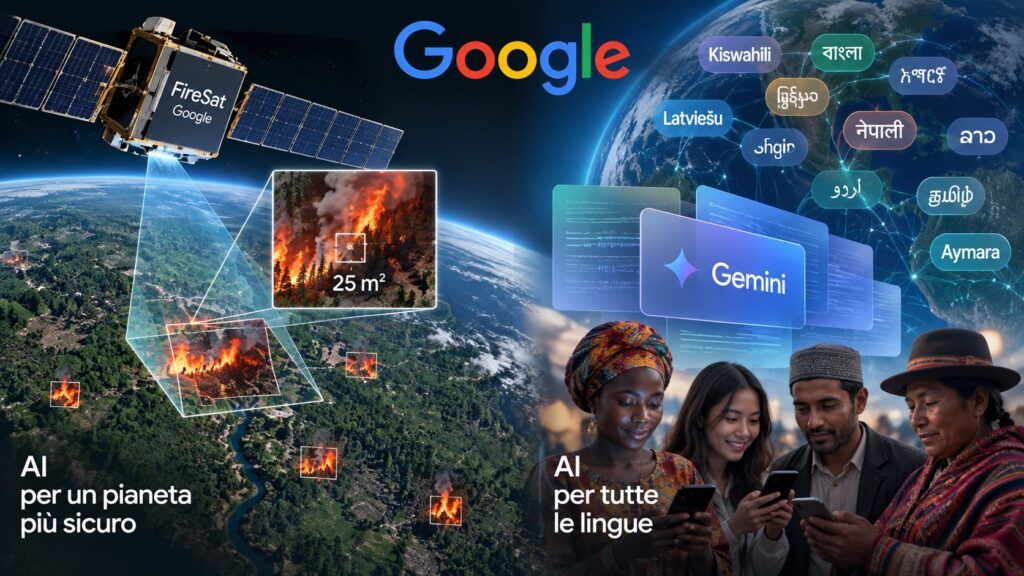
Il progetto più immediatamente rilevante per il Mediterraneo è FireSat, la costellazione sviluppata da Earth Fire Alliance con il contributo di Google Research e Muon Space. Nella ricostruzione pubblicata da Google Research sul rilevamento degli incendi, l’obiettivo viene quantificato con precisione: individuare da orbita bassa un incendio di appena 25 metri quadrati, equivalente a un’area di 5 × 5 metri. La soglia nasce dal confronto con le autorità antincendio, che hanno indicato in circa 50-100 metri quadrati la dimensione alla quale un focolaio può ancora offrire buone possibilità di contenimento. Google ha quindi fissato un obiettivo ancora più aggressivo. Il problema è che un segnale termico così piccolo visto dallo spazio è estremamente difficile da distinguere da ciminiere, riflessi, barbecue, roghi agricoli controllati o altre sorgenti di calore. Utilizzare un satellite enorme e costosissimo con sensori ad altissima risoluzione sarebbe una possibile soluzione; Google e i partner hanno scelto l’approccio opposto: satelliti più piccoli e numerosi, compensando con machine learning ciò che viene perso nella precisione del singolo sensore.
L’AI non deve soltanto vedere il fuoco ma capire quale fuoco conta
La difficoltà reale non è quindi classificare un’immagine come “calda”. FireSat deve comprendere l’evoluzione temporale del segnale. Google ha inizialmente addestrato i modelli facendo volare una nuova fotocamera specializzata sopra incendi controllati, costruendo una base di riferimento di come appare realmente un focolaio dall’alto. Il sistema continua poi a raccogliere immagini di oggetti che potrebbero essere scambiati per incendi e osserva come cambiano nel tempo. È questo confronto temporale a permettere di separare un rogo agricolo stabile da un fronte che sta iniziando a propagarsi. La scelta evidenzia anche il limite dell’AI quando i dati di partenza sono poveri: non esisteva un ground truth sufficientemente dettagliato sugli incendi nelle prime fasi, quindi Google ha dovuto contribuire a costruire contemporaneamente sensori, dataset e modello. La costellazione dovrebbe arrivare a circa 50 satelliti entro il 2030, quando l’obiettivo sarà ottenere una nuova osservazione dell’intero pianeta ogni 20 minuti; nel frattempo Google punta a raggiungere entro circa due anni una copertura globale ogni ora. Per aree mediterranee esposte stagionalmente agli incendi, il vantaggio potenziale non è una previsione astratta del rischio ma tempo operativo aggiuntivo tra l’innesco e la propagazione.
Leggi anche: Google porta Gemini oltre il chatbot e costruisce un’infrastruttura AI distribuita tra servizi e dispositivi
Anche nelle lingue il problema dell’AI nasce prima dell’algoritmo
Lo stesso schema ricompare nel secondo progetto. Google dichiara che le proprie tecnologie linguistiche supportano oggi interazioni in oltre 300 lingue, utilizzate complessivamente da più di 7 miliardi di persone, e che Google Translate è passato dalle poche lingue del 2006 a oltre 250. Ma questi numeri nascondono uno squilibrio fondamentale: il web continua a contenere una quantità sproporzionata di testi e audio nelle lingue dominanti. Addestrare un modello più grande non risolve automaticamente il problema perché un LLM non può imparare sfumature, accenti, code-switching o strutture linguistiche che nel dataset praticamente non esistono. Nell’iniziativa Google per estendere l’AI alle lingue sottorappresentate, l’azienda sposta quindi l’attenzione dal numero di parametri alla costruzione del dato. Il progetto 1,000 Languages Initiative punta alle mille lingue più parlate al mondo, mentre Universal Speech Model è stato addestrato su 12 milioni di ore di audio e utilizza cross-lingual transfer learning per trasferire conoscenza appresa dalle lingue ricche di dati a quelle per cui gli esempi sono molto meno numerosi.
WAXAL e Vaani costruiscono dataset che Internet non può fornire
La parte più interessante riguarda il modo in cui Google sta cercando di colmare questi vuoti. WAXAL è un dataset vocale aperto che comprende 27 lingue dell’Africa subsahariana, parlate da oltre 100 milioni di persone in più di 26 Paesi. Il progetto è stato sviluppato con organizzazioni e università locali per catturare tonalità e ritmi conversazionali che normalmente scompaiono nei corpus costruiti raccogliendo automaticamente contenuti dal web. Project Vaani, sviluppato con Indian Institute of Science e Bhashini, utilizza invece un approccio geografico: non parte dalla lingua dichiarata ma mappa come le persone parlano nelle diverse regioni dell’India. Il progetto ha raccolto finora più di 30.000 ore di parlato in 109 lingue da oltre 155.000 persone. Amplify Initiative aggiunge altri 15.000 datapoint multimodali raccolti attraverso più di 1.600 esperti locali e 20 università distribuite su quattro continenti. Non sono dettagli accessori. Se il dataset nasce da comunità reali anziché da materiale facilmente disponibile online, cambia il tipo di lingua che un modello può imparare: pronuncia, lessico locale, inflessioni e passaggi spontanei tra idiomi diventano parte dell’addestramento anziché rumore da normalizzare.
Gemini passa dall’audio trascritto all’audio compreso direttamente
Google sta contemporaneamente modificando l’architettura utilizzata per lavorare con questi dati. Il tradizionale sistema speech-to-text trasformava la voce in testo, elaborava le parole e solo successivamente generava un nuovo output vocale. Ogni passaggio perdeva una parte dell’informazione originale: tono, pause, emozione, sovrapposizioni e cambi di lingua. Gemini tratta invece l’audio come modalità nativa. Google indica Gemini 3.5 Live Translate come sistema di traduzione parlata in tempo reale per 70 lingue e oltre 2.000 coppie linguistiche, compreso il code-switching, mentre Gemini 3.5 Transcribe lavora direttamente su parlato, rumore e terminologia complessa. È la stessa evoluzione già visibile nella trascrizione multilingue di Gemini 3.5 e nelle funzioni vocali di Rambler, ma il lavoro sulle lingue a basse risorse mostra il requisito che viene prima del modello: senza campioni sufficientemente rappresentativi, anche un sistema audio nativo continua a conoscere molto bene soltanto chi è già rappresentato nei dati.
Continua con:
- TranslateGemma porta modelli di traduzione Google da 4B a 27B su mobile, laptop e cloud
- Gemma 4 E2B sposta modelli multimodali sulle TPU dei Pixel per l’elaborazione locale
FireSat e le lingue mostrano il limite più concreto della corsa ai modelli
Incendi e lingue sembrano due problemi completamente differenti, ma i progetti di Google mostrano lo stesso limite strutturale dell’AI contemporanea. Il modello può inferire soltanto ciò che sensori e dataset gli permettono di osservare. Per FireSat non bastava addestrare meglio una rete neurale sulle immagini satellitari esistenti: servivano nuove fotocamere, una nuova costellazione e osservazioni molto più frequenti. Per le lingue sottorappresentate non basta aumentare il numero di token: servono parlanti, università, raccolte sul territorio e registrazioni capaci di rappresentare il modo in cui quelle comunità comunicano realmente. È questo il valore più interessante dei due programmi. L’AI non viene utilizzata come sostituto del dato, ma come strumento che rende economicamente utilizzabili dati difficili da acquisire. Satelliti piccoli possono competere con sistemi molto più costosi perché il machine learning compensa parte dei limiti del sensore; lingue con pochi contenuti digitali possono entrare nei modelli perché il transfer learning sfrutta strutture apprese altrove senza cancellarne le peculiarità. La lezione vale oltre Google: nella prossima fase dell’intelligenza artificiale il vantaggio potrebbe dipendere sempre meno da chi possiede soltanto il modello più grande e sempre più da chi riesce a costruire il dataset che prima non esisteva.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.