🤖 Cosa cambia
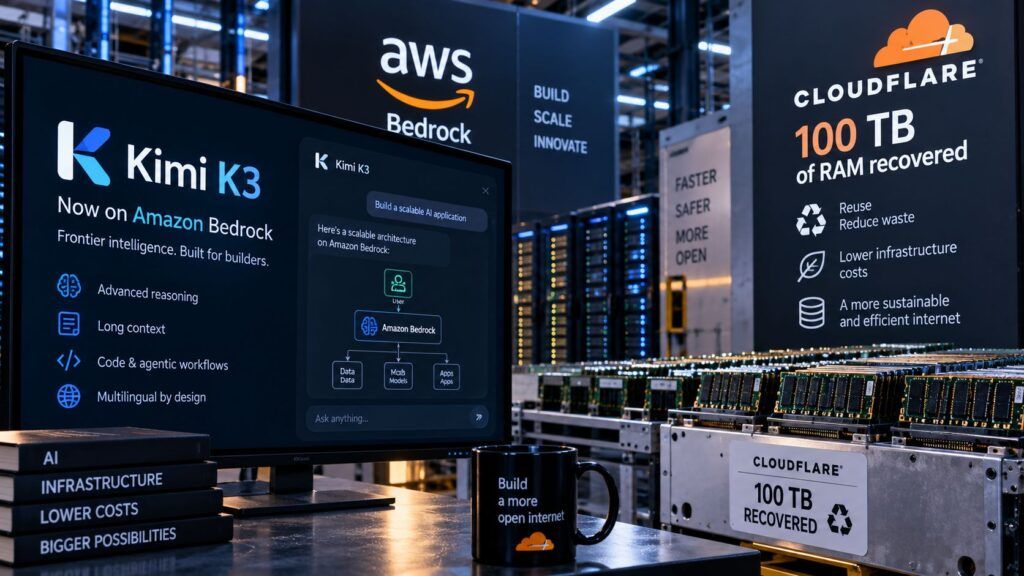
- Kimi K3 arriva su Amazon Bedrock con 2,8 trilioni di parametri, visione nativa, contesto da un milione di token e prompt caching.
- Cloudflare recupera oltre 100 TB di RAM riducendo del 90% gli hash usati dal consistent hashing di Pingora e comprimendo le strutture Rust.
- I due casi mostrano lo stesso principio: l’economia dell’AI dipende tanto dai modelli quanto dall’efficienza con cui cloud e rete utilizzano memoria e compute.
Un modello cinese da 2,8 trilioni di parametri arriva sul cloud americano mentre una delle maggiori infrastrutture Internet del mondo recupera oltre 100 terabyte di memoria eliminando calcolo e strutture dati che non servivano. Kimi K3 di Moonshot AI è ora disponibile su Amazon Bedrock con contesto da un milione di token, capacità visive native e prompt caching. Cloudflare, nello stesso momento storico, ha ridisegnato una parte del consistent hashing utilizzato dal proprio Pingora Backend Router, scoprendo che passare da 100.000 a 10.000 hash per server produceva quasi lo stesso risultato utilizzando una frazione della memoria. Le due notizie sembrano lontane, ma descrivono la stessa battaglia: l’AI può continuare a crescere soltanto se il costo dell’infrastruttura cresce più lentamente delle capacità dei modelli.
Cosa leggere
Kimi K3 usa Bedrock per entrare direttamente nel mercato enterprise occidentale
AWS ha reso Kimi K3 disponibile su Amazon Bedrock dal 18 settembre, presentandolo come il più potente modello open-weight di Moonshot AI e il primo modello aperto dichiarato dall’azienda a raggiungere 2,8 trilioni di parametri. Il modello supporta input testuali e visivi, dispone di una context window da un milione di token e integra explicit prompt caching, caratteristica progettata precisamente per evitare di pagare e ricalcolare ogni volta grandi blocchi di contesto già utilizzati. L’arrivo su AWS completa un percorso iniziato quando Kimi K3 aveva messo in discussione il vantaggio dei modelli occidentali sul rapporto tra costo, apertura e capacità. La scelta di Bedrock porta però il confronto dentro un terreno diverso. Un’azienda occidentale non deve più installare il modello, procurarsi acceleratori o gestire autonomamente il serving: può consumarlo attraverso la stessa infrastruttura utilizzata per Claude, Nova e altri modelli enterprise.
Leggi anche: Kimi K3, chip fotonici e data center: la nuova guerra mondiale per l’AI
Il paradosso è un modello cinese monetizzato attraverso il cloud americano
La relazione industriale è particolarmente interessante nel momento in cui Washington valuta controlli sempre più ampi sull’accesso cinese al compute occidentale. Moonshot può distribuire il proprio modello attraverso AWS e raggiungere aziende globali senza costruire una rete commerciale comparabile a quella di Amazon. AWS guadagna invece workload e consumo infrastrutturale indipendentemente dall’origine geografica del modello. Il modello economico open-weight permette inoltre di separare sempre più chiaramente chi sviluppa l’intelligenza e chi monetizza l’inferenza. Claude Opus aveva già mostrato come Bedrock e Vertex AI potessero trasformare un modello sviluppato da un laboratorio esterno in un prodotto cloud immediatamente disponibile. Con Kimi il meccanismo acquisisce anche una dimensione geopolitica: una società cinese entra nel mercato enterprise mondiale attraverso una delle principali piattaforme americane proprio mentre USA e Cina cercano di ridurre le rispettive dipendenze tecnologiche.
Un milione di token rende il caching una questione economica prima che tecnica
La context window da un milione di token permette di caricare grandi codebase, documentazione, immagini e conversazioni prolungate. Ma ogni token letto dal modello ha un costo computazionale. Prompt caching diventa quindi essenziale: quando un repository o un corpus resta invariato tra richieste successive, Bedrock può riutilizzare parte del lavoro già svolto invece di processarlo nuovamente. Questo principio è ancora più importante negli agenti coding e knowledge workflow, dove la stessa base documentale può essere interrogata centinaia di volte. Il problema era già evidente quando AWS aveva iniziato a spostare AgentCore, Bedrock e SageMaker verso workload agentici persistenti. Un modello più intelligente ma incapace di riutilizzare efficientemente il proprio contesto può diventare economicamente peggiore di un modello leggermente inferiore ma molto più economico da servire.
Cloudflare scopre che 90.000 hash per server non stavano quasi comprando nulla
Cloudflare affronta la stessa equazione a un livello completamente diverso della pila. Il team Performance ha individuato un consumo eccessivo di memoria nel Pingora Backend Router e ha analizzato pingora-ketama, la libreria usata per il consistent hashing delle richieste cacheabili. Il sistema assegnava fino a 100.000 hash virtuali a un singolo server per ottenere una distribuzione uniforme del traffico. L’analisi statistica ha mostrato però che gli ultimi 90.000 hash riducevano l’errore di appena lo 0,7% e, con hash a 32 bit, aumentavano persino il rischio di collisioni.
Cloudflare ha quindi ridotto del 90% il numero di hash e contemporaneamente compattato la struttura dati che associa hash e server. L’indice del server non richiedeva 32 bit, perché nessun data center possiede 65.000 backend: poteva essere rappresentato con 16 bit. Rust introduceva però padding di allineamento, quindi gli ingegneri hanno utilizzato una rappresentazione byte-array capace di portare la struttura reale da otto a sei byte. Su miliardi di entry, due byte diventano terabyte.
Cento terabyte dimostrano perché l’ottimizzazione software vale ormai quanto nuovo hardware
Il risultato combinato è oltre 100 TB di RAM recuperati nella rete globale, oltre ad altri 100 TB che il team DNS aveva liberato il mese precedente. Il dato è particolarmente significativo in un mercato nel quale HBM, DRAM e capacità server vengono assorbite dalla crescita dei data center AI. Cloudflare non ha costruito una nuova fab, non ha acquistato nuovi DIMM e non ha aspettato una generazione di hardware: ha semplicemente dimostrato matematicamente che una parte della memoria già installata non produceva valore. È una lezione importante anche per l’AI. L’industria discute continuamente di più GPU, più memoria e più megawatt, ma una quota crescente del vantaggio competitivo verrà da quanto compute può essere evitato. Prompt caching, quantizzazione, kernel migliori, routing, consistent hashing e strutture dati più compatte possono liberare risorse equivalenti a interi cluster.
Continua con:
SK Hynix investe 24,3 miliardi mentre la memoria HBM resta il collo di bottiglia dell’AI
Kimi K3 mette in crisi il mito dell’AI occidentale sul rapporto tra capacità e costo
La prossima guerra AI sarà anche una guerra contro lo spreco
Kimi K3 e Cloudflare mostrano quindi due estremi dello stesso sistema. Moonshot costruisce modelli sempre più grandi e AWS cerca di renderli economicamente utilizzabili attraverso caching e infrastruttura condivisa. Cloudflare parte dall’infrastruttura e scopre che centinaia di terabyte possono essere recuperati interrogando assunzioni tecniche accumulate negli anni. Questa dinamica diventerà sempre più importante. Se ogni aumento di capacità dei modelli richiedesse un incremento proporzionale di GPU, memoria, energia e rete, la crescita dell’AI incontrerebbe rapidamente un limite fisico ed economico. L’unica alternativa è fare di più con la stessa macchina. La frontiera non sarà quindi definita soltanto da chi costruisce il modello con più parametri, ma da chi riesce a evitare di spendere memoria, token e watt dove non producono intelligenza utile.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.