☁️ Punti chiave
- Reactiv, Trane e Tata Elxsi mostrano AgentCore applicato a commercio, edifici e sicurezza industriale invece che a semplici demo conversazionali.
- SageMaker automatizza i concurrency sweep per individuare il massimo throughput compatibile con i requisiti di latenza degli endpoint generativi.
- MSK e Athena rafforzano contemporaneamente il livello dati, perché agenti e modelli in produzione dipendono da pipeline prevedibili e scalabili.
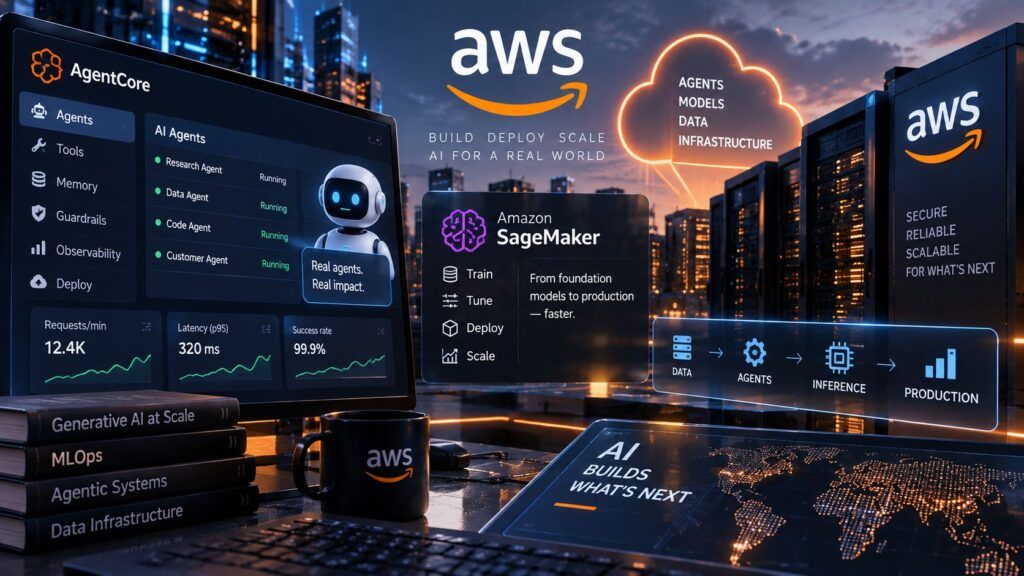
Amazon Web Services sta portando l’AI agentica fuori dalla fase nella quale il problema principale era costruire una buona demo e dentro quella molto meno spettacolare, ma decisiva, dell’esecuzione in produzione. I nuovi casi pubblicati su Amazon Bedrock AgentCore mostrano agenti che modificano applicazioni commerciali, interrogano dati di edifici, supportano analisi per il settore pubblico e identificano rischi industriali; parallelamente SageMaker AI automatizza il dimensionamento della concorrenza degli endpoint generativi, mentre MSK e Athena intervengono sul livello dati. Il filo comune non è il modello utilizzato, ma l’infrastruttura necessaria affinché un sistema AI possa funzionare continuamente, mantenere stato, accedere agli strumenti, rispettare vincoli di latenza e non trasformare GPU, Kafka e data lake in colli di bottiglia separati.
Cosa leggere
AgentCore passa dagli agenti dimostrativi ai processi che modificano sistemi reali
Il caso più indicativo riguarda Reactiv, piattaforma per il mobile commerce che utilizza Amazon Bedrock AgentCore per automatizzare la manutenzione delle applicazioni dei merchant. Nel caso tecnico pubblicato da AWS l’agente analizza catalogo e metriche, decide quali contenuti evidenziare e genera una nuova configurazione dell’applicazione, lasciando però l’approvazione finale al merchant.
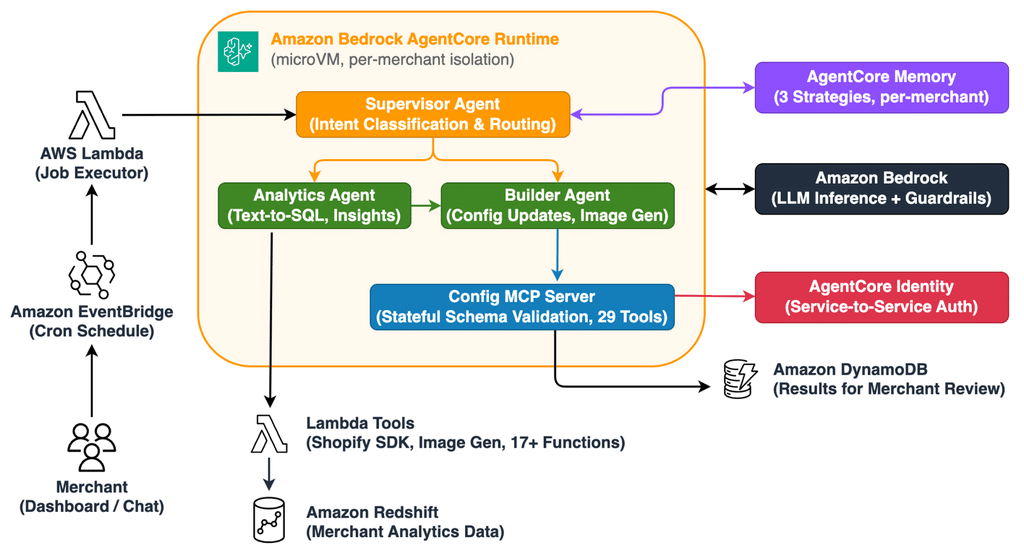
L’architettura utilizza agenti specializzati, memoria persistente e un server MCP che espone schema e regole della configurazione: il modello non produce quindi semplicemente JSON plausibile, ma opera contro una struttura che definisce ciò che l’applicazione può realmente accettare. Lo stesso spostamento dalla conversazione all’azione compare nel caso Trane, dove AgentCore viene applicato all’analisi dei dati degli edifici, e nel progetto Tata Elxsi dedicato alla rilevazione rapida di situazioni di rischio industriale. È la prosecuzione del percorso già visibile quando AWS aveva portato AgentCore, Quick e Codex dentro il ciclo software enterprise: il punto non è più dimostrare che un agente sa chiamare un tool, ma costruire runtime, identità, isolamento e controllo sufficientemente solidi da lasciargli eseguire operazioni reali.
Leggi anche: AWS Agent Registry governa agenti, skill e server MCP dentro lo stack enterprise
SageMaker misura il punto oltre il quale più concorrenza peggiora il servizio
Quando gli agenti diventano workload continui emerge immediatamente il problema economico dell’inferenza. Aumentare il numero di richieste concorrenti migliora il throughput soltanto fino al punto in cui GPU, memoria e runtime iniziano ad accumulare code e a degradare la latenza. AWS affronta questa fase con i nuovi concurrency sweep per gli endpoint generativi di SageMaker AI, pensati per testare progressivamente differenti livelli di concorrenza e identificare la configurazione che soddisfa gli obiettivi di servizio. Il principio è semplice ma importante: dimensionare un endpoint LLM soltanto attraverso l’utilizzo medio della GPU rischia di nascondere il vero collo di bottiglia, perché time to first token, throughput, latenza di coda e concurrency interagiscono tra loro.
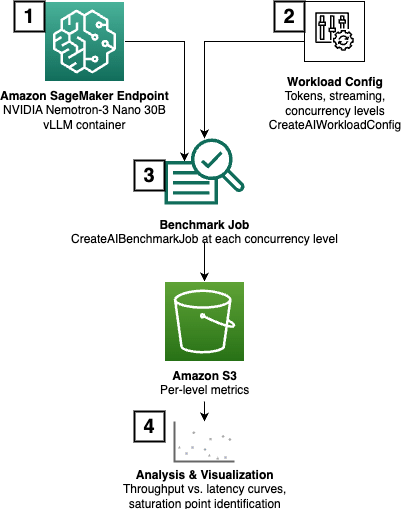
AWS aveva già spostato SageMaker in questa direzione con instance pool, ottimizzazione delle GPU e strumenti di osservabilità. L’analisi su GPT-6 Astra, AgentCore e SageMaker aveva mostrato come il costo dell’AI enterprise dipenda sempre meno dal semplice prezzo nominale del modello e sempre più dalla capacità di saturare correttamente l’hardware senza compromettere gli SLA. I concurrency sweep rendono questa scelta misurabile prima che il dimensionamento sbagliato diventi una fattura ricorrente.
Il livello dati resta il collo di bottiglia che gli agenti non possono eliminare
La stessa giornata di aggiornamenti AWS interviene anche sotto il runtime AI. Le nuove best practice per scalare grandi consumer group su Amazon MSK affrontano coordinamento, rebalance e distribuzione delle partizioni nei workload Kafka estesi, mentre il modello adottato da Moeve per standardizzare dbt su Amazon Athena prova a rendere prevedibile l’esecuzione delle trasformazioni SQL distribuite sui data lake. Sono aggiornamenti apparentemente lontani da AgentCore, ma diventano essenziali quando l’agente deve interrogare dati operativi aggiornati, concatenare strumenti e prendere decisioni sulla base di informazioni che arrivano da sistemi differenti. La strategia era già evidente nel precedente dossier su AWS, AgentCore, SageMaker e Kafka come piattaforma enterprise integrata. Un agente affidabile non compensa una pipeline dati instabile e un modello veloce non elimina i problemi di partizionamento, lineage o trasformazione. L’AI agentica sta quindi aumentando il valore dell’infrastruttura sottostante invece di renderla irrilevante.
Continua con:
AWS governa gli agenti AI con policy, architetture aperte e controllo dei costi
AWS industrializza l’AI enterprise tra Quick, Bedrock multimodale e SageMaker
AWS sta vendendo soprattutto il livello operativo dell’intelligenza artificiale
Anche il progetto per estendere l’intelligence del settore pubblico attraverso Agentforce e AWS conferma la stessa traiettoria: modelli e agenti vengono inseriti sopra identità, dati, strumenti e infrastrutture già governate, invece di essere trattati come applicazioni autonome. È qui che AWS prova a costruire il proprio vantaggio competitivo. Il foundation model può arrivare da Amazon, Anthropic, OpenAI o da un progetto open-weight; il valore che il cloud provider vuole trattenere è l’ambiente nel quale quel modello viene eseguito, osservato, autorizzato, collegato ai dati e dimensionato economicamente. AgentCore offre runtime, memoria e accesso agli strumenti; SageMaker misura e ottimizza l’inferenza; MSK alimenta flussi continui; Athena e dbt rendono interrogabile il patrimonio dati. I casi Reactiv, Trane e Tata Elxsi sono importanti proprio perché mostrano cosa accade quando questi livelli smettono di essere servizi separati. L’agente AI utile in produzione non è il chatbot più brillante, ma un processo software che deve restare disponibile, prevedibile, auditabile e abbastanza economico da poter essere eseguito ogni giorno. È su questo terreno, molto più che sulla classifica del modello del mese, che AWS sta costruendo la propria infrastruttura per l’AI enterprise.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.