🛡️ Executive Summary
- Truffle Security ha trovato 543.699 credenziali ancora valide analizzando The Stack v3, dataset di oltre 224 milioni di repository pubblici GitHub.
- Quasi 200mila credenziali sono state pubblicate dopo l’attivazione predefinita della push protection GitHub, mostrando i limiti dei controlli automatici.
- La presenza dei secret nei corpus AI trasforma una cattiva pratica DevSecOps in un problema persistente di supply chain e governance dei dataset.
Le credenziali dimenticate nei repository GitHub non restano necessariamente confinate nel codice pubblico. Possono essere copiate dentro dataset destinati all’addestramento dell’intelligenza artificiale, distribuite come corpus e sopravvivere per anni anche quando il repository originale viene modificato. Il CERT-AgID ha richiamato l’attenzione sul problema delle credenziali GitHub presenti nei dataset per l’AI, ma la dimensione reale emerge dalla ricerca tecnica che ha originato il caso: Truffle Security ha analizzato The Stack v3, snapshot di codice pubblico costruito per il training dei modelli, trovando oltre mezzo milione di credenziali che risultavano ancora funzionanti mesi dopo la chiusura del crawl.
Cosa leggere
The Stack v3 contiene 543.699 credenziali che rispondevano ancora ai provider
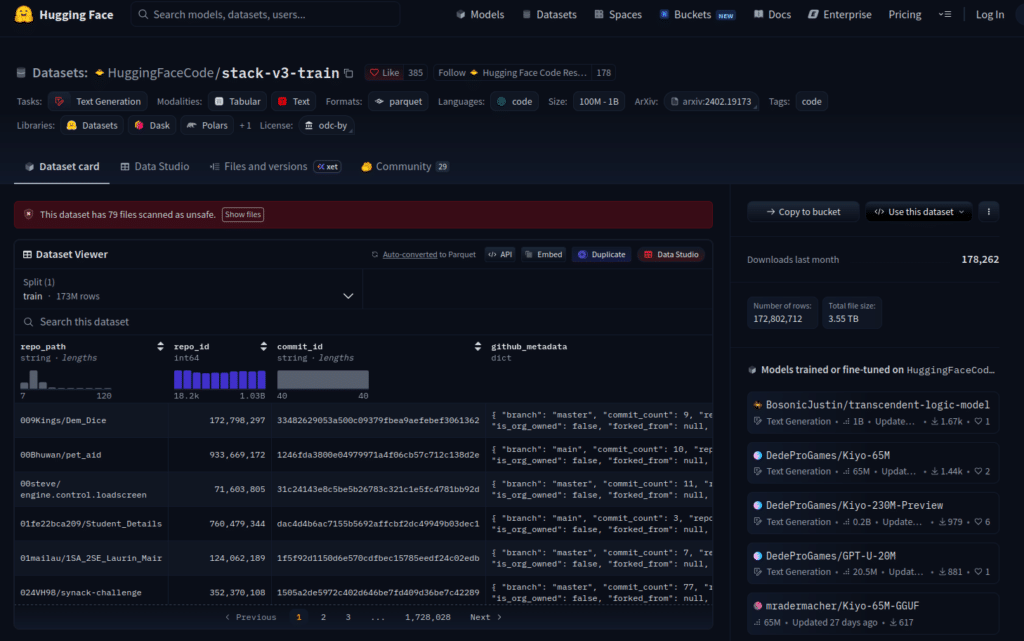
La ricerca originaria di Truffle Security ha analizzato tutti i 4.096 shard di The Stack v3, per un totale di 224.553.295 repository pubblici GitHub e 58.467.468.698 file. Il crawl del dataset si era concluso il 7 agosto 2025; tra il 27 e il 28 luglio 2026 i ricercatori hanno verificato le credenziali individuate interrogando i servizi che le avevano emesse. 543.699 risultavano ancora valide, non semplicemente presenti come stringhe riconducibili a una chiave. L’età mediana era di 784 giorni, il 90° percentile superava i sei anni e la credenziale più vecchia risultava associata a un file modificato nel 2009.
Il dato cambia completamente il significato del leak: non si parla di secret storici già revocati, ma di token e chiavi che continuavano a poter autenticare richieste. Il problema delle grandi raccolte di credenziali non è nuovo, ma il caso dei 16 miliardi di account aggregati da precedenti infostealer e leak aveva già mostrato quanto sia essenziale distinguere tra semplice presenza in un dataset e credenziale realmente utilizzabile.
Leggi anche: Shai-Hulud trasforma npm, GitHub e Grafana in una crisi della supply chain
Il dataset AI rende persistente ciò che lo sviluppatore pensava di aver cancellato
The Stack v3 conserva lo stato del default branch al momento del crawl, senza la storia completa dei commit. Questo significa che un secret incluso in un file pubblico in quel momento può essere copiato nel corpus anche se successivamente viene eliminato dal repository GitHub. Da quel momento la revoca della chiave resta l’unica misura realmente efficace: cancellare il file o riscrivere la repository history non elimina automaticamente le copie già finite nei dataset.
È qui che il rapporto tra AI e sicurezza della supply chain cambia natura. Il dataset non crea la vulnerabilità iniziale, che nasce dalla pubblicazione della credenziale, ma ne prolunga la distribuzione fuori dal contesto originario. La stessa dinamica è già visibile negli attacchi supply chain nei quali token CI/CD e segreti cloud vengono raccolti automaticamente: Shai-Hulud ha compromesso i pacchetti TanStack sfruttando pipeline e token OIDC, mentre AgentBaiting utilizza repository GitHub costruiti appositamente per colpire strumenti e agenti AI. Il corpus di training diventa quindi un ulteriore livello della stessa catena.
La push protection riduce il problema ma non riconosce oltre metà dei secret vivi
Il dato più problematico riguarda i controlli automatici. Dei 543.699 secret ancora validi, 245.959 erano precedenti alla disponibilità gratuita degli alert GitHub, 97.897 erano stati pubblicati nel periodo in cui secret scanning e push protection erano disponibili ma non attivi per tutti e 199.843, pari al 36,8%, erano stati inseriti dopo che GitHub aveva reso la push protection predefinita nel febbraio 2024. Truffle Security conclude che il blocco funziona per i pattern riconosciuti, dimezzandone approssimativamente la frequenza di pubblicazione, ma il 51,8% delle credenziali ancora valide appartiene a formati che il sistema non riconosce. Il problema non è quindi che la protezione sia inutile, ma che nessun pattern matching può coprire tutte le forme assunte da API key, token proprietari, password e secret applicativi. Gli attacchi alla supply chain GitHub Actions contro SpotBugs, reviewdog e tj-actions hanno già dimostrato quanto una singola credenziale CI/CD possa amplificare la compromissione attraverso repository e workflow apparentemente affidabili.
Continua con:
Sandworm Mode mostra come npm, AI e MCP condividano ormai la stessa superficie di attacco
Il malware Shai-Hulud cerca segreti tra GitHub, cloud e strumenti AI
Il rischio vero non è che il modello “impari la password”, ma che il secret continui a circolare
La segnalazione del CERT-AgID porta quindi in primo piano un problema che va oltre GitHub. È improprio concludere automaticamente che un modello addestrato su The Stack v3 possa riprodurre una determinata credenziale: la presenza nel corpus non dimostra memorizzazione né possibilità di estrazione dal modello. Il rischio documentato è precedente e più concreto. Credenziali ancora attive vengono duplicate all’interno di dataset enormi, redistribuiti e utilizzati in pipeline di training, rendendo molto più difficile sapere quante copie esistano dopo la prima esposizione. Una volta pubblicato un secret, la bonifica non dovrebbe quindi fermarsi alla cancellazione dal repository: occorre considerarlo compromesso e revocarlo. L’AI rende semplicemente evidente una vecchia debolezza DevSecOps: il codice pubblico non è più soltanto indicizzato da motori di ricerca o clonato da altri sviluppatori, ma può diventare materia prima di infrastrutture che conservano e riutilizzano il contenuto su scala industriale. La vera unità di sicurezza non è più il repository, ma l’intero ciclo di vita del dato che dal repository viene copiato, indicizzato, trasformato e incorporato in altri sistemi.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.