📌 In Sintesi
- Google presenta Gemini 4 Argon come modello frontier con il 77,9% su DeepSWE v1.1 e un limite record di un milione di token in output.
- Fonti interne citate da Bloomberg sostengono però che alcuni risultati dei benchmark non si traducano con la stessa efficacia nei task di coding reali; Google respinge questa interpretazione.
- Epoch AI calcola intanto che il costo necessario per ottenere uno stesso livello di prestazione AI sia diminuito del 47% a trimestre dal 2023, circa tredici volte ogni anno.
Google ha appena rimesso Gemini 4 Argon al centro della corsa dei modelli frontier, ma il dato più interessante non è soltanto il 77,9% ottenuto nei test di software engineering o il milione di token disponibili in output. Quasi contemporaneamente alla presentazione, fonti interne citate da Bloomberg hanno sollevato dubbi sulla capacità del modello di replicare nel lavoro quotidiano alcune delle prestazioni mostrate nei benchmark, soprattutto nel coding. La contraddizione arriva mentre un rapporto di Epoch AI misura un fenomeno ancora più importante per il mercato: ottenere uno stesso livello di “intelligenza” da un modello costa oggi circa il 47% in meno ogni trimestre, una velocità di riduzione superiore a quella osservata storicamente per capacità di calcolo, batterie agli ioni di litio e sequenziamento del DNA. La nuova competizione non riguarda quindi soltanto chi occupa il primo posto nei benchmark, ma quanto costa trasformare quel punteggio in lavoro utile.
Cosa leggere
Google presenta Gemini 4 come modello frontier da un milione di token
Google ha annunciato Gemini 4 Argon il 30 settembre descrivendolo come il nuovo modello frontier per software engineering, lavoro professionale e cybersecurity, con accesso inizialmente limitato a un gruppo di cyber defender selezionati attraverso il programma Fairwind prima dell’apertura a sviluppatori, imprese e utenti. La presentazione ufficiale di Google attribuisce ad Argon il 77,9% su DeepSWE v1.1, benchmark dedicato a task software di lunga durata, il 68% su CWE-bench v1 per la correzione delle vulnerabilità e soprattutto un limite di output portato da 64.000 a un milione di token, dimensione che permette al modello di mantenere traiettorie agentiche estremamente lunghe senza interrompere continuamente il lavoro. Google sostiene inoltre di utilizzare già Argon internamente per migrazioni di grandi codebase C/C++ verso Rust, ottimizzazioni della memoria nei data center e attività di ricerca quantistica, affermazioni che Matrice Digitale ha già analizzato nel pezzo sul debutto di Gemini 4 Argon con un milione di token e coding al 77,9%. Il prezzo iniziale di 2 dollari per milione di token in input e 10 dollari in output salirà successivamente a 4 e 20 dollari, quindi Google sta cercando di combinare capacità frontier e pressione competitiva sul costo prima ancora di distribuire Argon su larga scala.
Leggi anche: Gemini 3.8 Flash accelera il coding e Google apre l’AI cyber ai difensori
Bloomberg racconta una distanza tra benchmark e lavoro quotidiano
Il quadro diventa meno lineare fuori dalle slide ufficiali. Una inchiesta di Bloomberg News firmata da Julia Love e Davey Alba riferisce che dipendenti con accesso diretto a Gemini 4 avrebbero osservato prestazioni meno convincenti quando il modello viene utilizzato nel lavoro reale, con difficoltà su alcuni task di programmazione nonostante i risultati ottenuti nei benchmark; la stessa ricostruzione è stata ripresa da 9to5Google. Google contesta questa lettura e sostiene che sarebbe inesatto parlare di sottoperformance nel coding, mentre altre fonti interne citate da Bloomberg descrivono un consenso significativo sul fatto che Argon appartenga effettivamente alla frontiera tecnologica. Non esiste quindi una dimostrazione che Gemini 4 “fallisca” nel coding: esiste una divergenza documentata tra la valutazione aziendale, alcuni risultati standardizzati e le impressioni raccolte tra persone che lo hanno già utilizzato internamente. È una distinzione essenziale perché un benchmark come DeepSWE tenta proprio di avvicinarsi al lavoro software reale, ma resta comunque un ambiente misurabile, ripetibile e delimitato, mentre uno sviluppatore può richiedere a un agente di comprendere repository irregolari, dipendenze, convenzioni interne e obiettivi ambigui che nessuna singola percentuale riesce a rappresentare completamente.
Il problema dei benchmark cresce insieme alla qualità dei modelli
Più i modelli si avvicinano tra loro nelle classifiche, più diventa difficile interpretare pochi punti percentuali come una differenza assoluta di qualità. Epoch AI richiama esplicitamente anche il rischio di “benchmaxxing”, cioè la possibilità che sviluppo, fine-tuning e selezione dei modelli vengano progressivamente ottimizzati sui benchmark che l’industria utilizza per definirne il valore, producendo risultati eccellenti che non necessariamente scalano nello stesso modo su distribuzioni di problemi differenti.
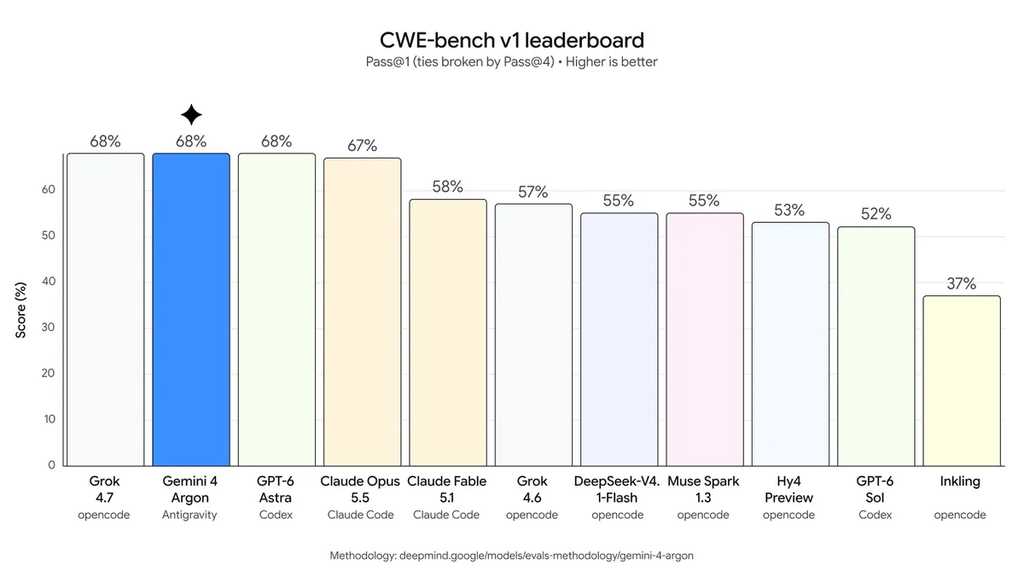
Questo non significa che Google abbia addestrato Gemini 4 per manipolare DeepSWE o che il risultato del 77,9% sia privo di valore, ma che il mercato ha raggiunto una fase in cui il punteggio isolato racconta sempre meno: contano affidabilità delle traiettorie agentiche, capacità di recuperare da un errore, costo per task completato e quantità di supervisione umana necessaria. La distanza è particolarmente importante nel coding perché un modello può produrre codice formalmente corretto in un test e diventare molto meno efficace quando deve mantenere coerenza su centinaia di migliaia di righe o interagire con strumenti esterni, problema già visibile nella transizione raccontata da Matrice Digitale da Gemini 3.6 Flash al modello Cyber per CodeMender: il valore non è più la singola risposta, ma la capacità di completare un processo.
L’intelligenza costa il 47% in meno ogni trimestre
Mentre Google, OpenAI e Anthropic competono sui benchmark, Epoch AI misura una trasformazione economica ancora più radicale. Nel rapporto The plunging price of thought, Luke Emberson e David Roodman hanno confrontato il costo necessario per raggiungere livelli equivalenti di performance su cinque benchmark di matematica, scienza e giochi, calcolando che dal 2023 il prezzo è diminuito mediamente del 47% ogni trimestre, equivalente a circa tredici volte in un anno.
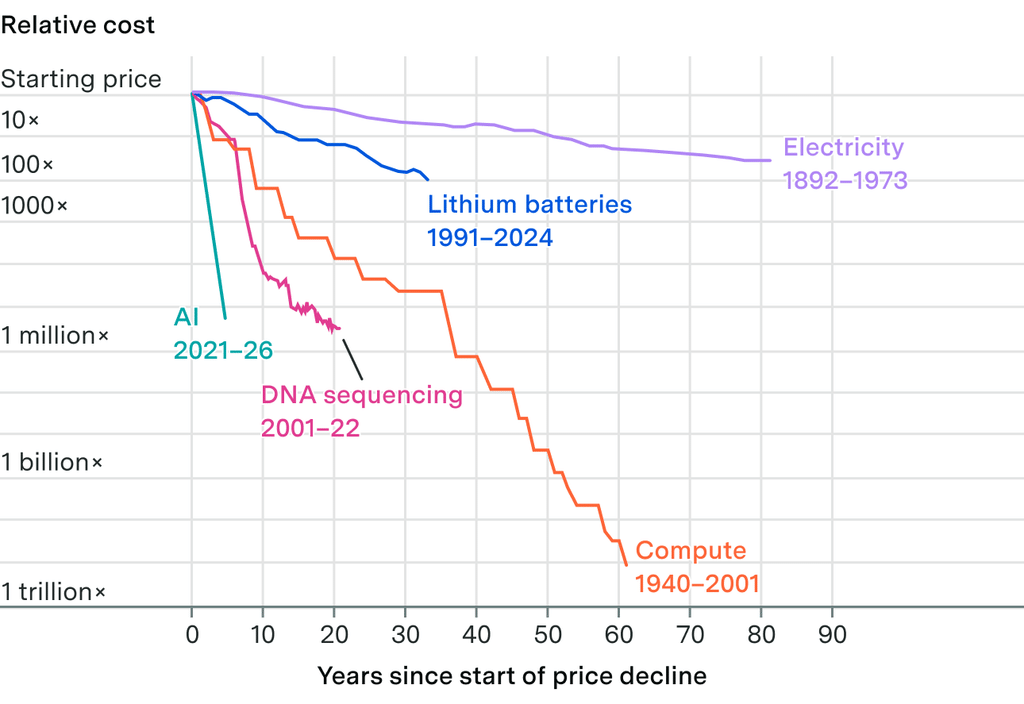
Secondo Epoch, il ritmo è quattro volte superiore alla riduzione storica del costo del sequenziamento del DNA, sei volte a quella del computing, diciotto volte alle batterie al litio e cinquantaquattro volte all’elettricità nel periodo considerato. Per le capacità vicine allo stato dell’arte il calo arriva inizialmente al 66% trimestrale, pari a circa 75 volte l’anno, anche se due anni dopo la velocità scende al 32%. Il dato non significa che chip, energia o data center siano diventati economici: al contrario, questi input possono continuare a rincarare. Significa che architetture, inferenza, concorrenza tra provider e ottimizzazione software permettono di acquistare una determinata capacità cognitiva a un prezzo che diminuisce molto più rapidamente del costo fisico dell’infrastruttura che la produce.
Continua con:
OpenAI Dots gira su VM AMD EPYC a 9 core: il costo nascosto degli agenti AI
La bolla dell’intelligenza artificiale e il rischio sistemico di Nvidia
Se l’AI costa tredici volte meno ogni anno il benchmark vale ancora meno
La combinazione tra Gemini 4 ed Epoch AI suggerisce quindi un cambiamento di metrica per tutta l’industria. Se modelli diversi raggiungono prestazioni sempre più vicine e il costo per ottenere quelle capacità diminuisce di un ordine di grandezza ogni anno, il vincitore non è necessariamente il modello con il punteggio assoluto più alto, ma quello che completa più lavoro affidabile per euro, watt e minuto impiegato. Per Google questo rende particolarmente importante dimostrare che il milione di token di Argon e il 77,9% di DeepSWE producano vantaggi misurabili fuori dal benchmark; per imprese e sviluppatori significa invece che vincolarsi troppo presto a un modello premium può diventare economicamente discutibile quando un concorrente raggiunge pochi mesi dopo capacità simili a una frazione del prezzo. La corsa dei frontier model non sta rallentando, ma il valore economico dell’intelligenza sta precipitando molto più rapidamente del costo delle infrastrutture che la sostengono: ed è proprio questa divergenza, più del primato temporaneo su una classifica, a decidere chi riuscirà davvero a trasformare l’AI in una piattaforma sostenibile.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.