📌 In Sintesi
- UCLA ha sviluppato un sistema ibrido digitale-ottico che analizza almeno 15 video contemporaneamente usando la propagazione fisica della luce per parte dell’inferenza.
- Il prototipo raggiunge il 97,79% di accuratezza, il 99,86% di sensibilità e il 95,72% di specificità su Celeb-DF; con 18 video simultanei l’accuratezza scende al 96,13%.
- Il valore principale non è soltanto riconoscere i deepfake, ma creare un primo filtro ad alta capacità, energeticamente efficiente e più difficile da replicare per costruire attacchi adversariali.
Il problema dei deepfake sta cambiando natura: non basta più costruire un classificatore capace di distinguere un video falso da uno autentico, perché i sistemi generativi possono produrre contenuti su una scala che rende proibitivo analizzarli uno alla volta con reti neurali sempre più pesanti. Un gruppo della University of California, Los Angeles ha quindi spostato una parte dell’inferenza dall’elettronica alla luce, realizzando un’architettura ibrida nella quale un encoder digitale comprime le informazioni dei video e un decoder ottico esegue simultaneamente la classificazione di almeno 15 flussi attraverso la propagazione fisica di un fronte d’onda. Il risultato sperimentale arriva al 97,79% di accuratezza sul dataset Celeb-DF e punta soprattutto a un obiettivo diverso dalla semplice corsa alla percentuale più alta: filtrare grandi volumi di contenuti prima di inviare soltanto quelli sospetti verso sistemi digitali più costosi.
Cosa leggere
Il deepfake detector sposta l’inferenza dalla GPU alla propagazione della luce
Il lavoro, pubblicato il 22 settembre 2026 su eLight con il titolo Scalable, energy-efficient optical-neural architecture for multiplexed deepfake video detection, è firmato da Parnian Ghapandar Kashani, Shiqi Chen e Aydogan Ozcan e combina un front-end digitale leggero con un decoder analogico ottico. L’encoder estrae dai video informazioni spaziali, spettrali e temporali e le converte in una configurazione di fase caricata su uno spatial light modulator; il campo ottico così generato attraversa poi un sistema di propagazione in spazio libero e raggiunge coppie di fotodetettori che producono direttamente il punteggio di autenticità.
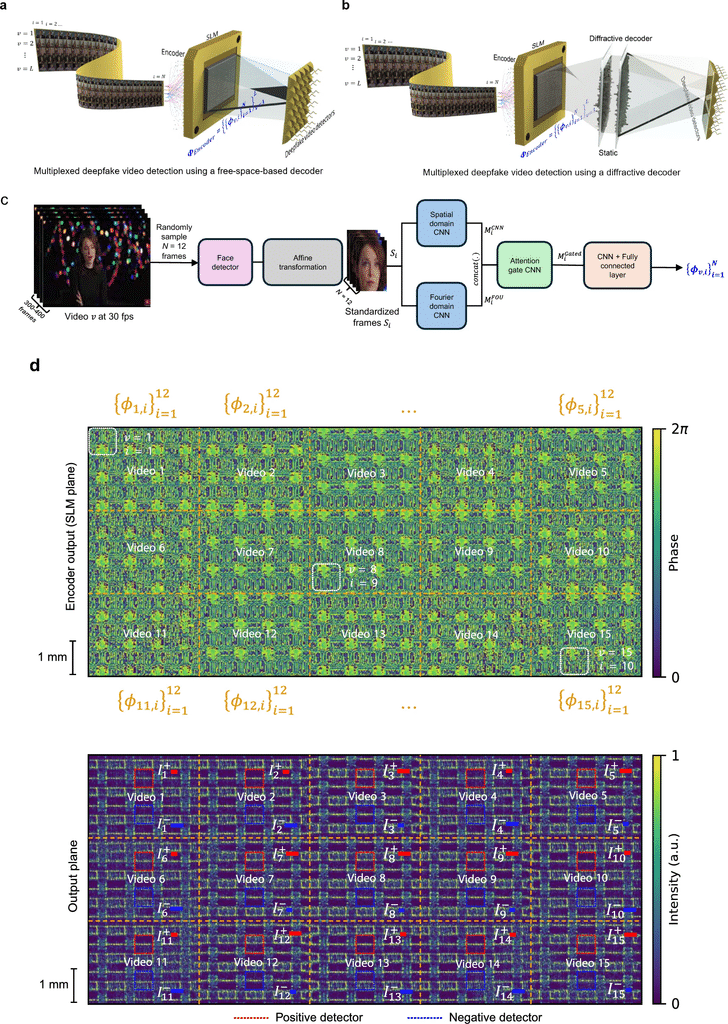
Il vantaggio è che i flussi non devono essere elaborati necessariamente in sequenza: nel prototipo 15 video vengono multiplexati e classificati nello stesso passaggio ottico, mentre l’aumento della capacità dipende soprattutto dalla superficie ottica disponibile e dalla gestione del cross-talk tra i diversi canali. In questo senso il progetto non propone di sostituire completamente GPU e reti neurali tradizionali, ma di spostare fisicamente fuori dal dominio digitale una parte del calcolo che oggi rende costoso verificare milioni di contenuti generati o manipolati.
Leggi anche: IdentifAI e Alto Intelligence uniscono rilevamento deepfake e threat intelligence cognitiva
Il 97,79% conta meno del 99,86% di sensibilità
Nei test sperimentali sul dataset Celeb-DF il sistema ha ottenuto 97,79% di accuratezza media, 99,86% di sensibilità e 95,72% di specificità analizzando 15 video contemporaneamente; il dato più importante per un sistema progettato come filtro di primo livello è proprio la sensibilità, perché implica un tasso medio di falsi negativi vicino allo 0,14%, riducendo la probabilità che un contenuto manipolato venga classificato direttamente come autentico. Portando il multiplexing a 18 video l’accuratezza sperimentale scende al 96,13%, un deterioramento che i ricercatori collegano anche all’aumento del cross-talk ottico tra canali e che mostra come la scalabilità non sia gratuita.
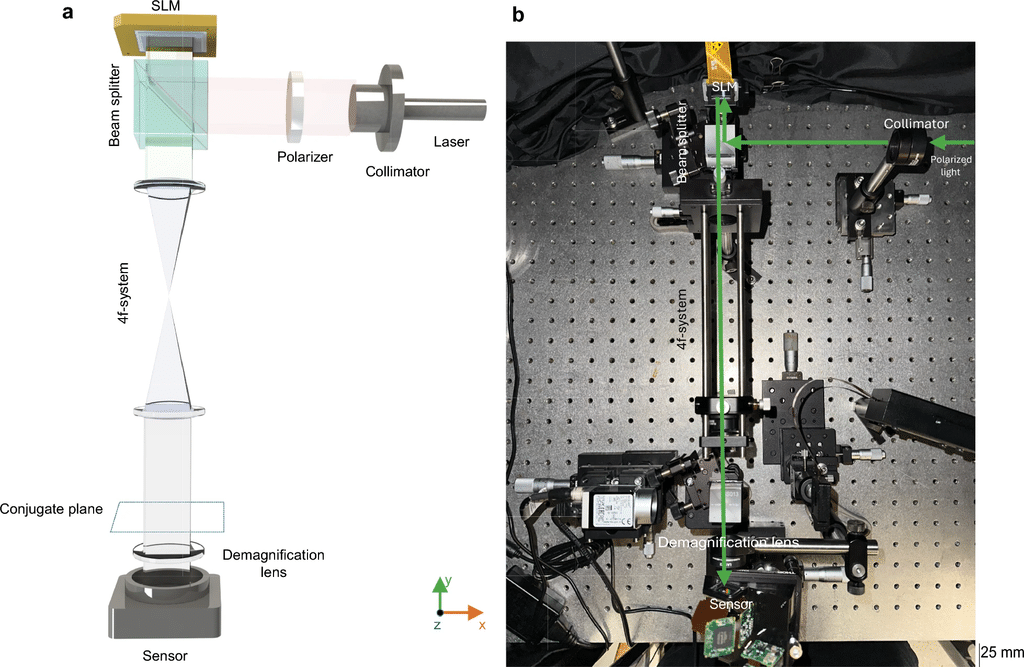
a Schema della configurazione sperimentale per il rilevamento di video deepfake multiplexato con decodificatore basato sullo spazio libero. La luce laser collimata illumina l’SLM dopo essere stata deviata dal divisore di fascio. Successivamente, viene applicato un sistema 4f per coniugare il fronte d’onda codificato in una posizione prima del piano del sensore. Dopo il piano coniugato, viene utilizzata una lente di demagnificazione per catturare l’intensità di rilevamento finale.
b Fotografia della configurazione sperimentale. La freccia verde indica il percorso della luce.
Con uno spatial light modulator LCOS a 180 Hz, il sistema richiede circa 5,56 millisecondi per un batch da 15 video; i ricercatori stimano che modulatori MEMS a 1.440 Hz potrebbero ridurre la latenza a circa 0,69 millisecondi per batch e portare il consumo del decoder ottico nell’ordine di 0,60-0,99 mJ per video. Sono valori riferiti all’architettura sperimentale e non a un prodotto commerciale, ma indicano perché l’optical computing possa diventare interessante proprio dove il problema non è classificare un singolo deepfake, bensì verificare continuamente enormi quantità di materiale audiovisivo.
Veo 3 dimostra che riconoscere il face swap non basta più
Il gruppo UCLA ha inoltre evitato di limitare la valutazione ai classici face swap, perché sarebbe ormai un test troppo distante dalla generazione video contemporanea. L’architettura è stata verificata su dataset che comprendono manipolazioni tradizionali, registrazioni deepfake reali e contenuti completamente generati dall’AI; nei test, il sistema ha raggiunto 94,80% di accuratezza e 97,61% di sensibilità su video prodotti con Google Veo 3 non presenti nel training, dopo un fine-tuning limitato. Il dato va letto con cautela perché non dimostra che l’architettura possa riconoscere automaticamente qualsiasi futuro generatore, ma mostra una capacità di generalizzazione oltre gli artefatti caratteristici dei vecchi deepfake facciali. È un passaggio fondamentale perché il problema della verifica dei contenuti sintetici si sta spostando dagli errori visibili alla provenienza e alla robustezza dei sistemi di autenticazione, tema già emerso nel confronto di Matrice Digitale tra Apple Reference Image e C2PA per certificare l’origine delle fotografie e nella guida europea a etichette e watermark per i contenuti generati dall’AI.
L’hardware ottico rende anche più difficile attaccare il detector
La seconda caratteristica strategica dell’architettura riguarda gli attacchi adversariali. I detector digitali possono essere studiati, interrogati e in alcuni casi approssimati fino a costruire perturbazioni progettate specificamente per modificarne la classificazione; nel sistema UCLA una parte dei parametri effettivi dell’inferenza è invece incorporata nella configurazione fisica della propagazione ottica, rendendo più difficile ricostruire esattamente il modello distribuito. Gli esperimenti mostrano resistenza a rumore, blur, compressione JPEG, disallineamenti sperimentali e diversi attacchi black-box, mentre gli autori parlano di una protezione intrinseca più forte contro scenari white-box proprio perché l’attaccante dovrebbe conoscere o riprodurre anche parametri fisici dell’apparato. Non significa che il sistema sia invulnerabile né che l’optical computing risolva automaticamente il problema degli attacchi adversariali, ma introduce un elemento poco presente nei detector tradizionali: la sicurezza del modello dipende anche da proprietà hardware difficili da copiare perfettamente. È una direzione rilevante in un ecosistema dove i deepfake sono già diventati strumenti di frode, abuso e impersonificazione, come mostrato dai precedenti italiani e internazionali raccolti da Matrice Digitale sul rilevamento automatico dei deepfake e sui deepfake sessuali oscurati nella cooperazione tra Italia e Stati Uniti.
Continua con:
YouTube introduce rilevatore AI anti deepfake mentre Google e OpenAI accelerano
Apple firma le foto autentiche contro i deepfake
La vera sfida è filtrare miliardi di video senza spendere miliardi di calcoli
Il risultato UCLA non dimostra quindi che i deepfake siano risolti con una precisione del 98%, perché dataset, condizioni sperimentali e generazioni future continueranno a modificare il problema. Mostra però una strada industrialmente più interessante: se la generazione sintetica scala quasi senza attrito, anche la verifica deve diventare parallela e molto meno costosa. Un detector ottico capace di esaminare decine di flussi nello stesso passaggio potrebbe funzionare come primo livello davanti a modelli digitali più sofisticati, lasciando a questi ultimi soltanto i contenuti sospetti e riducendo il volume di calcolo richiesto per la moderazione, l’autenticazione dei media o la verifica forense. La battaglia contro i deepfake potrebbe quindi non essere vinta dal classificatore con il benchmark più alto, ma dall’architettura capace di applicare una buona accuratezza a una quantità di contenuti sufficientemente grande da rendere possibile controllare davvero ciò che le piattaforme ricevono ogni secondo.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.