📌 In Sintesi
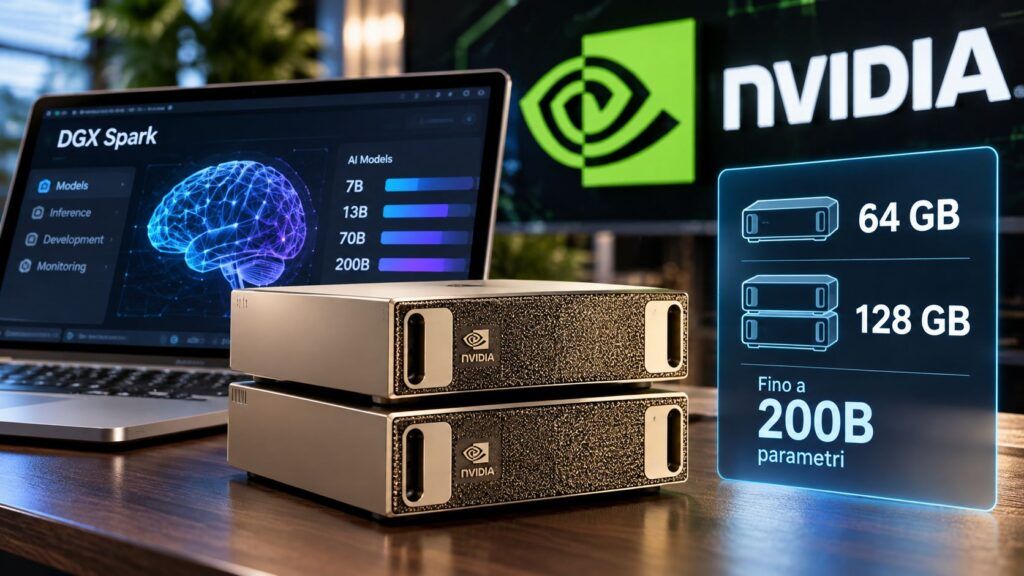
- Nvidia introduce una nuova configurazione DGX Spark con 64 GB di memoria unificata, disponibile dal 23 ottobre a partire da 4.999 dollari.
- Una singola macchina può eseguire modelli fino a circa 100 miliardi di parametri; due sistemi collegati tramite ConnectX-7 arrivano a 128 GB e modelli fino a 200 miliardi.
- Nvidia Sync Cluster Assistant automatizza rete e configurazione del cluster, trasformando DGX Spark da workstation personale a piccolo nodo AI scalabile.
Nvidia riduce memoria e prezzo del DGX Spark per portare la propria piattaforma di AI locale verso una fascia più ampia di sviluppatori, senza però trasformarla in un prodotto consumer. Dal 23 ottobre arriverà una configurazione da 64 GB di memoria unificata a partire da 4.999 dollari, proposta attraverso Acer, Asus, Dell, Gigabyte, HP e MSI. Il punto interessante non è soltanto il dimezzamento rispetto ai 128 GB della configurazione superiore: Nvidia accompagna il nuovo modello con un sistema capace di collegare direttamente due Spark attraverso ConnectX-7 a 200 GbE, ottenendo 128 GB complessivi e portando su desktop workload che fino a pochi anni fa richiedevano infrastruttura server dedicata.
Cosa leggere
DGX Spark scende a 64 GB ma mantiene Blackwell e lo stack Nvidia
Nel nuovo annuncio ufficiale Nvidia la configurazione da 64 GB viene presentata come punto di ingresso per sviluppatori, ricercatori e utenti avanzati che vogliono eseguire agenti e modelli direttamente in locale. La macchina conserva DGX OS, architettura Blackwell e l’intero stack software Nvidia, con CUDA-X, Agent Toolkit, modelli Nemotron e supporto immediato per Ollama, vLLM, PyTorch e altri runtime. Secondo Nvidia, 64 GB permettono di eseguire modelli fino a circa 100 miliardi di parametri, a seconda di architettura e quantizzazione. La strategia segue l’espansione dell’ecosistema già osservata da Matrice Digitale con NemoClaw e gli strumenti Nvidia per ingegneri AI autonomi: l’obiettivo non è soltanto vendere capacità computazionale, ma consegnare una macchina nella quale modelli, agenti, librerie e ambiente di sviluppo funzionano come un unico prodotto.
Leggi anche: LLM in locale su Linux: Llama, Gemma, Nvidia e la nuova AI open source
Due Spark diventano un cluster da 128 GB senza costruire un server
La caratteristica che cambia maggiormente il posizionamento del nuovo modello è Nvidia Sync Cluster Assistant. Ogni DGX Spark integra una NIC ConnectX-7 e due unità possono essere collegate direttamente con un cavo QSFP, creando un fabric da 200 GbE. Nvidia indica per la coppia 128 GB di memoria complessiva, il doppio della bandwidth e prestazioni fino a 1,7 volte superiori, con la possibilità di eseguire modelli fino a circa 200 miliardi di parametri.
Sync rileva i dispositivi, controlla la configurazione, prepara la rete ConnectX-7 e gestisce il collegamento tra i nodi, riducendo quella parte di amministrazione che normalmente accompagna un ambiente distribuito. Non è memoria condivisa nel senso trasparente di una singola GPU con 128 GB: il modello deve comunque essere distribuito tra nodi distinti. Ma per uno sviluppatore significa passare da una workstation a un piccolo cluster senza dover progettare manualmente networking, routing e ambiente software. È un cambiamento coerente con la crescita dell’AI locale come alternativa operativa al cloud.
Il prezzo più basso mostra anche il nuovo valore della memoria
I 4.999 dollari richiesti per 64 GB mostrano però quanto il concetto di “AI personale” rimanga distante dal mercato PC tradizionale. Nvidia non sta cercando di sostituire una workstation gaming o un desktop professionale generico: vende un sistema nel quale memoria unificata, interconnessione ad alta velocità e stack CUDA sono calibrati attorno all’esecuzione di modelli locali.
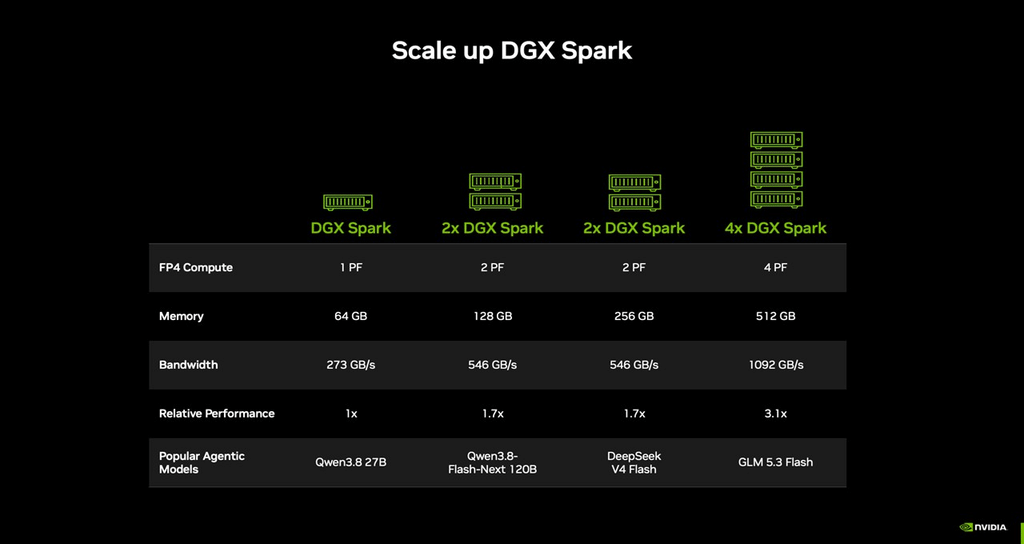
In questo mercato la capacità RAM determina direttamente la dimensione del modello utilizzabile, quindi passare da 128 a 64 GB crea una segmentazione molto più sostanziale rispetto alla semplice differenza tra due configurazioni di memoria di un normale computer. La scelta arriva inoltre mentre il costo delle memorie sta diventando uno dei principali colli di bottiglia della filiera AI, come mostrato dagli investimenti di Micron e dai rincari Nvidia legati alla domanda infrastrutturale. Il nuovo Spark riduce quindi il prezzo d’ingresso proprio tagliando la risorsa più preziosa per chi vuole far girare grandi modelli senza cloud.
Nvidia vende soprattutto indipendenza dal cloud
Il valore della piattaforma emerge nei workload che Nvidia associa al nuovo sistema: agenti di coding o ricerca sempre attivi, generazione di immagini, analisi documentale, inferenza privata e applicazioni AI eseguite localmente mentre il computer principale resta libero. Blender sarà tra le prime applicazioni creative a offrire un installer dedicato, mentre Nvidia Sync Model Launcher dovrà semplificare ulteriormente il caricamento di modelli locali e la loro esposizione ai computer della rete. È una strategia che risponde a uno dei limiti strutturali dell’AI cloud: costi variabili, trasferimento di dati verso terzi e dipendenza dalla connettività. Per aziende e sviluppatori che lavorano con codice proprietario o documentazione sensibile, eseguire un agente interamente on-premise può avere un valore superiore al semplice confronto dei token al secondo. La competizione si sposta così verso il terreno già occupato da Apple con Mac Studio M5 Ultra e 512 GB dedicabili all’AI locale, ma Nvidia mantiene il vantaggio dell’ecosistema CUDA e delle librerie costruite attorno ai propri acceleratori.
Continua con:
Mac Studio M5 Ultra porta l’AI locale a 512 GB e sfida Nvidia
Nvidia Blackwell porta l’AI agentica verso l’uso industriale
L’AI locale diventa più accessibile ma non ancora democratica
DGX Spark 64 GB descrive bene il paradosso dell’intelligenza artificiale eseguita in locale. I modelli open-weight stanno diventando più efficienti, la quantizzazione permette di comprimere reti sempre più capaci e Nvidia riesce a portare workload da decine di miliardi di parametri dentro una scatola da scrivania. Ma la macchina considerata accessibile parte ancora da 4.999 dollari, e chi vuole raddoppiare la memoria attraverso due Spark entra rapidamente in una fascia di investimento da workstation professionale avanzata. Il progresso reale è quindi nella densità: quantità di calcolo e memoria che prima richiedevano rack e server possono essere collocate sulla scrivania e gestite attraverso un’interfaccia sempre più automatizzata. La direzione è chiara: l’AI locale sta smettendo di essere un esperimento per appassionati e diventa infrastruttura professionale. Nvidia non sta ancora democratizzando il calcolo AI, ma sta comprimendo un piccolo data center fino a farlo entrare nello spazio occupato da un desktop.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.