🔑 Key findings
- Google separa il contesto recente dalla memoria persistente usando Memorystore for Valkey e AlloyDB AI.
- Nel benchmark interno il modello a due livelli riduce dell’88,9% il prompt e del 72% i token cumulativi rispetto al context stuffing.
- La memoria diventa un layer infrastrutturale dell’agente, con conseguenze dirette su costi, performance, isolamento e governance.
Google non sta cercando di rendere gli agenti AI soltanto più intelligenti: sta cercando di impedire che il loro costo cresca insieme alla conversazione. La nuova architettura proposta per Google Cloud separa la memoria di breve periodo da quella persistente, utilizzando Memorystore for Valkey per mantenere il buffer della sessione e AlloyDB AI per conservare preferenze, regole, eventi e risultati utili tra una sessione e l’altra. Il problema affrontato è strutturale: i modelli linguistici restano stateless tra le sessioni e riempire ogni nuovo prompt con cronologia, log dei tool e istruzioni precedenti trasforma la context window in un archivio sempre più costoso. Google sposta quindi la memoria fuori dal modello e dentro l’infrastruttura dati, facendo diventare database e cache una parte permanente del runtime agentico.
Cosa leggere
Il context stuffing funziona finché il conto non esplode
La scorciatoia più semplice per dare memoria a un agente consiste nel reinserire nel prompt tutto ciò che potrebbe servirgli: conversazioni precedenti, risultati dei tool, vincoli e cronologia operativa. Nella proposta tecnica per la memoria persistente degli agenti AI Google definisce questo modello context stuffing e ne quantifica i limiti quando le interazioni diventano lunghe. Nel benchmark interno, realizzato su un workload simulato di sviluppo con oltre 45 turni e uso intenso di tool, il prompt al turno 45 passa da 747.033 token a 83.262, una riduzione dell’88,9%, mentre la latenza scende da 33,5 a 6,7 secondi. Il problema non è soltanto economico: quantità crescenti di contesto aumentano il rischio che vincoli importanti vengano persi nel mezzo del prompt. Il passaggio era già visibile quando Google Cloud ha portato AlloyDB, MCP e grafi enterprise negli agenti AI: il database smette di essere soltanto una sorgente interrogata dal modello e diventa parte del meccanismo che governa conoscenza e stato.
Leggi anche: Google Cloud lancia QueryData per agenti AI con dati precisi quasi al 100%
Valkey conserva il presente, AlloyDB decide cosa deve restare
L’architettura divide la memoria in due livelli con requisiti molto diversi. Memorystore for Valkey mantiene il buffer di breve periodo attraverso una sliding window limitata per token, conservando i turni recenti con accesso sub-millisecondo senza costringere il database relazionale a gestire continue scritture e cancellazioni.
| Tipo di Memoria | Cosa memorizza | Livello di Archiviazione | Ciclo di vita |
|---|---|---|---|
| Buffer (Breve termine) | Turni di conversazione grezzi recenti | Memorystore for Valkey | Sessione attiva |
| Memoria di riepilogo (Summary) | Cronologia compressa dei turni precedenti, comunemente definita “compaction” | Memorystore for Valkey | Finestra multi-turno |
| Memoria episodica | Azioni passate, eventi e output degli strumenti | AlloyDB for PostgreSQL(Recupero ibrido con SQL strutturato + ricerca full-text + vettoriale) | Permanente |
| Memoria di entità e regole | Preferenze dell’utente, vincoli e veto | AlloyDB for PostgreSQL(Recupero ibrido con SQL strutturato + ricerca full-text + vettoriale) | Permanente |
AlloyDB AI prende invece in carico la memoria persistente: fatti episodici, preferenze dell’utente, regole e vincoli che devono sopravvivere alla singola sessione. Google distingue quattro tipi di memoria — buffer, summary, episodic ed entity/rule memory — assegnando ai primi due il livello temporaneo e agli ultimi due la persistenza PostgreSQL. La separazione completa un’evoluzione già evidente con Google Agent Executor, progettato per distribuire agenti AI su infrastruttura cloud: non basta più decidere dove gira un agente e quali strumenti può utilizzare, perché diventa necessario stabilire anche quale stato deve sopravvivere alla sua esecuzione.
Il risparmio di token diventa una decisione infrastrutturale
Nel test Google i token cumulativi della sessione scendono da 17,9 milioni a 4,09 milioni, pari al 72% in meno. La società precisa che si tratta di un benchmark interno su un workload simulato e che prestazioni e risparmi reali dipendono da struttura dei prompt, frequenza delle query e volume dei dati.
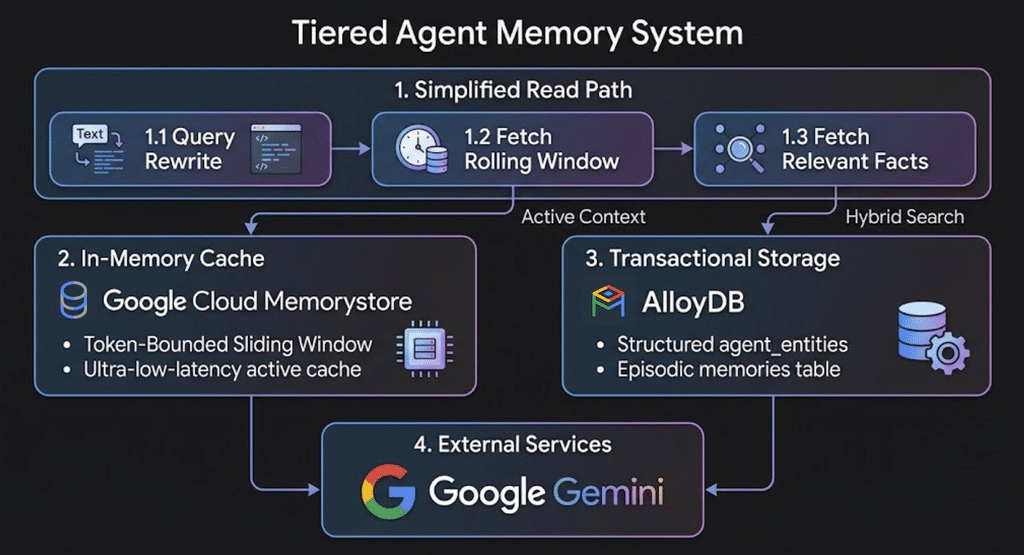
Il valore del risultato sta quindi nel meccanismo, non nella promessa di una percentuale universale: invece di pagare a ogni turno per rileggere l’intera storia, l’applicazione recupera soltanto la finestra recente e le memorie pertinenti alla richiesta. È lo stesso problema economico emerso quando Google Cloud ha introdotto Spend Caps e Gemini Enterprise Agent Platform e quando le VM usate dagli agenti OpenAI hanno mostrato il costo computazionale nascosto dell’autonomia. Negli agenti di lunga durata, token, compute, storage e query finiscono per comporre un unico costo operativo.
La memoria permanente apre un nuovo problema di governance
Conservare ciò che l’agente ricorda significa anche decidere quali informazioni diventino permanenti e chi possa recuperarle. Google propone di indicizzare user_id, project_id e scope e di utilizzare la Row-Level Security di PostgreSQL per separare memorie appartenenti a utenti, team o reparti differenti. AlloyDB combina inoltre ricerca vettoriale, full-text e filtri sui metadati, mentre le auto-embedding transazionali aggiornano le rappresentazioni vettoriali insieme ai dati originali.
| Metrica / Dimensione | Naive Context Stuffing | Memoria a strati (AlloyDB + Valkey) | Impatto di business netto |
|---|---|---|---|
| Dimensione prompt attivo (Turno 45) | 747.033 token | 83.262 token | Prompt più piccolo dell’88,9% |
| Latenza risposta (Turno 45) | 33,5 secondi | 6,7 secondi | Risposta più veloce dell’80,0% |
| Tempo di attesa per turno | 33,5 secondi | 4,2s – 6,7s | Riduzione dal 36% all’80% |
| Token cumulativi di sessione | 17,9M token | 4,09M token | Risparmio del 72,0% su token e costi |
| Recupero regole e vincoli | Si degrada nel corso dei turni | Non si degrada | Recupero con garanzia ACID preservata |
L’integrazione riduce la necessità di pipeline esterne, ma concentra nello stesso livello dati operativi, embedding, regole e memoria dell’agente. È la stessa direzione osservata quando Google Cloud ha trasformato database e servizi infrastrutturali in componenti direttamente interrogabili dagli agenti: il vantaggio è una minore frammentazione, ma errori di isolamento o autorizzazione acquistano un impatto maggiore.
Continua con:
Google Cloud rende l’infrastruttura più elastica tra Spark, GKE e supply chain CI/CD
AWS industrializza agenti e inferenza AI: AgentCore e SageMaker entrano nei workload reali
Gli agenti smettono di essere chat e diventano applicazioni stateful
Separare buffer e memoria persistente chiarisce dove sta andando l’AI enterprise. Un agente che deve ricordare preferenze, decisioni, vincoli e risultati per giorni non può essere trattato come una chat con una context window sempre più grande: deve possedere stato, policy di conservazione, retrieval e confini tra utenti. In questo modello il foundation model può essere sostituito senza perdere necessariamente la memoria dell’applicazione, perché il patrimonio informativo viene conservato fuori dal modello. Le context window milionarie riducono alcuni vincoli, ma non eliminano il costo di ripresentare continuamente informazioni già note né garantiscono che regole essenziali restino facilmente recuperabili dopo decine di interazioni. Google sta quindi spostando una parte del vantaggio competitivo dal modello al database: se gli agenti diventeranno processi aziendali di lunga durata, conterà non soltanto ciò che l’AI sa, ma soprattutto quanto bene l’infrastruttura decide cosa ricordare, cosa dimenticare e cosa recuperare nel momento giusto.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.