📌 In Sintesi
- Claude sta mostrando agli utenti un consenso specifico per utilizzare registrazioni audio e conversazioni vocali nel miglioramento dei modelli Anthropic.
- Il controllo è separato dal consenso già esistente per chat e sessioni Claude Code e risulta disattivato di default.
- La documentazione Anthropic distingue ancora la semplice dettatura, il cui audio viene eliminato dopo la trascrizione, dalle nuove conversazioni vocali autorizzate per il training.
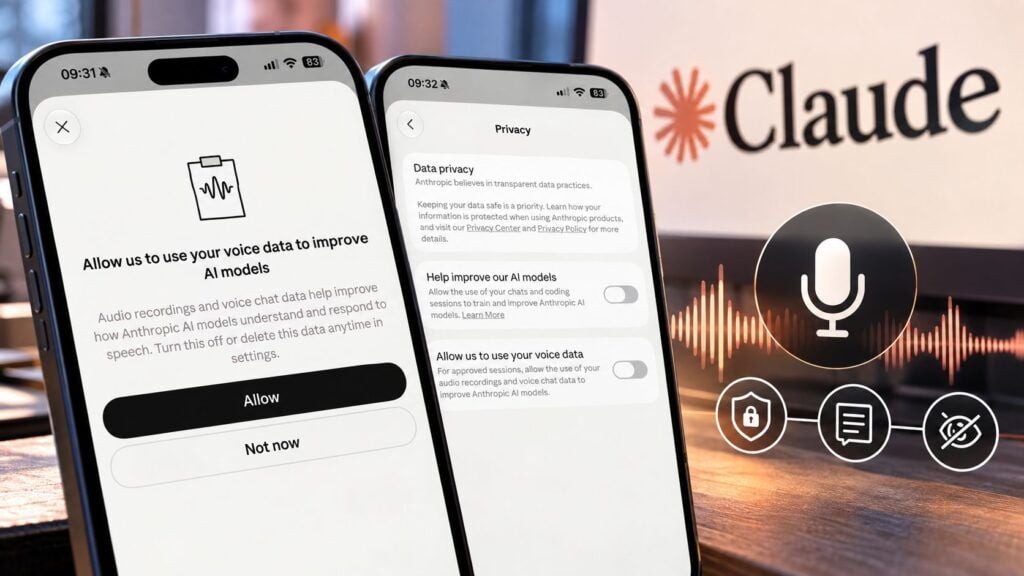
Anthropic vuole anche la voce degli utenti per migliorare Claude, ma questa volta la richiesta è esplicita. Alcuni utenti stanno vedendo nell’interfaccia un nuovo consenso dedicato all’utilizzo di registrazioni audio e dati delle conversazioni vocali per l’addestramento dei modelli. Il punto decisivo è che l’opzione non risulta attivata automaticamente e soprattutto è separata dal controllo che già consente ad Anthropic di utilizzare chat testuali e sessioni Claude Code. È una distinzione importante dopo le polemiche nate attorno a Claude Desktop e al bridge installato nei browser senza una richiesta di consenso altrettanto evidente: nel caso della voce, la raccolta per il training viene presentata come una scelta specifica dell’utente.
Cosa leggere
Claude introduce un secondo consenso dedicato alla voce
La nuova impostazione è stata individuata da BleepingComputer all’interno delle impostazioni Privacy di Claude. Il messaggio chiede all’utente di consentire l’utilizzo di audio recordings and voice chat data per migliorare la capacità dei modelli Anthropic di comprendere e rispondere al linguaggio parlato. Le possibilità mostrate sono “Allow” e “Not now”, mentre nelle configurazioni osservate il relativo toggle risulta inizialmente spento. L’utente può quindi utilizzare Claude senza autorizzare questo ulteriore trattamento e può successivamente modificare la scelta.
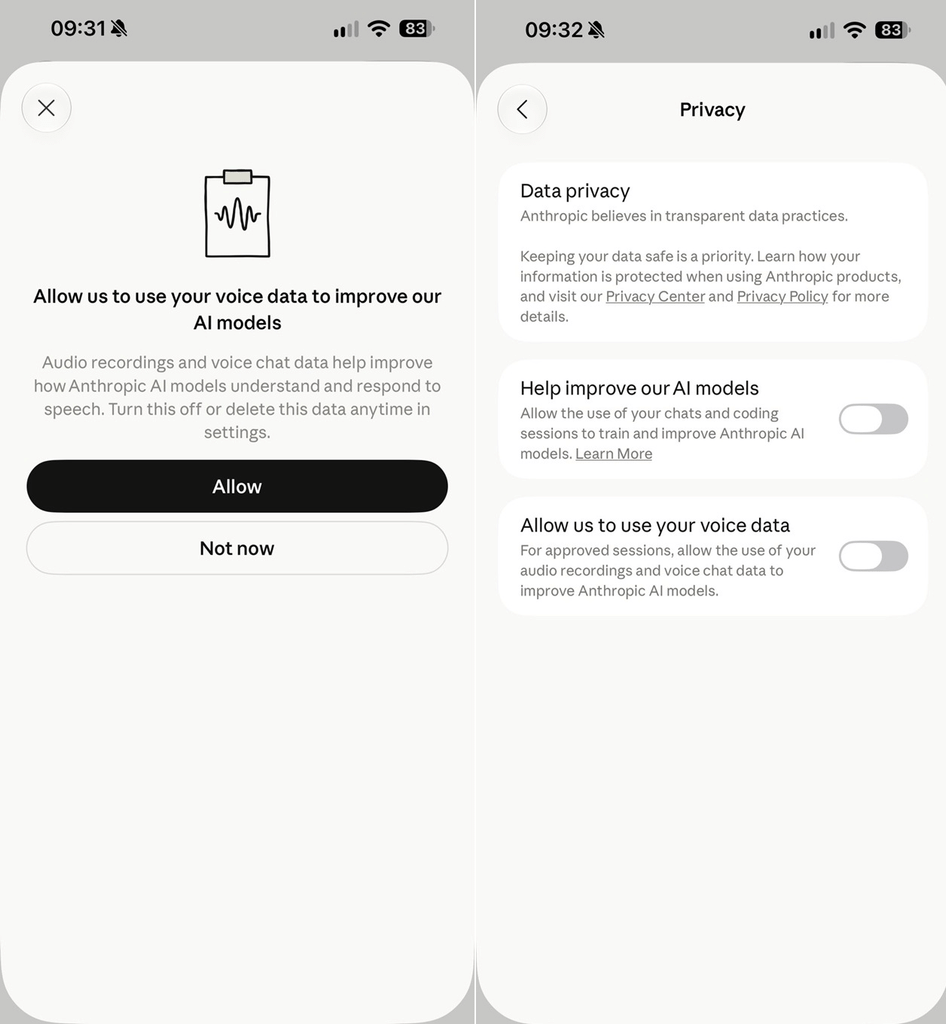
Ancora più interessante è la separazione tecnica dal consenso già esistente per chat e codice. Un utente può consentire l’utilizzo delle conversazioni vocali senza concedere quello delle normali chat oppure fare l’opposto. Anthropic sta quindi trasformando il consenso al training da una scelta generale sul proprio account a una struttura progressivamente granulare per tipologia di dato, principio che acquista importanza man mano che gli assistenti diventano multimodali.
Leggi anche: Google investe 40 miliardi in Anthropic e Claude estende il proprio ecosistema
Dettatura e voice chat non sono la stessa raccolta di dati
La nuova impostazione crea però una distinzione che può facilmente confondere gli utenti. Nel proprio Privacy Center Anthropic continua a spiegare che, quando viene utilizzata la dettatura nelle app mobili, l’audio viene convertito in testo e successivamente eliminato. La società afferma esplicitamente di non conservare una copia di quell’input vocale e di non utilizzarlo per addestrare i modelli generativi. Il nuovo consenso osservato riguarda invece registrazioni audio e dati delle voice chat approvate. Non è quindi corretto sostenere che Anthropic abbia improvvisamente iniziato a conservare qualsiasi parola pronunciata davanti a Claude. La differenza è tra un input vocale utilizzato come sostituto della tastiera e una conversazione audio che l’utente decide esplicitamente di mettere a disposizione per migliorare i sistemi vocali. Una distinzione simile è già diventata centrale quando Samsung ha iniziato ad aprire dati sanitari all’AI chiedendo autorizzazioni dedicate per il trattamento.
Anthropic usa già chat e Claude Code solo con opt-in
Il nuovo toggle non nasce nel vuoto. Dal 2025 Anthropic consente agli utenti consumer di scegliere se utilizzare chat e sessioni di coding per migliorare Claude. La documentazione ufficiale sul training chiarisce che input e output degli utenti consumer non vengono normalmente utilizzati per addestrare i modelli generativi salvo tre situazioni: revisioni Trust & Safety, materiale inviato volontariamente tramite feedback oppure consenso esplicito dell’utente. La società ha inoltre stabilito per chat e sessioni di coding autorizzate al training una conservazione fino a cinque anni. La documentazione pubblica disponibile sulla nuova opzione vocale non chiarisce ancora se lo stesso periodo debba essere applicato automaticamente alle registrazioni audio approvate. È quindi necessario evitare di estendere alla voce una regola documentata per altre categorie di dati fino a quando Anthropic non definirà esplicitamente la retention specifica.
Il vero problema arriverà quando voce, memoria e agenti si uniranno
La voce contiene qualcosa che un prompt scritto normalmente non contiene: caratteristiche biometriche, inflessioni, accento, ambiente sonoro e potenzialmente informazioni su persone che non hanno scelto di parlare con l’AI. Anche quando il training non mira a identificare l’utente, la materia prima è qualitativamente diversa. Per questo la granularità del consenso assume un peso maggiore rispetto alla semplice distinzione formale tra un toggle acceso e uno spento. La questione diventerà ancora più rilevante con assistenti persistenti capaci di mantenere memoria, accedere a file e applicazioni e operare autonomamente. Il precedente italiano mostra quanto facilmente il trattamento dei dati nell’AI possa trasformarsi da caratteristica tecnica a questione regolatoria, come emerso nel confronto tra OpenAI e Garante Privacy su raccolta, conservazione e trasparenza dei dati.
Continua con:
Anthropic accusa i laboratori cinesi di distillare Claude su scala industriale
Musk vede la Cina al livello di Fable 5 mentre Anthropic tratta con Washington
Anthropic sceglie il consenso prima che la voce diventi materia prima invisibile
La novità più rilevante non è che Anthropic voglia dati vocali: qualsiasi azienda che costruisce modelli speech ha bisogno di grandi quantità di parlato reale. È il modo in cui sta cercando di ottenerli. Un controllo separato, disattivato di default e reversibile riduce il rischio che l’utente autorizzi inconsapevolmente categorie di dati molto diverse con un’unica scelta generica. Restano domande aperte sulla retention delle registrazioni approvate, sulla loro eventuale de-identificazione e sulla gestione delle voci di terzi catturate accidentalmente durante una conversazione. Ma sul fatto principale la distinzione deve rimanere netta: Claude non sta trasformando automaticamente ogni microfono in una fonte di training. Anthropic sta chiedendo agli utenti di cedergli volontariamente anche questo nuovo tipo di dato. Ed è proprio la qualità di quel consenso, più della semplice esistenza della raccolta, che determinerà quanto la voce potrà diventare materia prima dell’AI senza trasformarsi nell’ennesimo dato personale assorbito in silenzio.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.