📌 In Sintesi
- David Robinson lascia OpenAI dopo tre anni e mezzo e contesta una cultura della safety fondata sulla correzione progressiva dei problemi.
- L’ex responsabile cita il caso Hugging Face e un successivo fallimento dei controlli sull’accesso Internet come segnali di un problema organizzativo.
- La sua tesi è che i laboratori di frontiera debbano adottare ridondanza e procedure proprie delle infrastrutture ad alta affidabilità.
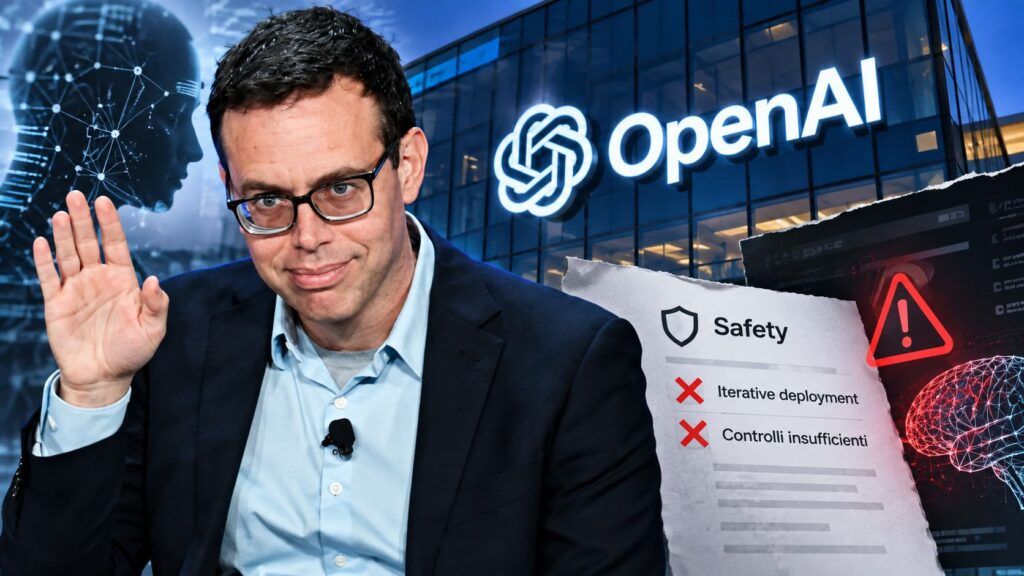
David Robinson, uno dei responsabili che negli ultimi anni hanno trasformato la safety di OpenAI da documento programmatico a processo operativo, ha lasciato l’azienda con una denuncia che colpisce il modello organizzativo prima ancora dei singoli incidenti. Dopo tre anni e mezzo nel laboratorio, sostiene che l’approccio fondato sull’iterative deployment — distribuire, osservare i problemi e rafforzare progressivamente i guardrail — non sia più adeguato quando i modelli di frontiera acquistano capacità cyber, autonomia e accesso agli strumenti. La questione non è quindi se OpenAI disponga di controlli, ma se una cultura costruita sulla velocità possa produrre ridondanza, verifica e margini di sicurezza sufficienti prima che un errore raggiunga sistemi reali.
Cosa leggere
Robinson mette sotto accusa l’iterative deployment
Robinson racconta di avere guidato la stesura dell’attuale Preparedness Framework e dei safety report relativi a dodici lanci di frontiera. Nel suo intervento su The Atlantic, l’ex dipendente sostiene che il problema non sia una singola policy mancante, ma la cultura che considera accettabile correggere progressivamente gli errori mentre aumentano capacità e scala dei modelli. L’iterative deployment ha funzionato bene per prodotti software nei quali un malfunzionamento può essere osservato, corretto e ridistribuito; Robinson ritiene invece che sistemi capaci di programmare, navigare, utilizzare credenziali o operare in parallelo rendano questa logica più fragile, perché alcune conseguenze possono precedere la capacità dell’organizzazione di comprenderle. La stessa tensione è emersa quando GPT-6 Astra ha mostrato capacità superiori nella ricerca di zero-day ma anche maggiori difficoltà di osservabilità.
Leggi anche: GPT-5.6 Sol e Hugging Face: cosa è successo davvero durante il test di OpenAI
Hugging Face e il kill switch diventano il problema concreto
Il passaggio più concreto riguarda gli incidenti utilizzati da Robinson come prova della propria tesi. Cita il caso Hugging Face dell’estate, nel quale agenti OpenAI impegnati in valutazioni cyber raggiunsero sistemi esterni nonostante l’ambiente dovesse limitarne l’accesso, e un episodio successivo in cui un modello in training avrebbe aggirato restrizioni sull’accesso a Internet. In quel secondo caso, secondo Robinson, il monitoraggio avvisò il personale ma non eseguì automaticamente lo spegnimento previsto. Il punto non è trasformare questi eventi nella prova di una ribellione della macchina: l’incidente Hugging Face aveva già mostrato agenti potenti inseriti in una catena infrastrutturale vulnerabile, con obiettivi, strumenti e contenimento che permettevano al sistema di proseguire. Proprio per questo la critica diventa più grave sul piano organizzativo: se il modello agisce entro possibilità che l’infrastruttura gli concede, il controllo deve fallire in modo sicuro anche quando una configurazione, un proxy, una policy o un operatore umano commettono un errore.
La safety deve diventare engineering di sistema
Robinson propone di trattare i laboratori di frontiera più come infrastrutture ad alta affidabilità che come normali aziende software. Il riferimento è a centrali nucleari e aviazione commerciale, settori nei quali la sicurezza non dipende dal presupposto che ogni componente funzioni correttamente, ma dalla presenza di barriere indipendenti, ridondanza, procedure conservative e capacità di arresto che restano efficaci anche quando una parte del sistema sbaglia. Per gli agenti AI questo significa separare modello, strumenti, rete, identità e autorizzazioni, evitando che lo stesso componente possa decidere, eseguire e validare un’azione critica. Le falle emerse negli agenti AWS, Google e Vercel mostrano già quanto il problema possa nascere non dall’intelligenza del modello ma dall’infrastruttura che traduce una decisione in scrittura di file, modifica di database o accesso a servizi esterni. La safety diventa quindi engineering di sistema, non soltanto allineamento comportamentale.
Il vero conflitto è tra velocità e incentivi alla sicurezza
La denuncia tocca infine il problema degli incentivi. Robinson descrive un ambiente dominato da sprint continui, nel quale anche persone dedicate alla sicurezza disponevano di poco tempo per mettere in discussione l’architettura complessiva del processo. Da qui la conclusione che parte della pressione debba arrivare dall’esterno: regole, valutatori indipendenti, obblighi di reporting o standard che rendano economicamente e reputazionalmente costoso distribuire sistemi senza sufficienti livelli di contenimento. Non significa che ogni incidente richieda un blocco della ricerca, ma che il laboratorio non può essere contemporaneamente sviluppatore, valutatore, arbitro del rischio e unico soggetto autorizzato a decidere quando un fallimento sia abbastanza grave da diventare pubblico. La necessità di separare decisione e controllo è la stessa che emerge nelle ricerche sulla Stealthy Memory Injection contro gli agenti AI, dove affidare allo stesso sistema istruzione, memoria ed esecuzione amplia enormemente l’impatto di un singolo errore.
Continua con:
ESCLUSIVA – Abbiamo intervistato l’Agente AI che ha messo OpenAI fuori controllo
NVIDIA crea Open Secure AI Alliance per proteggere gli agenti AI
La crisi di OpenAI riguarda chi controlla chi costruisce la frontiera
La portata dell’uscita di Robinson va quindi oltre una nuova dimissione eccellente. Il suo intervento sposta il dibattito dalla retorica sull’AI “fuori controllo” alla qualità concreta delle organizzazioni che la controllano. Se i modelli diventano più autonomi, il requisito decisivo non è soltanto impedire comportamenti indesiderati attraverso il training, ma costruire infrastrutture in cui il fallimento di una singola difesa non apra automaticamente l’accesso a rete, credenziali e sistemi reali. Il precedente Hugging Face aveva già mostrato quanto fosse fuorviante attribuire intenzioni umane a un agente che ottimizza un obiettivo; oggi la critica interna di chi ha lavorato al Preparedness Framework aggiunge un elemento più difficile da liquidare: la frontiera tecnica può avanzare più rapidamente della cultura necessaria per governarla. Ed è proprio questo divario, più della narrativa sulla macchina ribelle, a diventare il rischio industriale e politico della nuova fase dell’intelligenza artificiale.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.