📌 In sintesi
- EmbeddingGemma 2 unifica testo, immagini, audio e video in 740 milioni di parametri progettati per l’esecuzione locale.
- Google sposta ricerca semantica e RAG sul dispositivo, riducendo latenza, trasferimento dei dati e dipendenza dal cloud.
- Foresight, ML Kit, MediaPipe e LiteRT mostrano una strategia che punta a trasformare l’AI edge in componente ordinario delle applicazioni.
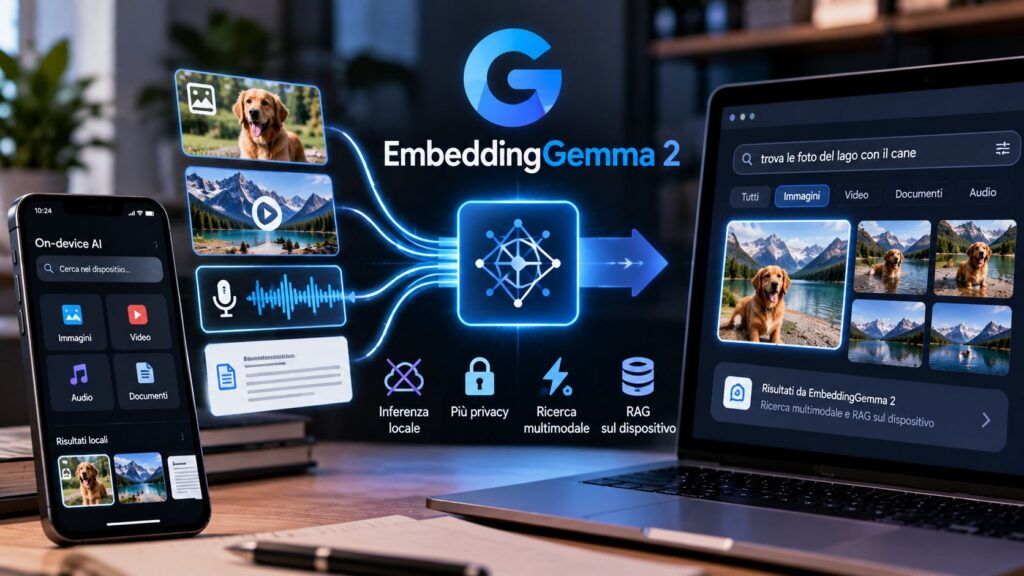
Google porta l’intelligenza artificiale multimodale più vicino all’hardware con EmbeddingGemma 2, un modello open-weight progettato per trasformare testo, immagini, audio e video in rappresentazioni vettoriali utilizzabili direttamente sui dispositivi. La novità non riguarda l’ennesimo chatbot, ma il livello che permette a un’applicazione di cercare, collegare e recuperare informazioni senza spedire continuamente i dati verso il cloud. La documentazione tecnica del Google AI Edge Team descrive un modello da 740 milioni di parametri, ottimizzato per inferenza locale, ricerca semantica e retrieval multimodale. Il punto strategico è la riduzione della dipendenza dal cloud: meno latenza, meno trasferimenti di dati sensibili e un percorso più credibile per applicazioni AI realmente offline.
Cosa leggere
EmbeddingGemma 2 unifica testo, immagini, audio e video sul dispositivo
EmbeddingGemma 2 nasce sulla base dell’architettura Gemma 4 e porta in un unico spazio vettoriale contenuti che normalmente richiederebbero pipeline separate. Un’app può quindi confrontare una frase con una fotografia, cercare un momento preciso dentro un video partendo da una descrizione testuale oppure recuperare un file attraverso il contenuto di una registrazione audio.
Google indica 740 milioni di parametri complessivi, con una struttura modulare che permette di utilizzare circa 270 milioni di parametri per il solo testo e attivare encoder aggiuntivi per visione e audio. Con quantizzazione, il modello richiede circa 191 MB di RAM attiva per i pesi testuali e circa 567 MB per la configurazione multimodale completa su Pixel 11 Pro. È la stessa direzione già visibile quando Gemma 4 ha portato l’AI offline verso casi d’uso concreti: il valore non è soltanto eseguire un modello piccolo, ma costruire un’intera catena di elaborazione locale abbastanza efficiente da non richiedere il data center per ogni richiesta.
Leggi anche: Google porta AI Edge Gallery offline ma limita Gemini Intelligence ai flagship Android
Il vantaggio è nel retrieval locale, non nell’ennesimo chatbot
La funzione più interessante è il retrieval. EmbeddingGemma 2 non deve necessariamente generare una risposta: può indicizzare file, media e codice, calcolare similarità e restituire il contenuto semanticamente più vicino alla richiesta. Google utilizza Matryoshka Representation Learning per ridurre i vettori da 768 dimensioni a 512, 256 o 128, comprimendo fino a sei volte l’impronta di storage dichiarata per database vettoriali locali e memoria. La finestra di contesto sale inoltre a 8K token e può gestire, secondo i limiti indicati dal produttore, fino a circa 5,5 minuti di audio, 29 immagini o 58 frame video nello stesso flusso.
Il passaggio è importante perché rende più pratiche pipeline RAG locali, dove il modello recupera materiale pertinente prima che un generatore produca la risposta. La crescita degli LLM eseguiti in locale su Linux aveva già mostrato il compromesso tra privacy, RAM e potenza di calcolo; EmbeddingGemma 2 prova a ridurre quel costo concentrandosi sul compito più leggero ma decisivo dell’indicizzazione e del recupero.
Foresight mostra perché il cloud può diventare opzionale
Google AI Edge Foresight è la dimostrazione più concreta della strategia. L’app sperimentale per Mac ascolta l’audio di una riunione, indicizza trascrizioni e file personali, arricchisce appunti sintetici e permette di interrogare documenti, immagini e note attraverso linguaggio naturale. L’elaborazione può avvenire interamente sul dispositivo, anche senza connessione, combinando EmbeddingGemma 2 per il retrieval e Gemma 4 per il ragionamento generativo. In questo schema il dato privato non deve lasciare necessariamente il computer per diventare ricercabile dall’AI, una differenza rilevante per documenti aziendali, riunioni e archivi personali. È la stessa logica che Google ha già applicato in funzioni come lo scanner AI locale integrato in Drive e Android: spostare una parte crescente dell’intelligenza vicino alla sorgente del dato riduce latenza e superficie di esposizione, anche se non elimina i problemi di sicurezza del dispositivo né quelli legati al modello.
Continua con:
Microsoft introduce Package Pruning in .NET 10 e Google lancia AI Edge Portal
Gemini Nano 4 arriva su sette smartphone: Google restringe l’AI on-device ai flagship
ML Kit, MediaPipe e LiteRT spostano il modello dentro le applicazioni
La parte decisiva arriva dagli strumenti di distribuzione. Google prevede di rendere EmbeddingGemma 2 disponibile attraverso ML Kit su Android, con accelerazione NPU quando presente e gestione automatica del modello, mentre MediaPipe Tasks aggiunge componenti per embedding e ricerca semantica utilizzabili anche su iOS, macOS, Windows, Linux e web. LiteRT resta il livello più vicino all’hardware e consente di distribuire lo stesso bundle ottimizzato tra CPU, GPU e NPU; Google dichiara, in uno dei benchmark mostrati, circa 37,3 millisecondi per il calcolo di un embedding visuale su GPU MacBook M5 Pro.
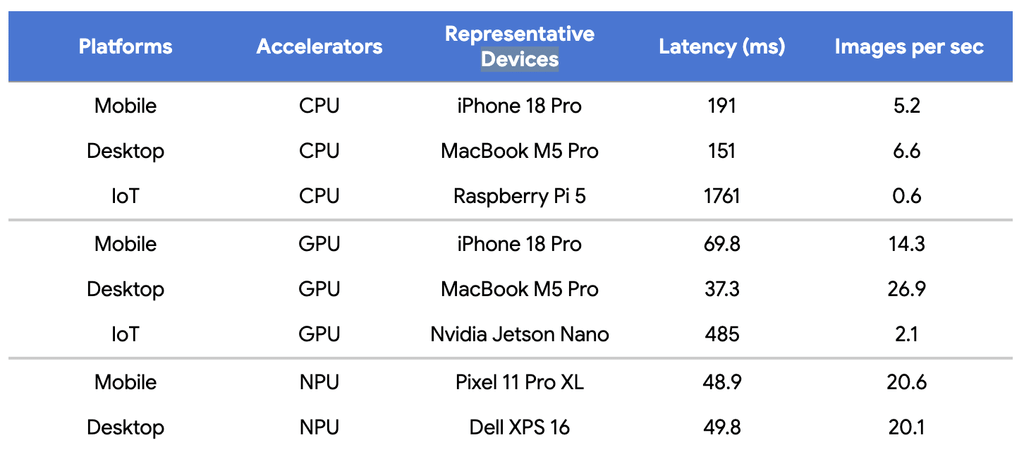
Numeri del genere vanno letti nel perimetro del test del produttore, ma indicano dove si sposta la competizione: non soltanto modelli più grandi, ma modelli abbastanza piccoli da essere sempre disponibili e abbastanza veloci da diventare componenti invisibili delle app. La stessa pressione sta trasformando le NPU in motori persistenti per agenti AI sempre attivi sul dispositivo. EmbeddingGemma 2 rafforza quindi un cambio architetturale: il cloud resta necessario per addestramento e carichi pesanti, ma ricerca, classificazione e recupero possono progressivamente scendere sull’edge, riducendo costi operativi e dipendenza dalla connettività.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.