📌 In Sintesi
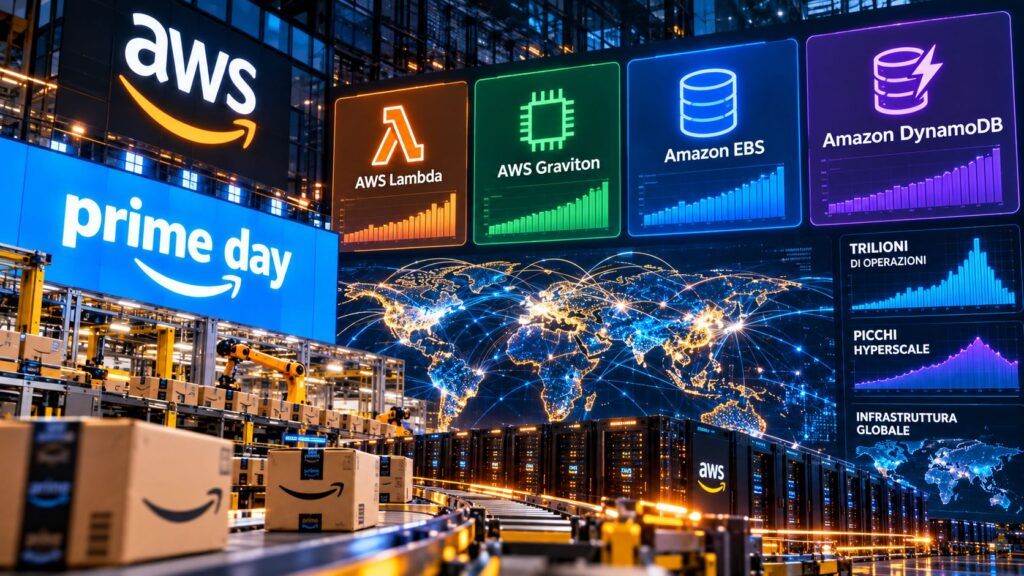
- AWS Lambda ha gestito oltre 2,3 trilioni di invocazioni al giorno durante Prime Day 2026, mentre EBS ha superato un exabyte di dati trasferiti quotidianamente.
- I processori Graviton hanno alimentato fino al 49% del compute EC2 utilizzato da Amazon.com e Fargate ha eseguito in media 158,3 milioni di task al giorno.
- DynamoDB ha raggiunto 192 milioni di richieste al secondo, mentre GuardDuty, CloudTrail e Fault Injection Service mostrano quanto osservabilità e resilienza siano diventate parte dell’infrastruttura.
Prime Day è una manifestazione commerciale, ma i dati pubblicati da Amazon mostrano soprattutto cosa significhi costruire un sistema distribuito capace di assorbire carichi globali senza trasformare ogni picco in un’emergenza infrastrutturale. Nella ricostruzione tecnica ufficiale di AWS relativa all’evento del 23-26 giugno 2026 compaiono numeri che superano la dimensione dell’e-commerce: trilioni di invocazioni serverless, centinaia di milioni di richieste al secondo, oltre un exabyte movimentato quotidianamente e decine di migliaia di esperimenti di fault injection. Più che raccontare quanto sia grande Amazon, questi dati mostrano come compute, storage, database, rete e sicurezza vengano distribuiti per impedire che un singolo collo di bottiglia fermi l’intero sistema.
Cosa leggere
Graviton arriva al 49% del compute EC2 e EBS supera un exabyte al giorno
Durante Prime Day 2026 i processori AWS Graviton hanno alimentato fino al 49% del compute Amazon EC2 utilizzato da Amazon.com, un dato significativo perché mostra quanto l’architettura ARM proprietaria sia ormai entrata nei carichi di produzione più critici del gruppo. Parallelamente Amazon EBS ha superato 24,8 trilioni di operazioni I/O al picco e ha movimentato oltre un exabyte di dati ogni giorno. Non si tratta quindi soltanto di aggiungere server quando aumenta il traffico: AWS distribuisce il carico tra capacità computazionale, storage a blocchi e servizi gestiti in modo da poter scalare componenti differenti indipendentemente. È la dimensione industriale che rende più concreto il dibattito sugli investimenti miliardari di AWS e Microsoft nelle infrastrutture cloud italiane: dietro la parola data center esiste una macchina in cui CPU, rete e storage devono crescere insieme senza che una componente saturi prima delle altre.
Leggi anche: Guasto AWS: stop a Prime Video, Perplexity AI, Fortnite, Canva, Udemy e Coursera
Lambda e Fargate mostrano quanto il serverless sia diventato infrastruttura di massa
AWS Lambda ha gestito oltre 2,3 trilioni di invocazioni al giorno, mentre Amazon ECS ha avviato mediamente 158,3 milioni di task quotidiani su Fargate, il 47,7% in più rispetto al Prime Day precedente. Sono numeri che descrivono due forme complementari di astrazione: da una parte funzioni eseguite senza che l’applicazione debba gestire direttamente server persistenti, dall’altra container avviati su capacità computazionale amministrata dal provider. L’interesse tecnico sta proprio nella granularità: anziché sovradimensionare enormi pool permanenti, Amazon può allocare risorse quando servono e spegnerle quando il carico diminuisce. Questa elasticità non elimina però il perimetro di sicurezza. Il precedente del malware Denonia individuato negli ambienti AWS Lambda aveva già mostrato che l’assenza di server da amministrare non significa assenza di workload da proteggere: identità, permessi, codice e runtime restano superfici operative reali.
DynamoDB raggiunge 192 milioni di richieste al secondo
Il livello dati è forse quello che rende meglio l’idea della scala. DynamoDB ha elaborato oltre 59 trilioni di richieste nei quattro giorni del Prime Day, raggiungendo un picco di 192 milioni di richieste al secondo mantenendo tempi di risposta nell’ordine dei millisecondi a singola cifra. CloudFront ha servito più di 2,1 trilioni di richieste HTTP durante la settimana globale dell’evento, mentre Kinesis Data Streams ha raggiunto 988 milioni di record al secondo. Sono servizi differenti ma collegati dallo stesso problema architetturale: assorbire una quantità enorme di eventi senza costringere ogni applicazione a conoscere la topologia fisica sottostante. È anche il motivo per cui un problema in un hyperscaler può propagarsi molto oltre il singolo cliente: il blackout AWS e le conseguenze sulla dipendenza dalle infrastrutture cloud hanno mostrato l’altra faccia della concentrazione, dove la stessa centralizzazione che consente economie di scala crea dipendenze sistemiche quando una componente critica fallisce.
Prime Day misura anche il control plane invisibile del cloud
I numeri più interessanti non riguardano soltanto le richieste degli utenti. CloudTrail ha elaborato 3,6 trilioni di eventi di attività API in quattro giorni, il 44% in più rispetto al 2025, mentre CloudWatch ha superato 2,15 quadrilioni di osservazioni metriche quotidiane. GuardDuty ha monitorato mediamente 14,08 trilioni di eventi di log ogni ora, con una crescita annua del 59%. Questo significa che la scala applicativa trascina con sé una seconda infrastruttura quasi invisibile composta da logging, telemetria, auditing e analisi di sicurezza. AWS ha inoltre eseguito oltre 44.000 esperimenti tramite Fault Injection Service, più di sei volte quelli del 2025, introducendo deliberatamente condizioni di errore per verificare il comportamento dei sistemi prima del picco reale. L’affidabilità hyperscale non nasce quindi dall’assenza di guasti, ma dalla capacità di osservarli, provocarli in modo controllato e costruire l’architettura assumendo che prima o poi si verificheranno.
Continua con:
Cina accusa USA di cyber-spionaggio, UK regola AWS e Microsoft
Amazon usa Prime Day come stress test della propria architettura cloud
La vera informazione contenuta nei numeri del Prime Day non è quindi che Amazon possieda un’infrastruttura enorme, ma quanto sia diventato complesso coordinare servizi indipendenti perché un evento globale sembri normale all’utente finale. Graviton riduce la dipendenza del compute da architetture esterne, Lambda e Fargate moltiplicano la capacità di scalare workload granulari, DynamoDB e Kinesis assorbono flussi di dati estremi, mentre CloudTrail, CloudWatch, GuardDuty e Fault Injection Service controllano ciò che accade dietro l’interfaccia. Prime Day diventa così uno stress test annuale della strategia AWS: non dimostra che il cloud sia infallibile, ma mostra che la resilienza moderna dipende dalla possibilità di distribuire il rischio tra migliaia di componenti e di osservare in tempo reale una macchina troppo grande per essere governata manualmente.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.