📌 In Sintesi
- SageMaker HyperPod permette ai team di prestare e prendere in prestito capacità inutilizzata mantenendo quote e priorità separate.
- Fair-share, task ranking e preemption decidono quale workload ottiene le GPU quando la capacità condivisa diventa insufficiente.
- AWS sposta il problema dell’AI dalla sola disponibilità degli acceleratori alla capacità di utilizzare ogni ora GPU senza creare silos interni.
Amazon Web Services prova a risolvere uno dei problemi meno visibili della corsa all’intelligenza artificiale: non basta avere GPU, bisogna evitare che restino ferme in un team mentre un altro aspetta capacità. SageMaker HyperPod introduce un modello di governance che permette di assegnare quote, priorità e capacità condivisa tra gruppi diversi sullo stesso cluster, con meccanismi di lending, borrowing e fair-share. Il punto non è soltanto ridurre i costi. AWS sta trasformando la scarsità di acceleratori in un problema di orchestrazione aziendale: chi può usare una GPU, per quanto tempo, con quale priorità e cosa succede quando una risorsa inattiva viene richiesta da un workload più importante.
Cosa leggere
HyperPod trasforma le GPU inattive in capacità prestabile tra team
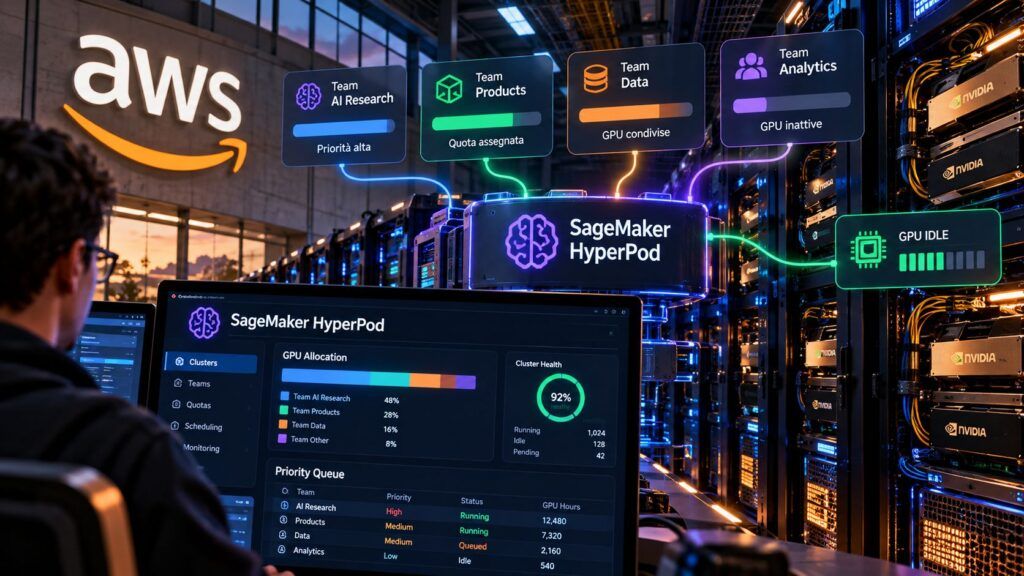
La documentazione ufficiale di SageMaker HyperPod descrive una governance costruita su due livelli: compute prioritization e compute allocation. Ogni team riceve una quota e può, se la policy lo consente, prestare la capacità non utilizzata o prendere in prestito quella lasciata libera dagli altri. Il meccanismo non è un semplice autoscaling: le risorse restano dentro un cluster condiviso e vengono riallocate secondo regole definite dall’amministratore. Con la modalità fair-share, i gruppi ricevono pesi differenti e l’accesso al compute inattivo viene ordinato in base a priorità e livello di borrowing già raggiunto. In alternativa resta il first-come first-served, nel quale un workload può arrivare a occupare tutta la capacità libera disponibile. Il collo di bottiglia si sposta così dalla disponibilità assoluta delle GPU alla qualità della loro utilizzazione.
Leggi anche: GPT-6 Astra arriva su Amazon Bedrock e AWS industrializza agenti, modelli e inferenza
Quote e priorità impediscono che un team monopolizzi il cluster
HyperPod permette di associare a ciascun gruppo una compute quota e limiti percentuali o assoluti sulla capacità che può prendere in prestito. Le policy possono inoltre stabilire classi di priorità per distinguere training, fine-tuning, sperimentazione e inferenza e consentire la preemption dei workload meno importanti quando arriva un task con priorità superiore. È un passaggio rilevante nell’AI enterprise, dove cluster costosi vengono condivisi da ricerca, prodotto e operation con esigenze differenti. La logica completa il percorso con cui AWS sta portando cataloghi, osservabilità e controllo dei workload negli ambienti AI di produzione: il valore non consiste soltanto nell’offrire un modello, ma nel governare il ciclo di vita e soprattutto il consumo della capacità che lo esegue.
L’isolamento è organizzativo prima che fisico
La condivisione non significa che tutti i team operino nello stesso spazio senza separazione. HyperPod associa i gruppi a namespace dedicati e prevede Kubernetes RBAC per definire quali data scientist possano eseguire workload nel perimetro assegnato. È però importante non confondere questa struttura con un isolamento hardware assoluto: il vantaggio nasce proprio dalla possibilità di condividere nodi e acceleratori mantenendo policy, quote e permessi distinti. Per le imprese il compromesso cambia quindi forma. Separare ogni squadra in un cluster dedicato aumenta prevedibilità ma può lasciare GPU inutilizzate; condividere tutto senza governance migliora l’occupazione ma genera conflitti sulle risorse. HyperPod prova a collocarsi nel mezzo, estendendo la funzione industriale che SageMaker ha già assunto nelle pipeline di training avanzato e reinforcement learning.
La scarsità di GPU diventa un problema di scheduling
AWS sostiene che la task governance possa ridurre i costi di sviluppo dei modelli fino al 40%, ma il dato più interessante è architetturale. Il rendimento effettivo di un cluster dipende anche da quante ore vengono perse tra code, capacità riservata e workload incapaci di saturare l’hardware. Il problema è già visibile nella crescita delle AI factory, dove energia, raffreddamento e infrastrutture stanno rallentando l’espansione anche quando il capitale per acquistare gli acceleratori è disponibile. I 68 miliardi di dollari di data center AI bloccati o ritardati negli Stati Uniti mostrano il limite esterno del compute; HyperPod affronta quello interno: una volta ottenuta la capacità, bisogna distribuirla senza trasformare ogni reparto nel proprietario esclusivo di risorse rare.
Amazon costruisce un mercato interno del compute
La direzione è coerente con l’evoluzione di SageMaker. Training distribuito, inferenza, resilienza, osservabilità e governance vengono progressivamente ricondotti allo stesso livello di controllo. In HyperPod anche le risorse non assegnate a una quota possono entrare nel pool condiviso di capacità inutilizzata, mentre il sistema ricalcola la disponibilità quando nodi vengono aggiunti, rimossi o cambiano stato. Questo riduce la necessità di lasciare acceleratori fermi come assicurazione contro eventuali picchi e rende il cluster simile a un mercato interno del compute, nel quale esistono capacità garantita, risorse prestabili, limiti di indebitamento e priorità. È la risposta software allo stesso problema economico creato dall’aumento dei costi dei cluster Nvidia, delle memorie HBM e dell’infrastruttura necessaria per alimentare l’AI.
Continua con:
AWS Agent Registry governa agenti, skill e server MCP in ambiente enterprise
AWS porta governance Dogwood e controllo dei costi negli agenti AI
Il vantaggio competitivo passa dall’utilizzo di ogni ora GPU
La corsa all’AI ha finora premiato chi riusciva ad acquistare più acceleratori. HyperPod indica una seconda fase: conta anche quanto efficacemente vengono utilizzati quelli già installati. In un’infrastruttura con centinaia o migliaia di GPU, pochi punti percentuali di capacità inattiva possono trasformarsi in costi rilevanti e settimane di attesa accumulate dai team. Quote, fair-share, borrowing e preemption non rendono gli acceleratori meno scarsi, ma permettono di trattarli come una risorsa aziendale condivisa anziché come silos separati. È questo il significato industriale della strategia AWS: il collo di bottiglia dell’intelligenza artificiale non consiste soltanto nel procurarsi compute sufficiente, ma nel costruire regole abbastanza precise da impedire che una risorsa costosissima resti ferma mentre un altro workload la sta aspettando.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.