📌 In Sintesi
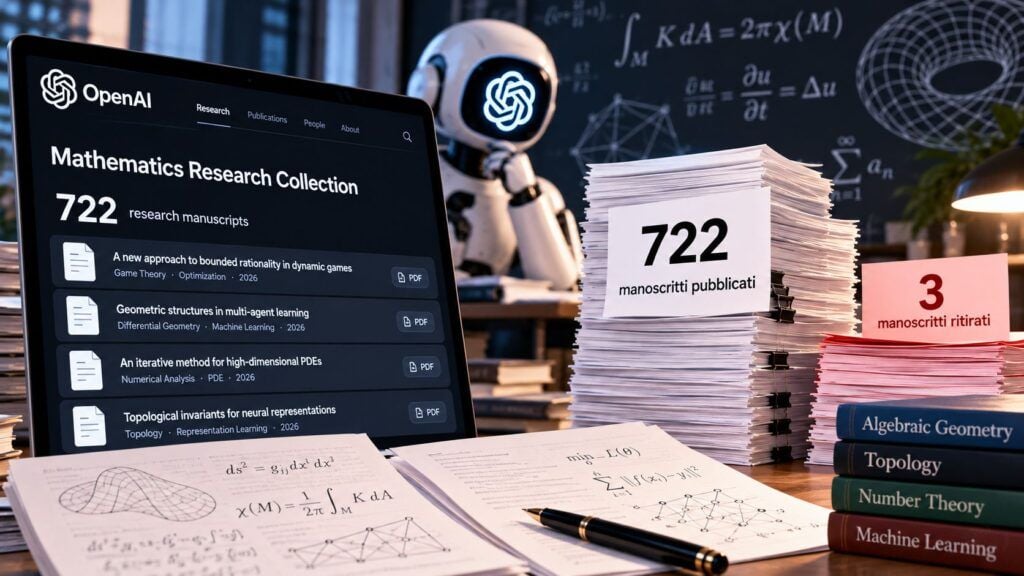
- OpenAI ha pubblicato un catalogo iniziale di 722 manoscritti matematici prodotti in larga parte da un modello interno, organizzati in 372 famiglie.
- Il giorno successivo tre lavori sono stati ritirati per un errore di segno e altri quattordici sono stati corretti o precisati.
- Solo circa il 42% dei risultati principali dispone di una formalizzazione Lean: il nuovo collo di bottiglia non è produrre prove, ma verificarle.
OpenAI ha trasformato la matematica di frontiera in un problema di scala. Il 6 ottobre ha pubblicato un catalogo iniziale di 722 manoscritti prodotti in larga parte da un modello interno non rilasciato, organizzati in 372 famiglie di risultati. Ventiquattro ore dopo, tre lavori sono stati ritirati e altri quattordici corretti. La notizia non è che l’AI “sbaglia matematica”, ma che oggi può produrre ricerca più rapidamente di quanto comunità scientifica, formalizzazione e peer review riescano a verificarla. Il risultato Navier–Stokes resta il caso più forte, ma il nuovo benchmark non è soltanto generare una dimostrazione: è stabilire quali risultati possano davvero entrare nella conoscenza scientifica.
Cosa leggere
Da 722 a 719 manoscritti in ventiquattro ore
Nel repository matematico ufficiale di OpenAI il catalogo corrente conta 719 manoscritti in 372 famiglie. Il rilascio iniziale ne comprendeva 722. La riduzione deriva da tre ritiri registrati il 7 ottobre: un errore di segno nel lavoro “Algebraicity of Weil classes on split abelian eightfolds” invalidava un argomento di cancellazione e la costruzione utilizzata da due paper dipendenti. Secondo la cronologia ufficiale delle revisioni, OpenAI ha quindi ritirato anche i lavori sulla corrispondenza Kuga–Satake per superfici K3 e sulla congettura di Hodge razionale per prodotti di superfici K3. Nello stesso aggiornamento sono stati rivisti altri quattordici manoscritti con riparazioni delle prove, enunciati corretti, ipotesi rese più precise e dipendenze chiarite. Il sistema di versionamento conserva le edizioni precedenti: il catalogo nasce quindi già come corpus scientifico mutabile, non come blocco di risultati definitivamente certificati.
Leggi anche: GPT-6 Astra, mente aliena e Navier-Stokes: il salto che cambia il problema dell’allineamento
Solo il 42% dei risultati principali ha una formalizzazione Lean
OpenAI dichiara esplicitamente che i risultati si trovano a livelli differenti di verifica e che non tutti dispongono di una formalizzazione Lean. Dopo gli ultimi aggiornamenti risultano formalizzati circa 300 risultati principali su 719, pari a circa il 42%. La distinzione è essenziale: una prova formalizzata può essere controllata da un proof assistant rispetto a un sistema logico e alle librerie utilizzate, riducendo drasticamente alcune classi di errore; un manoscritto tradizionale deve invece essere letto, ricostruito e contestualizzato da matematici competenti. Lo stesso repository avverte che alcuni risultati non formalizzati potrebbero contenere problemi. La capacità di produrre argomenti sofisticati non equivale quindi alla certificazione automatica della loro correttezza, una separazione che ricorda il problema già emerso quando GPT-6 Astra ha mostrato capacità tecniche crescenti insieme a maggiori difficoltà di monitoraggio.
Navier-Stokes resta il risultato simbolo ma il premio non è automatico
Il caso Navier–Stokes resta di un’altra categoria perché, nella pubblicazione ufficiale sulla soluzione, OpenAI ha diffuso sia il manoscritto sia una formalizzazione in Lean della prova con cui il proprio sistema interno sostiene che le equazioni tridimensionali possano sviluppare una singolarità in tempo finito. Il Clay Mathematics Institute ha reagito parlando di un problema che “apparentemente” è stato risolto, ma ha contemporaneamente ricordato che il processo di valutazione dei Millennium Prize è deliberatamente lento. Le regole richiedono la pubblicazione in una sede qualificata, almeno due anni dalla pubblicazione e l’accettazione generale da parte della comunità matematica internazionale prima che una soluzione venga presa in considerazione. La formalizzazione rende il risultato molto più forte di una semplice risposta generata da un modello, ma non sostituisce automaticamente la validazione scientifica complessiva. È proprio questa distanza tra risultato, verifica formale e riconoscimento comunitario a impedire di trasformare ogni output eccezionale in un titolo sulla “matematica risolta dall’AI”.
Quattromila problemi trasformano la ricerca in una pipeline industriale
Il dato industriale è forse ancora più significativo dei singoli teoremi. OpenAI afferma di avere sottoposto al modello circa 4.000 problemi e che la grande maggioranza dei risultati è stata ottenuta attraverso una procedura relativamente uniforme, con un consumo medio equivalente a circa tre ore di “thinking compute” di ChatGPT Pro per risultato. Da questa campagna sono emerse centinaia di famiglie di manoscritti, proof artifact e formalizzazioni. La generazione di ipotesi e prove entra così in una logica da pipeline, nella quale il costo marginale di tentare un altro problema può diminuire molto più velocemente del costo umano necessario per leggere e contestualizzare l’output. È una conseguenza che rende ancora più attuale la critica alla narrazione magica dell’intelligenza artificiale e la centralità del metodo sperimentale: più la produzione diventa abbondante, meno il volume può essere usato come sinonimo di affidabilità.
Continua con:
Umani e LLM: le linee di faglia epistemologiche dell’intelligenza artificiale
Il nuovo collo di bottiglia scientifico è riuscire a verificare abbastanza velocemente
I tre ritiri non annullano il valore del catalogo e non dimostrano che i restanti manoscritti siano errati. Dimostrano qualcosa di più utile: la velocità di produzione dei modelli ha già superato la capacità di trattare ogni risultato come un paper tradizionale isolato. Se centinaia di dimostrazioni possono essere generate in pochi giorni o settimane, peer review, controllo delle dipendenze, verifica delle citazioni, formalizzazione e replica diventano la risorsa scarsa. In matematica una parte di questo problema può essere affrontata con Lean e altri proof assistant; in discipline sperimentali la validazione richiede anche dati, laboratori, repliche e tempo fisico. Il punto epistemologico è quindi operativo: un risultato generato dall’AI non diventa conoscenza perché è plausibile, elegante o numeroso, ma perché resiste a procedure di controllo indipendenti. La vera svolta sarà raggiunta quando l’automazione non scalerà soltanto la produzione delle prove, ma anche la capacità di falsificarle, verificarle e ritirarle prima che la quantità venga scambiata per certezza.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.