📌 In Sintesi
- Coinbase ha post-addestrato Qwen3.5-9B sui propri dati antifrode Onramp attraverso reinforcement learning con ricompense verificabili.
- Nel benchmark interno il modello supera Opus 4.5 su tutte e quattro le metriche di rilevamento, con F1 superiore del 9,6%.
- Il deployment self-hosted riduce del 55% la latenza mediana e impedisce che il contesto delle transazioni debba transitare attraverso API LLM esterne.
Coinbase ha scelto di affrontare il problema delle frodi sui pagamenti facendo l’opposto di gran parte del mercato enterprise: invece di affidarsi continuamente al modello proprietario più recente, ha preso Qwen3.5-9B, modello open-weight da nove miliardi di parametri, e lo ha post-addestrato sui propri dati antifrode. Il risultato dichiarato dall’exchange è rilevante perché nel benchmark costruito sull’attività di Coinbase Onramp il modello specializzato ha superato Opus 4.5 su tutte le quattro metriche utilizzate, ottenendo un F1 superiore del 9,6% e riducendo contemporaneamente del 55% la latenza end-to-end in produzione. Non dimostra che Qwen sia in assoluto migliore dei grandi modelli proprietari: dimostra qualcosa di più interessante per le imprese, cioè che un modello più piccolo e controllabile può battere un frontier model quando viene addestrato per una decisione estremamente verticale.
Cosa leggere
Coinbase prende Qwen3.5-9B e lo addestra sulle proprie frodi
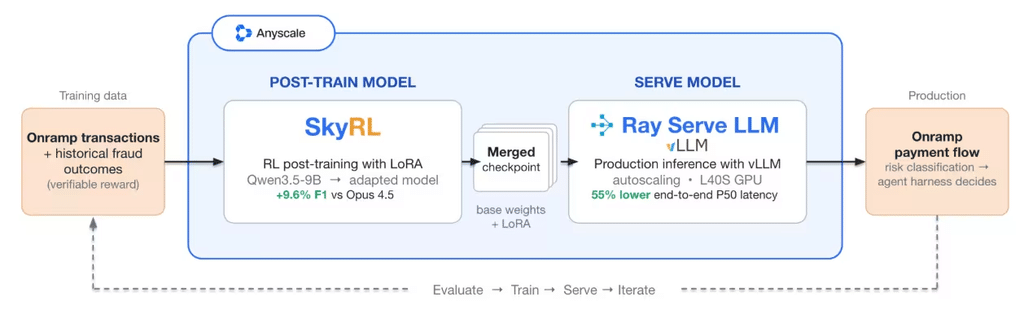
La ricerca pubblicata direttamente da Coinbase Engineering descrive una pipeline costruita attorno ai dati proprietari di Onramp, il servizio che permette agli utenti di acquistare criptovalute attraverso pagamenti tradizionali. Coinbase utilizza SkyRL su Anyscale per il post-training di Qwen3.5-9B e successivamente serve il checkpoint attraverso Ray Serve LLM e vLLM. Il modello non sostituisce l’intera infrastruttura antifrode: interviene dopo i modelli ML e le regole esistenti, analizza il comportamento recente associato alla transazione e restituisce una classificazione del rischio, mentre il livello applicativo continua a tradurre quella classificazione nella decisione operativa. La scelta di un modello da nove miliardi di parametri non è casuale: Coinbase sottolinea che questa dimensione rende possibile anche il serving su singola GPU, riducendo il peso infrastrutturale rispetto a sistemi molto più grandi. È la stessa logica di efficienza che emerge nella crescita dei modelli open-weight, già evidente quando Qwen 3.8 è stato portato su SageMaker HyperPod con vLLM.
Leggi anche: Coinbase sotto attacco: deepfake vocali, agenti corrotti e maxifurti
I modelli più nuovi possono peggiorare proprio dove conta
La decisione di costruire un modello proprietariamente specializzato nasce da un risultato precedente ancora più significativo. Nella seconda parte dello studio Coinbase, l’exchange ha confrontato diverse generazioni di Opus, Sonnet e GPT sullo stesso benchmark antifrode composto da 16.140 transazioni relative a 7.293 utenti, comprese 813 transazioni successivamente confermate come fraudolente. In tutti e tre i confronti, la versione più recente del modello ha mostrato un peggioramento di recall, F1 e dollar-weighted recall. GPT-5.6, per esempio, ha migliorato la precisione ma ha perso oltre venti punti di recall rispetto alla versione precedente, segnale di una classificazione più conservativa che riduce i falsi positivi ma lascia passare più frodi. È un risultato importante perché mostra il limite dei benchmark generalisti: un modello complessivamente più capace non è automaticamente un modello migliore per una decisione finanziaria specifica. Per Coinbase cambiare modello significa modificare indirettamente la policy di rischio, anche quando prompt e applicazione restano identici.
Reinforcement learning sulle frodi reali batte il modello generalista
Coinbase ha quindi utilizzato Reinforcement Learning with Verifiable Rewards, confrontando le classificazioni prodotte dal modello con gli esiti storici verificati delle transazioni. Invece di premiare risposte linguisticamente convincenti, il sistema assegna la ricompensa sulla base di un risultato deterministico: quella transazione si è rivelata fraudolenta oppure no. Il post-training consente così di spostare il decision boundary del modello verso il problema reale dell’exchange.
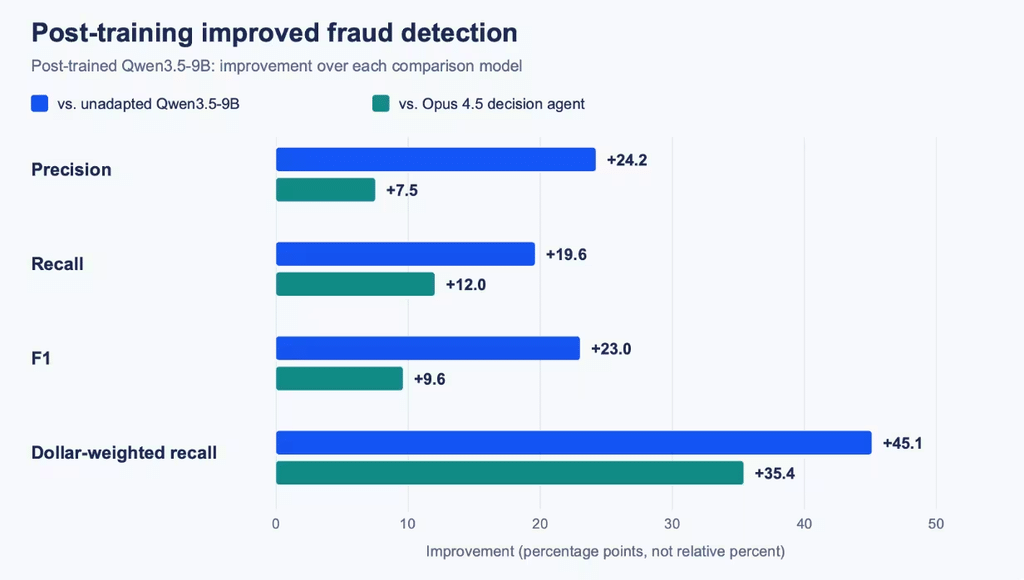
Nel benchmark interno Qwen3.5-9B post-addestrato supera Opus 4.5 su precision, recall, F1 e dollar-weighted recall, mentre in produzione il tempo mediano end-to-end scende da 1,515 secondi a 0,683 secondi; al percentile 99 passa da 3,312 a 1,036 secondi. Anche in questo caso i risultati sono quelli pubblicati da Coinbase e dovranno essere valutati come benchmark proprietari, ma il vantaggio architetturale è concreto: un modello open-weight permette di modificare i pesi, controllare il checkpoint e ottimizzare direttamente l’inferenza. La tendenza era già visibile nell’evoluzione di Qwen-Image 2.1 verso modelli più piccoli e distribuibili privatamente.
Continua con:
Apple Intelligence in Cina passa attraverso Qwen e un’infrastruttura AI differente
Anthropic accusa Alibaba sul fronte AI mentre cresce la competizione tra modelli
Il vero vantaggio è togliere il rischio finanziario dalle API esterne
Il passaggio più importante riguarda infine il controllo dell’infrastruttura. Con un modello proprietario accessibile via API Coinbase può valutare prompt, output e prestazioni, ma non può cambiare i pesi né impedire che una nuova versione modifichi improvvisamente il comportamento del classificatore. Con Qwen3.5-9B post-addestrato e self-hosted può invece scegliere il checkpoint, decidere quando aggiornarlo, mantenere insieme versione del modello, prompt e policy decisionale e soprattutto tenere il contesto delle transazioni fuori dalle API di un provider esterno. Questo non elimina il rischio: le frodi cambiano, il modello deve essere continuamente rivalutato e un checkpoint specializzato può degradare esattamente come un sistema proprietario. Ma sposta il vantaggio competitivo. Nel risk management finanziario l’AI più utile potrebbe non essere quella con più parametri o il punteggio generale più alto, bensì quella che l’azienda può addestrare sui propri eventi, verificare contro risultati economici reali e servire con costi e latenze prevedibili. Coinbase sta dimostrando che la corsa ai frontier model può avere meno valore della proprietà del ciclo completo: dati, benchmark, training e inferenza.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.