📌 In Sintesi
- Nei test long-context su DeepSeek V4 lo stesso dato può essere recuperato con accuratezze molto diverse soltanto spostandolo di pochi token.
- Il divario tra le posizioni migliori e peggiori arriva fino a 40,2 punti percentuali e segue esattamente lo stride utilizzato per comprimere la KV cache.
- Il problema non dimostra che DeepSeek sia generalmente inaccurato: mostra che i benchmark medi possono nascondere punti deboli periodici nella memoria compressa.
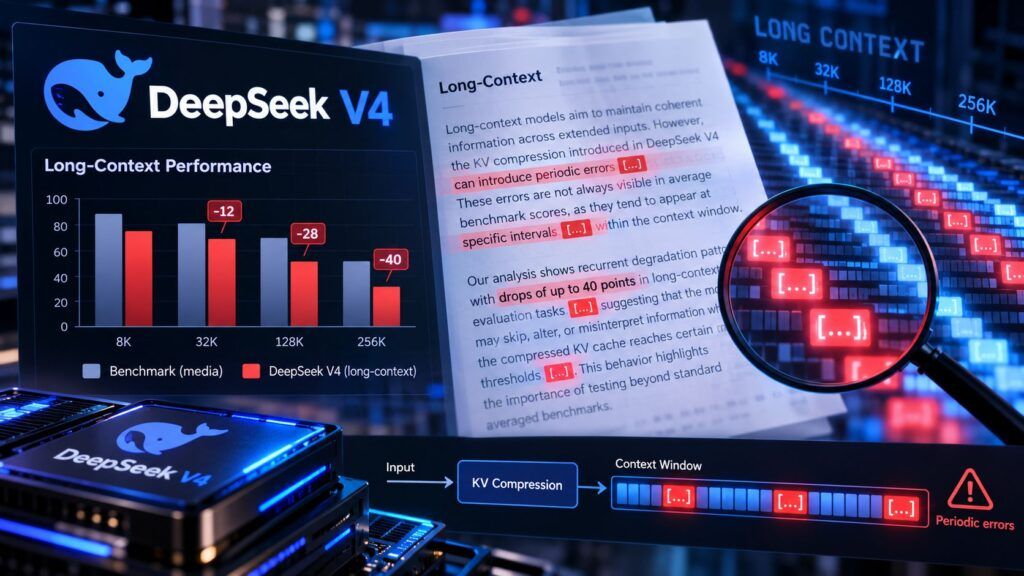
DeepSeek V4 non ha semplicemente un problema di “accuratezza” causato dal risparmio di memoria. Una nuova ricerca firmata da studiosi di ByteDance Seed, Princeton, Stanford e University of California Berkeley identifica un comportamento molto più preciso: nei modelli che comprimono la KV cache a finestre, la capacità di recuperare la stessa informazione può cambiare sensibilmente in base alla posizione del dato rispetto ai confini della compressione. Nei test long-context sulla famiglia DeepSeek V4 il divario tra le posizioni migliori e peggiori arriva fino a 40,2 punti percentuali. Il contenuto non cambia e nemmeno la domanda: bastano pochi token di spostamento. È un limite rilevante perché può restare completamente nascosto quando un benchmark restituisce soltanto una media complessiva.
Cosa leggere
DeepSeek V4 cambia risposta quando il codice viene spostato di pochi token
Lo studio Periodic Weak Spots: Phase Sensitivity from Chunked KV-Cache Compression parte da un esperimento quasi minimale. I ricercatori chiedono a DeepSeek-V4-Flash-Base di completare una porzione del codice ufficiale di inferenza del modello, dove la continuazione corretta è 8. Davanti allo stesso codice aggiungono una docstring decorativa e modificano soltanto il numero di caratteri utilizzati come riempitivo. Su sedici lunghezze comprese tra 24 e 39 token, la previsione principale alterna periodicamente tra 8 e l’errato 32. Il ciclo si ripete ogni quattro token, esattamente lo stride della Compressed Sparse Attention di DeepSeek V4. L’effetto compare anche nelle versioni post-addestrate V4-Flash-0731 e V4.1-Flash, seguendo lo stride adottato da ciascun modello. La differenza rispetto a un normale errore di ragionamento è sostanziale: l’informazione disponibile resta identica, cambia soltanto dove finisce dentro la memoria compressa.
Leggi anche: DeepSeek V4.1 Flash sfida Kimi K3 mentre Alibaba porta gli agenti nelle app rivali
La KV cache fa risparmiare memoria ma introduce una nuova coordinata
Durante la generazione un transformer conserva nella KV cache le rappresentazioni key e value dei token già elaborati, evitando di ricostruirle ogni volta che produce un nuovo token. Nei contesti molto lunghi questo meccanismo diventa però costoso perché memoria occupata e lavoro dell’attenzione aumentano insieme alla sequenza. DeepSeek V4 comprime quindi gruppi consecutivi di token in un numero inferiore di entry. La ricerca mostra che questa scelta introduce una coordinata che nei modelli full-attention non produce lo stesso fenomeno: la phase, cioè la posizione del token rispetto all’inizio della finestra di compressione. Con stride quattro, spostare un passaggio di uno, due o tre token modifica il modo in cui viene raggruppato e sintetizzato. Non è un dettaglio accademico: la KV cache è diventata un vero collo di bottiglia dell’inferenza, al punto che Huawei la sta trattando come una classe di dato da distribuire tra HBM, memoria e storage dedicato. L’efficienza ottenuta comprimendo il contesto introduce quindi un nuovo problema di affidabilità nella conservazione delle informazioni.
A 128.000 token il divario arriva a 40,2 punti percentuali
Per misurare il fenomeno senza dipendere dal singolo esempio di coding, gli autori costruiscono un test needle-in-a-haystack con prompt da 128.000 token contenenti 16.000 coppie chiave-valore. La stessa informazione bersaglio viene collocata in posizioni differenti rispetto alle finestre di compressione, mantenendo invariati lunghezza del prompt, query e associazioni tra chiavi e valori. Tutti i cinque modelli DeepSeek analizzati mostrano phase sensitivity. Nei checkpoint base il gap massimo tra la posizione migliore e quella peggiore raggiunge 40,2 punti percentuali; il post-training migliora l’accuratezza e restringe il divario, ma nei modelli V4 il fenomeno rimane evidente. DeepSeek V4.1-Flash presenta il gap minore, eppure tutti i gruppi pari restano sistematicamente sopra quelli dispari. Non significa che una richiesta su due fallisca: significa che esiste una struttura periodica dell’affidabilità che il punteggio medio può nascondere. È un limite particolarmente importante per una famiglia che Matrice Digitale aveva già analizzato come parte della corsa cinese verso modelli più efficienti e capaci di operare su workload agentici estesi.
I test su Qwen dimostrano che il problema nasce dalla compressione
Per separare l’effetto della KV cache dalle numerose altre peculiarità architetturali di DeepSeek, il gruppo ha addestrato da zero una famiglia di transformer basati sull’architettura Qwen3-0.6B, mantenendo la compressione come principale variazione rispetto ai baseline. Il risultato è netto: tutte le configurazioni compresse mostrano periodicità coerenti con lo stride, mentre i modelli full-attention rimangono sostanzialmente piatti. In alcuni modelli sperimentali il divario supera perfino 70 punti, ma quei numeri appartengono ai sistemi controllati costruiti per l’esperimento e non devono essere attribuiti direttamente a DeepSeek V4. Le analisi causali individuano inoltre una phase specialization: alcuni attention head diventano particolarmente importanti per recuperare informazioni collocate in determinate posizioni della finestra. Il difetto non dipende quindi soltanto dal caso intuitivo nel quale chiave e valore vengono separati dal confine tra due blocchi. Le differenze restano molto ampie anche tra posizioni nelle quali entrambi rimangono nella stessa finestra, suggerendo che durante il training alcuni componenti imparino a privilegiare determinati offset.
Continua con:
Kimi K3 e la fine del mito della superiorità indiscussa dell’AI occidentale
Deployment di Qwen 3.8 su SageMaker HyperPod con vLLM e otto GPU B300
I benchmark long-context devono misurare anche dove si trova il dato
La conseguenza più importante riguarda quindi il modo in cui vengono valutati i modelli. Un benchmark può assegnare un buon punteggio medio a un sistema che presenta comunque posizioni strutturalmente deboli, perché risultati elevati in alcune fasi compensano quelli bassi nelle altre. Gli autori propongono di testare lo stesso contenuto spostandolo di pochi token e misurando la performance attraverso tutte le fasi della compressione. Per applicazioni che lavorano su repository software, contratti, documentazione tecnica o memoria persistente degli agenti, la questione è concreta: un’informazione importante non dovrebbe diventare più difficile da recuperare soltanto perché una riga precedente contiene qualche token in più. La ricerca non dimostra che DeepSeek V4 sia generalmente meno affidabile di modelli privi di compressione e non misura una generica propensione alle allucinazioni. Dimostra però un trade-off architetturale finora poco visibile: ridurre il costo della memoria nei contesti estremamente lunghi può creare punti ciechi periodici. Il nuovo parametro da osservare non è quindi soltanto quanti token un modello dichiara di poter accettare, ma quanto uniformemente riesce a ricordarli.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.