📌 In Sintesi
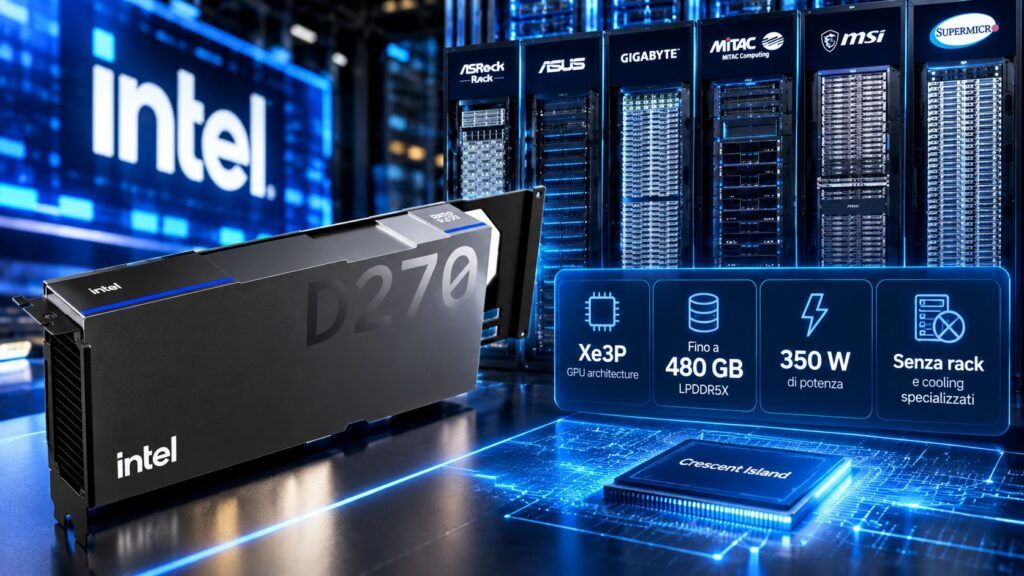
- Intel D-Series porta Crescent Island fino a 480 GB di LPDDR5X, 1,5 TB/s di banda e 1,3 PFLOPS FP8 entro un envelope da 350 watt.
- Una singola scheda può ospitare modelli fino a 300 miliardi di parametri, mentre otto GPU superano la soglia del trilione secondo Intel.
- La strategia combina GPU PCIe raffreddate ad aria, Xeon 6+ e standard OCP per evitare infrastrutture proprietarie costruite attorno a un solo acceleratore.
Intel prova a entrare nella nuova guerra dell’inferenza senza inseguire Nvidia sul terreno della GPU più estrema. La D-Series, precedentemente nota come Crescent Island, viene posizionata attorno a un equilibrio differente: molta memoria, consumi relativamente contenuti, formato PCIe convenzionale e compatibilità con data center già esistenti. La configurazione progettuale può arrivare a 480 GB di LPDDR5X, 1,5 TB/s di banda e 1,3 petaflops FP8 con un envelope di 350 watt, mentre il design di riferimento Intel utilizza 160 GB. Il punto industriale è evidente: con i modelli open-weight e gli agenti che moltiplicano le richieste di inferenza, Intel tenta di ridurre il costo necessario per mantenere grandi modelli residenti in memoria senza imporre rack specializzati, liquid cooling e piattaforme proprietarie. La sfida non è produrre la GPU più potente in assoluto, ma rendere più economico il token generato in modo continuativo.
Cosa leggere
D-Series usa 480 GB di LPDDR5X per attaccare il collo di bottiglia della memoria
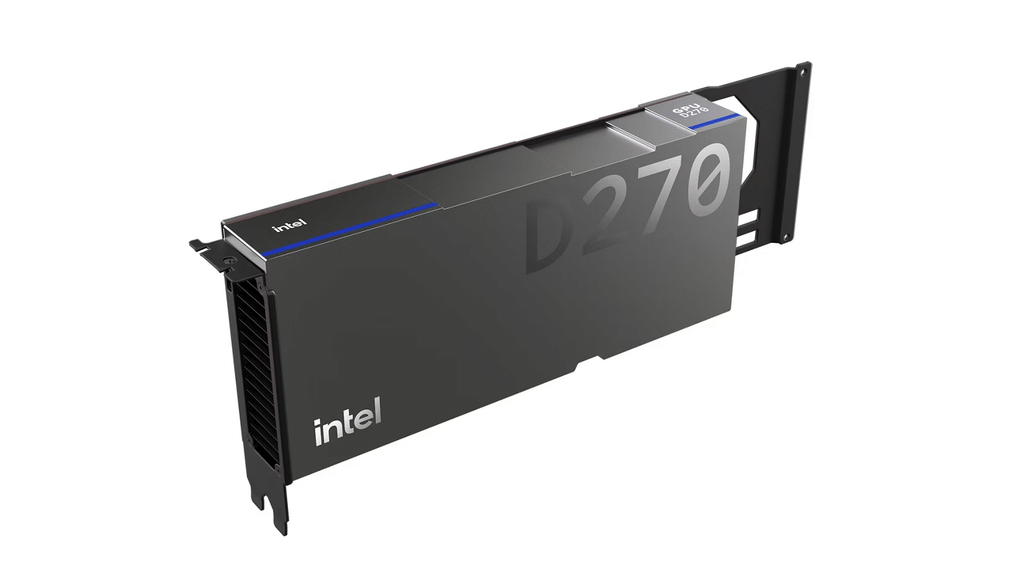
Nel nuovo annuncio tecnico pubblicato da Intel la D-Series viene descritta come un acceleratore basato sull’architettura Xe3P, progettato specificamente per inferenza sostenuta e workload memory-intensive. Intel dichiara fino a 480 GB di LPDDR5X nelle implementazioni ODM, 1,5 TB/s di bandwidth e 1,3 PFLOPS FP8. La scelta della LPDDR5X al posto di una configurazione interamente HBM sacrifica parte della banda estrema disponibile sulle piattaforme AI più costose, ma permette di aumentare enormemente la capacità mantenendo consumi e costi sotto controllo.
È una decisione coerente con workload dove il problema non è soltanto moltiplicare i FLOPS, ma tenere un modello molto grande residente vicino al calcolo evitando continui trasferimenti e parallelizzazioni tra più nodi. La strategia era già emersa quando Crescent Island era comparsa nel confronto tra Jalapeño, Nvidia Vera e le nuove architetture per l’AI agentica; oggi Intel aggiunge le specifiche operative e conferma che il sampling ai clienti è già iniziato.
Leggi anche: OpenAI rompe il fronte Nvidia: Jalapeño apre la guerra dei chip agentici
Una sola scheda punta a modelli da 300 miliardi di parametri
Intel sostiene che una D-Series possa gestire modelli fino a 300 miliardi di parametri su una singola scheda, mentre una configurazione con otto GPU può superare il trilione di parametri. Il dato dipende evidentemente da precisione, quantizzazione, KV cache e dimensione del contesto e non equivale a dire che qualunque modello da 300 miliardi possa essere eseguito senza compromessi alla massima qualità. La capacità di memoria resta però il segnale più interessante.
L’inferenza di modelli open-weight sempre più grandi sta trasformando RAM e bandwidth in parametri competitivi quasi quanto il compute teorico, soprattutto nei servizi multi-tenant, nei long-context workload e negli agenti che devono mantenere simultaneamente più sessioni. È la stessa pressione che ha portato Nvidia a ridisegnare DGX Spark attorno alla quantità di memoria disponibile per l’AI locale: la dimensione del modello utilizzabile diventa direttamente un attributo commerciale dell’hardware.
I 350 watt e il PCIe mostrano quale mercato vuole Intel
Il limite di 350 watt e il formato PCIe standard sono forse più significativi dei petaflops dichiarati. Intel vuole che la D-Series possa entrare nei server raffreddati ad aria senza obbligare l’operatore a ricostruire alimentazione e cooling attorno all’acceleratore. È una strategia diversa dalle piattaforme AI più dense, dove rack da decine o centinaia di kilowatt, networking proprietario e raffreddamento liquido diventano parte integrante del prodotto. Crescent Island tenta invece di abbassare la soglia infrastrutturale: un’impresa dovrebbe poter aggiungere acceleratori a un data center esistente mantenendo chassis, PCIe e stack software relativamente familiari. Questo non garantisce prestazioni migliori di Blackwell o degli ASIC hyperscaler, ma sposta il confronto sul total cost of ownership. Se l’inferenza diventa il workload dominante, non sempre vince il dispositivo con il massimo throughput teorico: può vincere quello che permette di installare più memoria e più sessioni senza rifare il data center.
Xeon 6+ resta il coordinatore che deve tenere occupate le GPU
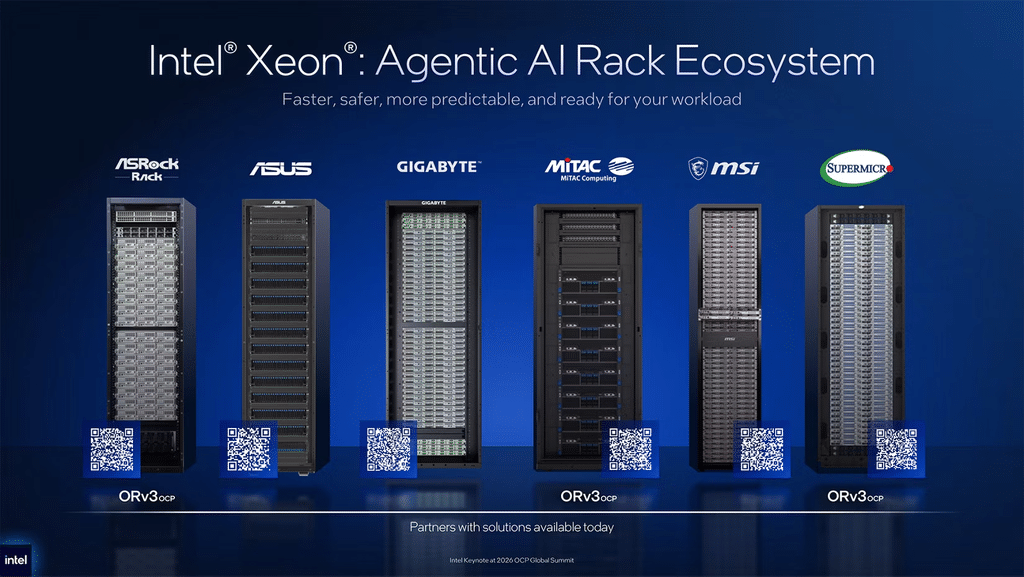
Intel accompagna la D-Series con nuovi design rack basati su Xeon 6+, alcuni costruiti attorno allo standard Open Rack v3 dell’Open Compute Project. Configurazioni selezionate possono superare i 46.000 core CPU per rack con una potenza totale dichiarata di 133,45 kW. La presenza massiccia della CPU non è accessoria. Un workflow agentico deve recuperare dati, orchestrare strumenti, gestire I/O, eseguire codice, chiamare servizi e soltanto in alcune fasi inviare lavoro al modello. È la stessa ragione per cui Nvidia sta spingendo Vera come CPU dedicata alla nuova fabbrica AI. Intel possiede però un vantaggio storico: la base x86 già installata nei data center. Il percorso iniziato con Xeon 6 e l’aumento della densità di core nei server viene così reinterpretato: la CPU non deve sostituire la GPU, ma alimentarla continuamente con dati, tool ed esecuzioni parallele.
L’arma di Intel è l’infrastruttura aperta contro gli ecosistemi verticali
La parte più politica dell’annuncio riguarda software e standard. Intel insiste sulla stessa base Xe per più generazioni di GPU, sull’integrazione upstream con framework e inference runtime e sul supporto immediato ai nuovi modelli open. Parallelamente partecipa all’Open Adapter Card workgroup di OCP per definire form factor standardizzati per gli acceleratori. L’obiettivo è contrastare il modello nel quale GPU, interconnessione, rack, cooling e software finiscono progressivamente dentro un’unica piattaforma controllata dallo stesso vendor. Intel vende quindi l’interoperabilità come alternativa al lock-in, puntando sulle aziende che vogliono cambiare acceleratore senza ricostruire l’intera infrastruttura. È una scommessa importante perché il vantaggio Nvidia non deriva soltanto dall’hardware, ma dalla profondità dell’ecosistema CUDA, dal networking e dalla disponibilità di sistemi validati.
Continua con:
Nvidia Blackwell porta l’AI agentica verso l’uso industriale
OpenAI e Synopsys trasformano GPT in un progettista nativo di chip
Crescent Island prova a vincere dove la GPU più potente costa troppo
La D-Series non dimostra che Intel abbia recuperato il vantaggio tecnologico di Nvidia nell’accelerazione AI. Non esistono ancora benchmark indipendenti sufficienti per confrontare throughput, latenza e costo per token delle piattaforme in condizioni equivalenti. Il segnale industriale è però rilevante: Intel ha smesso di trattare l’inferenza come una versione ridotta del training e sta progettando hardware attorno ai suoi vincoli specifici. Molta memoria, 350 watt, PCIe, raffreddamento ad aria e stack aperto descrivono una piattaforma pensata per aziende che non vogliono costruire un supercomputer ogni volta che distribuiscono un nuovo modello. Se l’AI agentica aumenterà davvero il numero di inferenze molto più rapidamente della dimensione dei training cluster, il mercato potrebbe premiare proprio questo compromesso. La partita di Crescent Island non è quindi stabilire chi possiede il chip più veloce: è stabilire quanto costa tenere migliaia di agenti attivi quando il modello deve restare sempre in memoria.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.