📌 In Sintesi
- Linus Torvalds ha utilizzato un LLM durante lo sviluppo di una serie di dieci patch per ridurre la contesa sui reference count delle pagine nella page cache Linux.
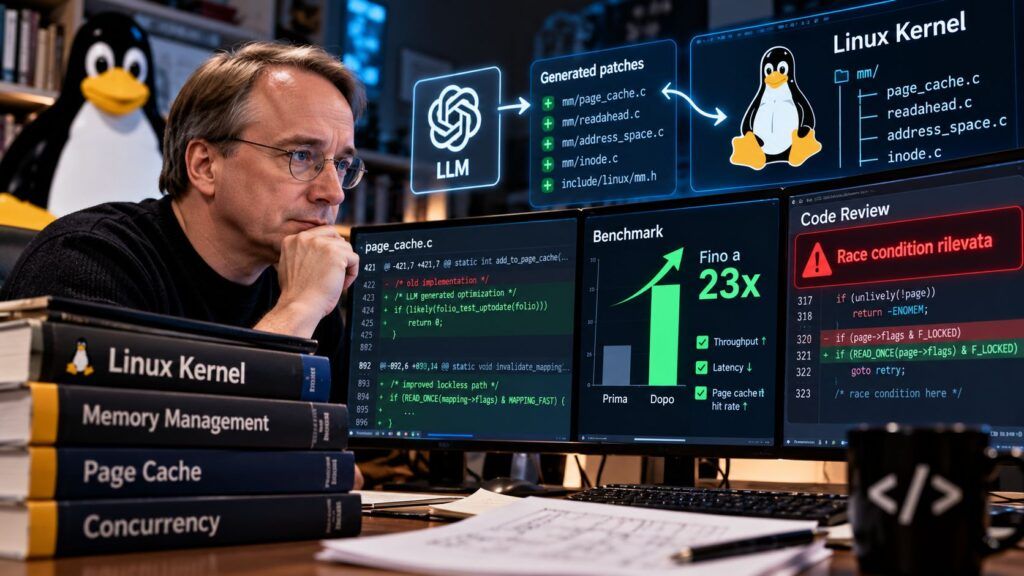
- Nel benchmark sintetico su Ryzen Threadripper il throughput con 64 thread passa da 13,3 a 304 milioni di letture al secondo, circa 23 volte tanto, ma Torvalds stesso avverte che nessun workload reale otterrà numeri simili.
- La review pubblica ha già individuato una race condition, mostrando il punto centrale del caso: l’AI entra nello sviluppo del kernel, ma validazione e responsabilità restano umane.
Linus Torvalds ha fatto qualcosa di molto più importante che dichiararsi favorevole o contrario all’intelligenza artificiale: l’ha utilizzata per lavorare a una modifica reale del kernel Linux e ha sottoposto il risultato alla normale revisione pubblica degli sviluppatori. La serie di dieci patch affronta un vecchio problema di scalabilità della page cache quando numerosi processori leggono contemporaneamente le stesse pagine di un file. In un test volutamente artificiale eseguito sul proprio Ryzen Threadripper, Torvalds passa da 13,3 milioni a 304 milioni di letture al secondo con 64 thread, un incremento di circa 23 volte. Ma proprio mentre il numero iniziava a trasformarsi nel classico titolo sull’“AI che rivoluziona Linux”, la mailing list ha fatto ciò per cui il kernel continua a funzionare: altri sviluppatori hanno letto il codice e hanno individuato una race condition.
Cosa leggere
Torvalds usa un LLM su un problema che il kernel trascinava da anni
Nella mail originale inviata alla Linux Kernel Mailing List Torvalds ricostruisce un problema affrontato da diversi sviluppatori negli ultimi due anni: la scalabilità del reference counting delle pagine durante normali operazioni read() e pread(). Quando molti core accedono ripetutamente alla stessa porzione di file, l’aggiornamento del reference count costringe le CPU a contendersi la stessa cacheline. A bassi livelli di parallelismo il costo può rimanere marginale; aumentando i thread, la cache coherence diventa il vero collo di bottiglia. Torvalds aveva già provato una soluzione nel 2024 e ammette di avere utilizzato per circa un anno e mezzo sul proprio portatile una versione successivamente riconosciuta come imperfetta. Altri sviluppatori avevano tentato approcci differenti senza risolvere completamente il problema. In vista del Kernel Maintainer Summit, dove l’uso degli LLM era uno dei temi di discussione, Torvalds ha quindi deciso di provare a risolvere nuovamente il problema utilizzando un modello come strumento di sviluppo. È un passaggio coerente con la posizione assunta nei mesi precedenti. Torvalds aveva già respinto l’idea di vietare per principio l’AI nella code review del kernel, sostenendo che uno strumento debba essere giudicato sulla qualità del lavoro prodotto e non sulla categoria tecnologica alla quale appartiene. Il nuovo esperimento sposta però la discussione dalla teoria alla pratica.
Leggi anche: GitHub Copilot salva il driver R600 e prolunga la vita delle Radeon HD storiche
La soluzione evita il reference count sul percorso di lettura più veloce
La serie proposta modifica il modo in cui il kernel tratta i folio “hot”, cioè le aree della page cache che vengono lette ripetutamente. L’idea è marcare alcune di queste pagine affinché la loro liberazione venga ritardata fino al completamento di un periodo RCU, Read-Copy-Update. In questo modo il kernel può mantenere sia il lookup sia l’accesso ai dati all’interno di una regione protetta da RCU e, nei casi in cui la copia verso lo userspace non genera page fault, evitare completamente l’incremento e il decremento del reference count nel fast path.
Il beneficio è soprattutto architetturale. Il reference count resta corretto e necessario in moltissimi scenari, ma viene eliminata una scrittura condivisa dalla situazione nella quale decine di CPU continuano a leggere la stessa pagina. È precisamente quella scrittura a provocare il rimbalzo della cacheline tra i core. Linux continua quindi a proteggere la durata del folio, ma lo fa ritardandone la liberazione invece di obbligare ogni reader a modificare continuamente uno stato condiviso.
Il benchmark vola da 13,3 a 304 milioni di letture al secondo
Il numero più spettacolare arriva dal benchmark incluso nella serie. Con 64 thread, il codice precedente si ferma a circa 13,3 milioni di letture al secondo e arriva a consumare quasi 20.000 cicli per lettura. Dopo la modifica, Torvalds misura circa 304 milioni di letture al secondo, con circa 735 cicli per operazione. Il miglioramento sfiora quindi 23 volte. Torvalds stesso distrugge però qualsiasi tentativo di presentarlo come un aumento generale delle prestazioni di Linux: il test consiste nel leggere ripetutamente una piccola parte della stessa pagina da tutti i processori. È costruito appositamente per massimizzare la contesa sul reference count e quindi per mostrare cosa succede quando quella contesa viene eliminata. Applicazioni reali, server Web e database leggono dataset molto più complessi e incontrano numerosi altri colli di bottiglia. Il 23x dimostra che il problema specifico viene rimosso, non che Linux diventa 23 volte più veloce. È una distinzione importante in un momento nel quale i risultati degli strumenti AI vengono spesso trasformati in benchmark assoluti. Linux è ormai l’infrastruttura invisibile di server, cloud, Android e sistemi embedded, quindi una modifica al comportamento della memoria deve funzionare molto oltre il test che ne ha motivato lo sviluppo.
La mailing list trova subito una race condition
La parte più interessante arriva infatti dopo la pubblicazione. Kirill Shutemov ha individuato una race in filemap_read_rcu_batch(): in determinate condizioni un folio può essere sostituito mentre il percorso RCU sta ancora lavorando e, combinando la sostituzione con una modifica di i_size, il reader potrebbe accedere a dati che non sono stati realmente scritti. La discussione successiva ha già prodotto modifiche alla posizione dei controlli e ulteriori verifiche sull’ordinamento delle operazioni. Non è una prova del “fallimento dell’AI”. È la dimostrazione del contrario rispetto alla narrativa più estrema: il codice generato o assistito da AI entra nello stesso processo di review del codice scritto interamente da una persona. Se contiene una race, la race deve essere trovata. Se le primitive RCU o le transizioni di stato del folio non sono corrette, non importa quante righe abbia prodotto il modello né quanto impressionante sia il benchmark.
Il kernel abbandona anche l’idea di marchiare ogni patch assistita dall’AI
Il caso arriva mentre la comunità Linux sta contemporaneamente ridimensionando il valore di una regola simbolica: l’obbligo di indicare attraverso il tag Assisted-by l’utilizzo di strumenti AI. Il Kernel Maintainers Summit ha raggiunto un consenso verso la rimozione di tale requisito. Per Torvalds, l’elemento determinante è che l’autore della patch comprenda e si assuma la responsabilità del codice inviato, indipendentemente dal fatto che abbia utilizzato un compilatore, un IDE, uno strumento di analisi statica o un LLM. La posizione non equivale ad accettare automaticamente codice generato. Anzi, aumenta implicitamente il peso della responsabilità del contributor. Un modello può produrre una soluzione plausibile, ma chi firma la patch deve sapere perché funziona, quali invarianti modifica e quali condizioni di concorrenza potrebbe introdurre. È la stessa filosofia emersa quando Debian e il kernel hanno iniziato a definire il rapporto tra open source e strumenti generativi: nessun divieto ideologico, ma nessuna delega della responsabilità.
Continua con:
Linux compie 35 anni e resta l’infrastruttura invisibile del digitale
Linux 7.2 amplia hardware, driver e supporto delle nuove piattaforme
Torvalds mostra il modello più realistico di AI coding: generare, capire e poi farsi correggere
Il punto del caso non è stabilire se un LLM sia finalmente diventato un kernel developer. Non lo è. Il modello ha aiutato Torvalds a esplorare e costruire una soluzione a un problema già studiato da sviluppatori esperti; Torvalds ne ha compreso l’architettura, l’ha testata, pubblicata e sottoposta al giudizio di chi conosce quel sottosistema. La review ha immediatamente trovato un difetto. Paradossalmente è proprio questo il risultato più interessante. L’AI coding non elimina il processo open source, ma può diventare un acceleratore all’interno di esso. Il modello genera e suggerisce, il maintainer deve capire, il benchmark misura e altri sviluppatori cercano ciò che entrambi hanno sbagliato. Se questa catena resta intatta, l’AI non sostituisce il metodo con cui Linux viene costruito: diventa semplicemente un nuovo strumento sottoposto alle stesse regole che hanno permesso al kernel di sopravvivere per 35 anni.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.