📌 In Sintesi
- Reflection ha rilasciato Beam, modello Mixture-of-Experts da 501 miliardi di parametri totali e 23 miliardi attivi per token, con pesi Apache 2.0 in BF16, FP8 e NVFP4.
- AWS offre Beam attraverso SageMaker JumpStart, HyperPod e Trainium3, mentre Google Cloud pubblica configurazioni ottimizzate con llm-d e NVIDIA Dynamo.
- Google dichiara fino a 5 volte più throughput e 8 volte meno latenza rispetto alla propria configurazione baseline sullo stesso hardware: il vantaggio arriva soprattutto dalla gestione del contesto degli agenti multi-turn.
Reflection ha rilasciato Beam e AWS e Google Cloud non hanno aspettato nemmeno un giorno per trasformarlo in un carico di lavoro da produzione. Il nuovo modello open-weight nasce con 501 miliardi di parametri complessivi, ma ne attiva circa 23 miliardi per token grazie a un’architettura sparse Mixture-of-Experts, ed è progettato esplicitamente per coding, reasoning e task agentici di lunga durata. Il dato interessante non è soltanto la disponibilità dei pesi sotto Apache 2.0, ma ciò che accade immediatamente dopo: Amazon e Google stanno competendo per dimostrare che il vero vantaggio sui modelli aperti non consiste più soltanto nell’ospitarli, ma nel servirli meglio quando un agente accumula centinaia di migliaia di token, usa strumenti e continua a richiamare il modello per decine di turni.
Cosa leggere
Beam apre 501 miliardi di parametri ma ne usa 23 miliardi alla volta
La model card ufficiale di Reflection descrive Beam come un modello testuale da 501,3 miliardi di parametri totali e 23,4 miliardi attivi, 52 layer, 256 esperti e una context window fino a un milione di token. Reflection distribuisce checkpoint BF16, FP8 e NVFP4 e consente download, self-hosting, post-training e integrazione con agent harness attraverso licenza Apache 2.0. L’azienda sostiene inoltre che il modello raggiunga risultati comparabili ad alcuni modelli open più grandi impiegando circa tre volte meno token di reasoning, ma i benchmark principali restano quelli pubblicati dal produttore e devono quindi essere letti come misure vendor-run, non come certificazione indipendente. La vera differenza architetturale è comunque concreta: attivare una piccola frazione dei parametri per token rende un modello da oltre 500 miliardi più gestibile rispetto a un dense model equivalente, pur lasciando enorme il problema della memoria necessaria per ospitare i pesi.
Leggi anche: Google, NVIDIA e AWS portano simulazione e valutazione dentro gli agenti AI
AWS porta Beam tra SageMaker, HyperPod e Trainium3
Nel deployment guide ufficiale pubblicato da AWS Beam entra direttamente in Amazon SageMaker JumpStart per chi vuole un endpoint gestito e in SageMaker HyperPod per chi necessita di maggiore controllo sull’infrastruttura Kubernetes, con supporto a SGLang e vLLM. Amazon ha inoltre portato il modello su Trainium3, cercando di offrire un’alternativa alla dipendenza totale dalle GPU NVIDIA per l’inferenza di grandi modelli open. Il valore per AWS non è semplicemente aggiungere un altro modello al catalogo. Un modello Apache 2.0 destinato agli agenti consente alle aziende di mantenere sotto il proprio controllo runtime, pesi, dati e personalizzazione, cioè esattamente il tipo di workload sul quale il cloud provider può vendere compute, orchestrazione e osservabilità senza dover controllare anche il modello.
Google Cloud promette 5 volte più throughput perché conserva il contesto
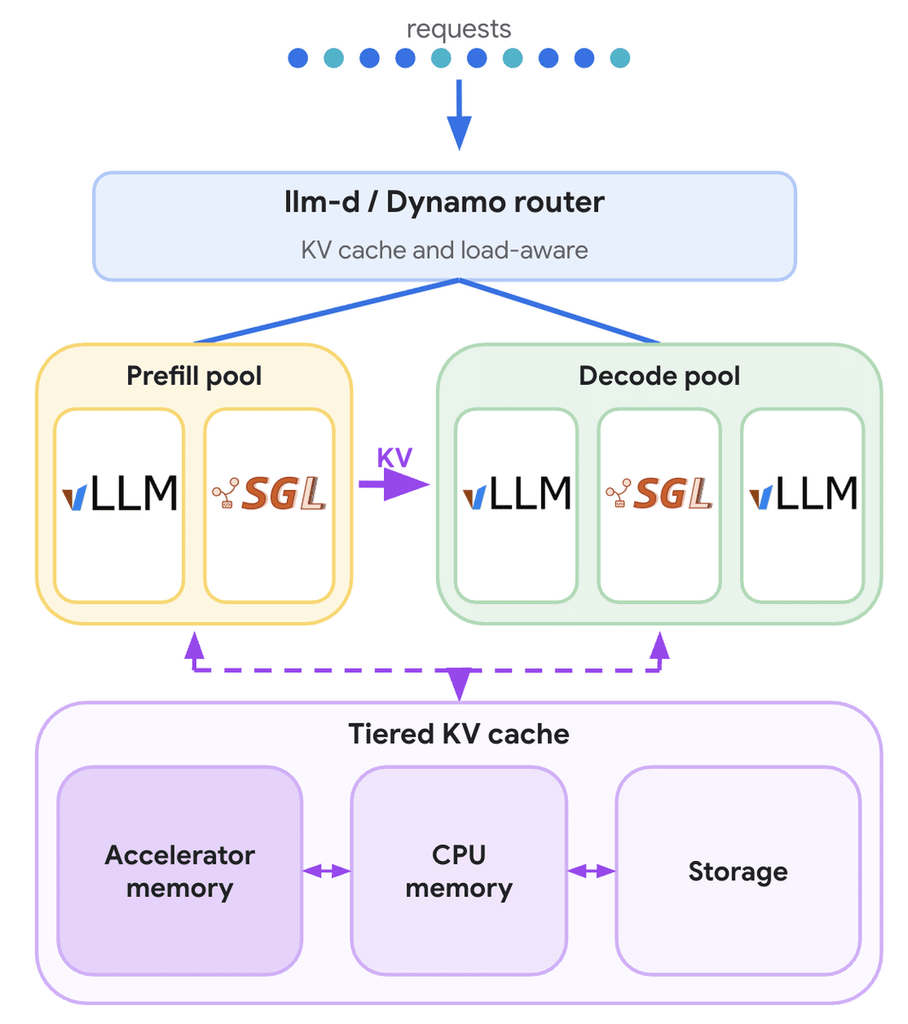
Google Cloud usa invece Beam per mostrare quanto l’infrastruttura possa cambiare le prestazioni dello stesso modello. Nel test ufficiale con AI Hypercomputer Google dichiara fino a 5 volte più throughput e 8 volte meno latenza sulle istanze A4X Max con NVIDIA GB300 NVL72 utilizzando NVIDIA Dynamo, mentre sulle VM G4 con RTX PRO 6000 riporta fino a 2 volte più throughput e ancora fino a 8 volte meno latenza con llm-d. I numeri derivano da benchmark cliente e vanno quindi considerati rispetto alla baseline utilizzata da Google sul medesimo hardware, non come una proprietà intrinseca di Beam.
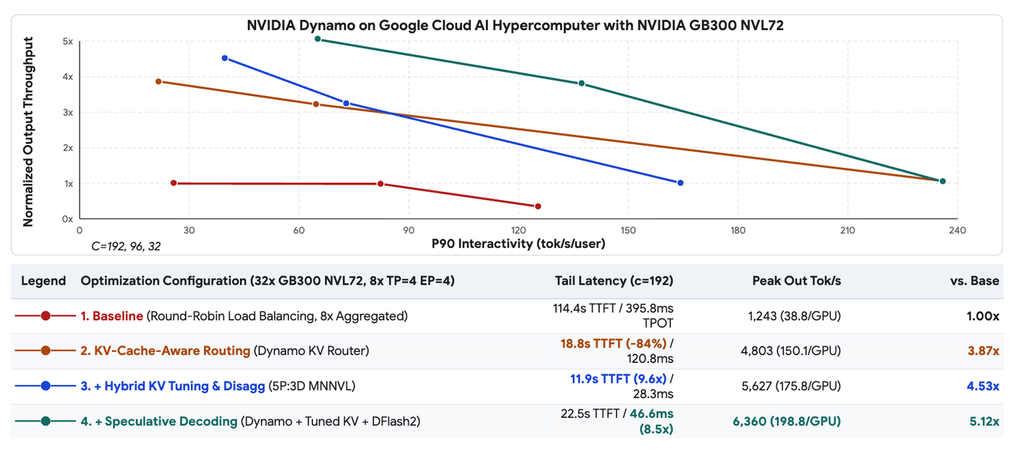
Il meccanismo tecnico è però più interessante del numero: routing consapevole della KV cache, separazione tra prefill e decode, speculative decoding e trasferimento delle cache dalla memoria GPU verso DRAM e SSD evitano di ricomputare continuamente il contesto delle conversazioni agentiche.
Gli agenti trasformano il contesto in un problema di infrastruttura
Un normale chatbot riceve una domanda, genera una risposta e termina gran parte del proprio lavoro. Un agente di coding può invece leggere repository, produrre una patch, eseguire test, ricevere errori dal compilatore, modificare altri file e ricominciare. Ogni passaggio aggiunge codice, diff, log e risultati dei tool alla storia della sessione.
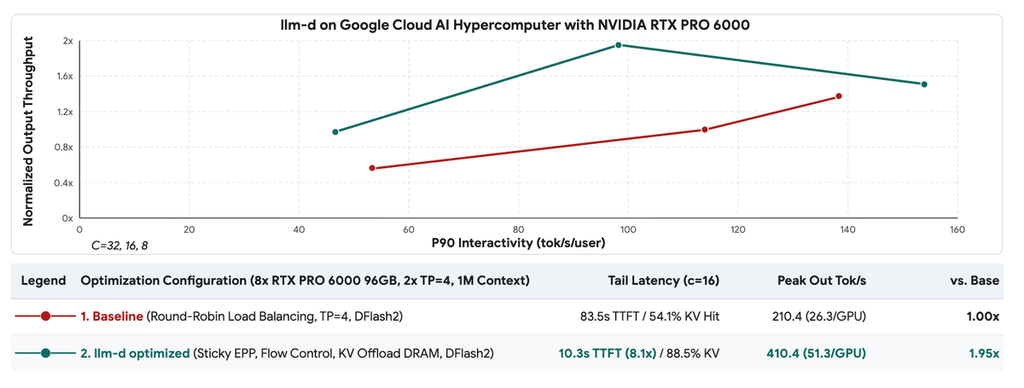
Quando il quindicesimo turno finisce su una GPU diversa da quella che possiede la KV cache dei quattordici precedenti, l’intero contesto può dover essere elaborato nuovamente. Google prova quindi a mantenere ogni nuova richiesta sulla replica che conserva il prefix già calcolato e, quando la memoria HBM si satura, sposta parti della cache verso RAM e storage NVMe invece di eliminarle. È lo stesso passaggio industriale osservato quando Gemini è diventato un agente persistente capace di attraversare Workspace, Microsoft 365 e Slack: più aumenta l’autonomia, più l’infrastruttura deve ricordare ciò che l’agente ha già fatto.
Reflection vuole costruire un sistema operativo aperto per gli agenti
Nel comunicato di disponibilità generale di Beam Reflection parla esplicitamente di “open operating system for agents”. Il modello dovrebbe essere soltanto il kernel, circondato da runtime, container, strumenti di valutazione, pipeline di personalizzazione e agent harness aperti. Beam supporta Reflection Mirror CLI ma anche OpenCode, Hermes e altri ambienti, può usare MCP e lavorare in workflow che comprendono repository, terminale e strumenti esterni. Reflection afferma inoltre di aver costruito il training su oltre cento milioni di rollout RL e di aver utilizzato fino a 170.000 sandbox concorrenti durante alcune fasi dello sviluppo. L’impostazione richiama ciò che NVIDIA sta facendo con gli agenti che manipolano direttamente simulazioni Omniverse: il modello diventa sempre meno un generatore di testo e sempre più il motore di un ciclo osservazione-azione-verifica.
Continua con:
Google Cloud dà memoria agli agenti AI e riduce il consumo di token
NVIDIA crea Open Secure AI Alliance per proteggere gli agenti
La nuova guerra del cloud non è ospitare il modello ma far lavorare l’agente
Beam mostra che l’apertura dei pesi sposta il valore economico verso lo strato immediatamente successivo. Se un’azienda può scaricare il modello, modificarlo e scegliere dove eseguirlo, il lock-in non può più dipendere soltanto dall’accesso all’API proprietaria. AWS prova quindi a vincere con SageMaker, HyperPod e Trainium; Google con AI Hypercomputer, GKE, llm-d e Dynamo; NVIDIA resta presente come infrastruttura hardware e software in quasi tutte le configurazioni. Per gli sviluppatori il risultato è una maggiore libertà, ma non necessariamente una minore dipendenza infrastrutturale: un modello da 501 miliardi di parametri può essere aperto e contemporaneamente richiedere data center, networking e sistemi di caching estremamente sofisticati per funzionare economicamente su larga scala. La vera competizione dell’AI agentica si sta quindi spostando dal semplice possesso del modello alla capacità di mantenere migliaia di agenti attivi, con contesti lunghi e strumenti reali, senza bruciare GPU per ricalcolare continuamente ciò che hanno già visto.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.