📌 In Sintesi
- OpenAI presenta due benchmark dedicati ai linguaggi con poche risorse di addestramento: MultiLangBench per sviluppare software e una valutazione per migrare applicazioni COBOL.
- GPT-6 Astra raggiunge l’87,4% di test superati nella costruzione di motori compatibili con SQLite in 20 linguaggi, rispetto al 26,8% di GPT-5.6 Sol.
- GPT-6.1 Sol arriva al 97,9% nella migrazione COBOL con ragionamento elevato, ma la compatibilità nei benchmark non garantisce l’affidabilità dei sistemi bancari in produzione.
OpenAI porta i modelli GPT-6 nel terreno dei linguaggi di programmazione meno rappresentati nei dati di addestramento, puntando alla modernizzazione del software utilizzato da banche, imprese e infrastrutture critiche. La ricerca pubblicata il 19 ottobre 2026 presenta due valutazioni dedicate a COBOL, Fortran, Visual Basic e altri linguaggi, mostrando miglioramenti significativi nella generazione di codice e nella conversione delle applicazioni esistenti. Il risultato più importante riguarda GPT-6.1 Sol, capace di raggiungere il 97,9% di accuratezza in una valutazione sperimentale sulla migrazione COBOL, mentre GPT-6 Astra supera l’87% nei test di sviluppo su venti linguaggi. I numeri sono rilevanti, ma non certificano ancora l’affidabilità di una migrazione automatica in produzione.
Cosa leggere
OpenAI affronta il problema del software legacy nelle infrastrutture critiche
La ricerca ufficiale di OpenAI sui linguaggi di programmazione con poche risorse parte da una difficoltà conosciuta dagli sviluppatori: i modelli AI dispongono di grandi quantità di codice Python e JavaScript, ma incontrano maggiori ostacoli quando devono comprendere applicazioni scritte in COBOL, Fortran o Visual Basic. Questi linguaggi rimangono presenti in sistemi bancari, procedure contabili, applicazioni industriali e software scientifico, spesso sviluppati molti anni prima dell’introduzione delle moderne pratiche DevOps. OpenAI richiama stime secondo cui COBOL sarebbe ancora alla base di una parte significativa dei servizi bancari e delle transazioni attraverso gli sportelli automatici, mentre Fortran mantiene un ruolo nelle previsioni meteorologiche e nel calcolo scientifico.
La questione non riguarda soltanto l’età del codice: documentazione incompleta, sviluppatori non più disponibili e regole aziendali conservate esclusivamente nei programmi rendono difficile modificare le applicazioni senza alterarne il comportamento. L’obiettivo dichiarato è utilizzare l’AI per comprendere, correggere e convertire questi sistemi, estendendo ai linguaggi storici le capacità già sviluppate nei moderni assistenti AI per la programmazione e negli agenti Codex. La sfida non consiste nel produrre codice sintatticamente valido, ma nel conservarne le regole operative, soprattutto quando un errore può modificare risultati finanziari o processi aziendali.
Leggi anche: OpenAI rompe gli indugi: arriva GPT-5.6 Sol e accelera nel coding
MultiLangBench misura la capacità di ricostruire SQLite in venti linguaggi
Il primo esperimento introduce MultiLangBench, un benchmark nel quale il modello deve sviluppare da zero un motore database compatibile con SQLite utilizzando uno dei venti linguaggi previsti. Il software generato riceve un database iniziale e una query SQL, esegue l’operazione e produce un file successivamente controllato attraverso SQLite originale. Il repository pubblico MultiLangBench su GitHub descrive l’utilizzo di SQLite 3.40.1 e una suite derivata da circa 24.000 test convertiti dal progetto originale; per contenere i costi delle valutazioni, la configurazione raccomandata utilizza un sottoinsieme di 272 test.
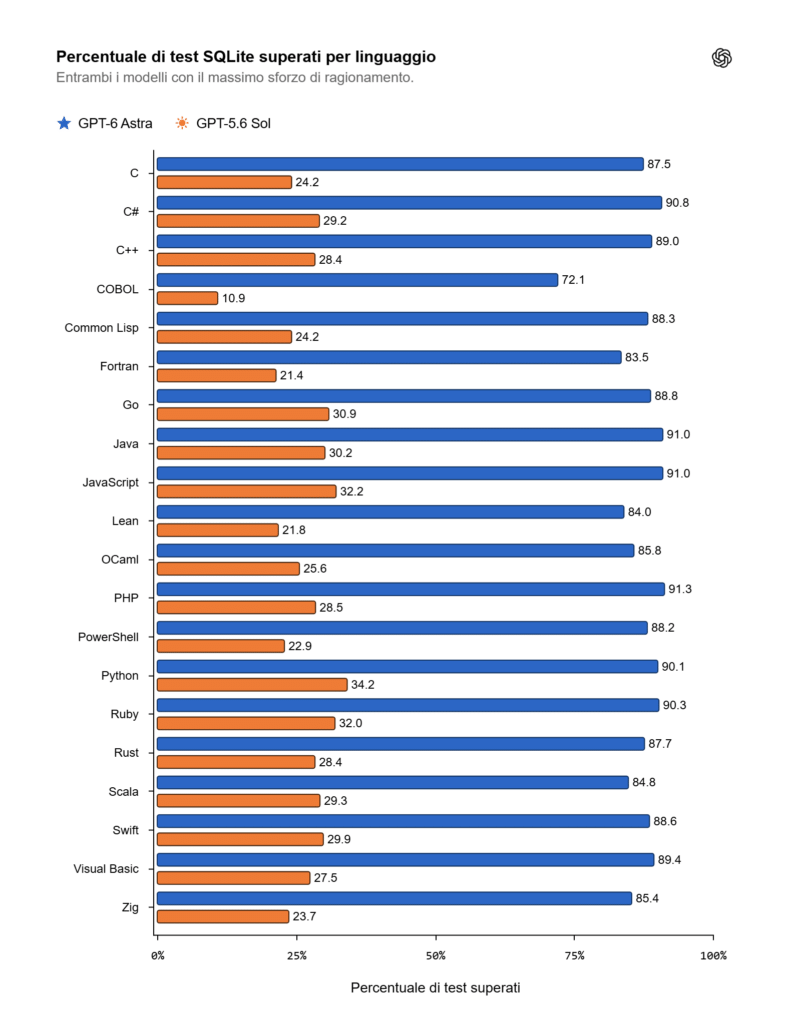
La prova misura quindi l’esecuzione corretta delle funzionalità richieste, non una generica preferenza espressa da un giudice AI. Secondo i risultati pubblicati da OpenAI, GPT-6 Astra raggiunge una media dell’87,4% di test superati, contro il 26,8% di GPT-5.6 Sol, con il massimo sforzo di ragionamento. I miglioramenti interessano COBOL, che passa dal 10,9% al 72,1%, Fortran dal 21,4% all’83,5%, OCaml dal 25,6% all’85,8% e Visual Basic dal 27,5% all’89,4%. Astra supera l’83% in diciannove linguaggi su venti, ma COBOL rimane il caso più difficile. Il confronto si inserisce nell’evoluzione degli agenti AI applicati ai database e alle infrastrutture cloud, con una differenza sostanziale: qui l’intelligenza artificiale deve implementare il motore software, non limitarsi a utilizzarne le API.
GPT-6.1 Sol migra COBOL in C++, Java, Kotlin, Python e Rust
La seconda valutazione riguarda direttamente la conversione delle applicazioni esistenti. OpenAI chiede ai modelli di riscrivere programmi COBOL in C++, Java, Kotlin, Python o Rust, mantenendo invariati gli output osservabili. La verifica utilizza test nascosti che richiedono una corrispondenza byte per byte: una migrazione viene considerata riuscita soltanto quando tutti i controlli previsti sono superati. Con uno sforzo di ragionamento basso, GPT-6.1 Sol raggiunge l’86,6% di accuratezza, rispetto al 5,4% di GPT-5.6 Sol nella medesima configurazione, con un costo API inferiore del 39%.
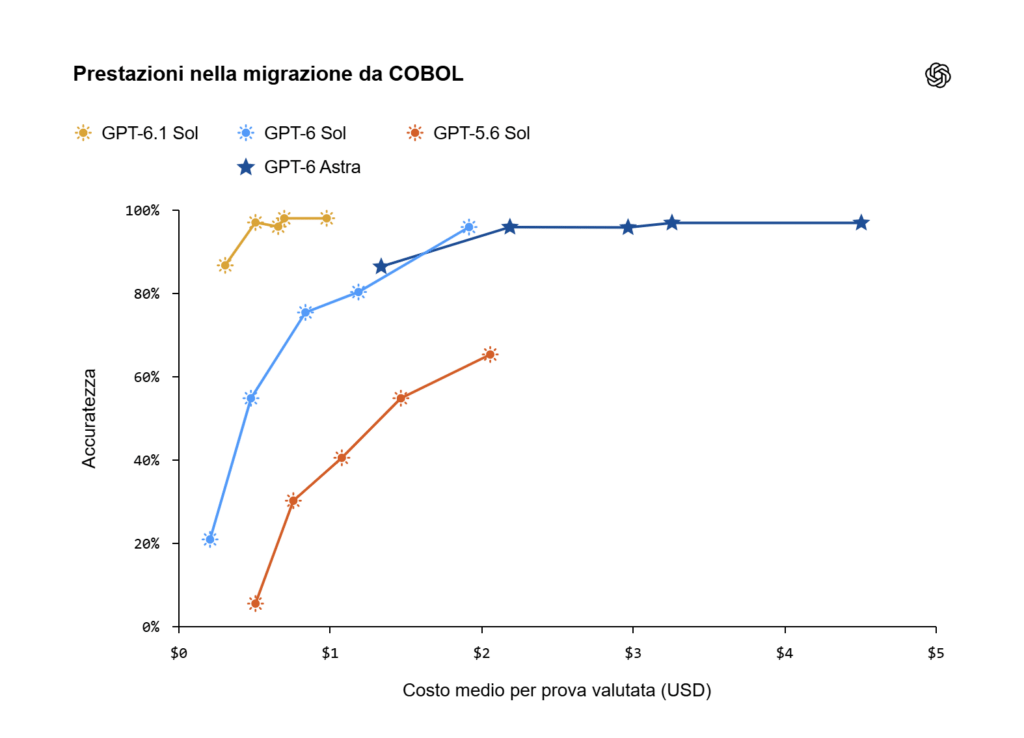
Aumentando lo sforzo di ragionamento, il risultato arriva al 97,9%. È una differenza importante rispetto alla semplice traduzione del codice, perché il programma deve rispettare anche comportamenti apparentemente secondari, come l’arrotondamento dei valori numerici, la gestione dei record mancanti e le convenzioni proprie del linguaggio originale. OpenAI cita il caso dell’aritmetica a virgola fissa COBOL: un programma che tronca le cifre decimali non può essere sostituito con uno che le arrotonda, anche quando entrambi producono risultati formalmente validi. Un cambiamento minimo nelle regole di calcolo può diventare un errore finanziario sistematico. La prova dimostra progressi concreti rispetto alle precedenti generazioni di modelli, ma resta una valutazione costruita dal produttore, non una certificazione indipendente della sicurezza dei programmi migrati.
GPT-6 Luna riduce i costi mentre i benchmark mostrano ancora limiti
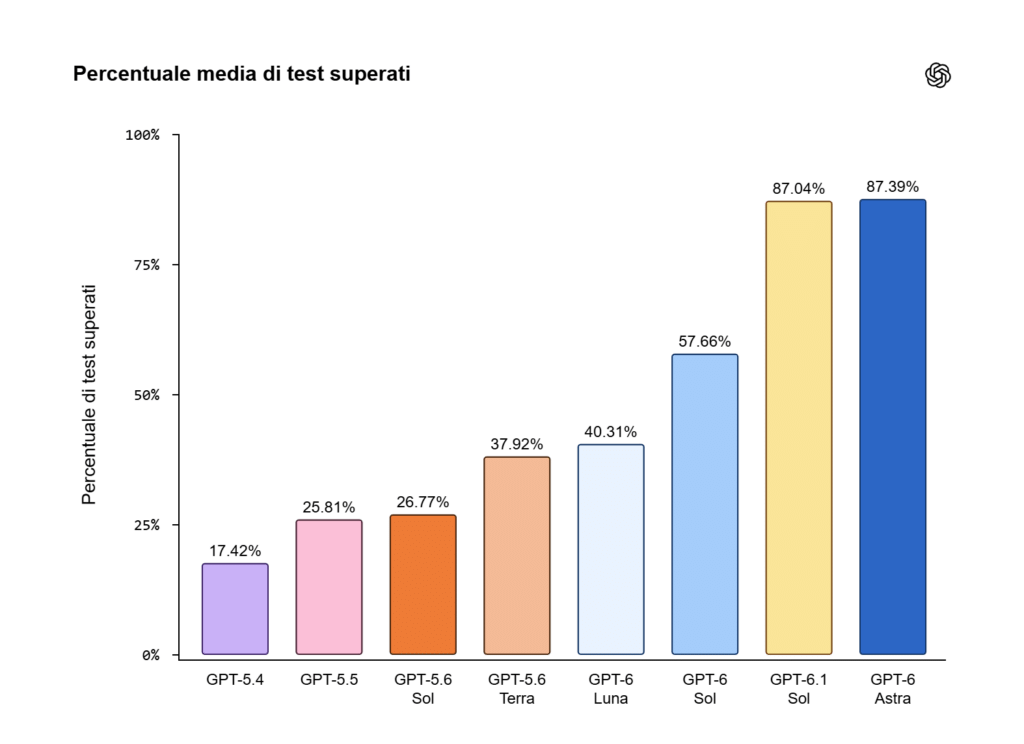
OpenAI presenta anche i risultati di GPT-6 Luna, modello orientato a un costo inferiore, che su MultiLangBench raggiunge una media del 40,3% di test superati. Il risultato supera quello di GPT-5.6 Sol, pur rimanendo distante dalle prestazioni di Astra, e viene ottenuto con un costo API stimato di 0,77 dollari per campione, contro 3,48 dollari del modello precedente: una riduzione di circa il 78%. Questa distinzione evidenzia il compromesso tra capacità, intensità del ragionamento e costo computazionale, particolarmente rilevante per progetti aziendali che richiedono l’analisi di grandi codebase. La disponibilità pubblica di MultiLangBench permette agli sviluppatori di esaminare la metodologia, riprodurre le prove e identificare le differenze tra linguaggi, mentre la documentazione presentata non offre lo stesso livello di riproducibilità per la valutazione delle migrazioni COBOL. Inoltre, superare una suite di test non equivale a certificare l’intera applicazione, soprattutto quando entrano in gioco dipendenze esterne, prestazioni, sicurezza e integrazione con altri sistemi. Il limite richiama le problematiche già emerse nella gestione del codice prodotto dagli agenti AI e dei rischi di esecuzione non controllata, dove la qualità del risultato dipende anche dai controlli applicati durante sviluppo e verifica.
Continua con:
OpenAI Codex Security scopre 10.561 vulnerabilità nei repository
AWS porta gli agenti AI nel ciclo software tra AgentCore, Quick e Codex
Per banche e pubbliche amministrazioni l’AI non sostituisce la validazione
L’applicazione più interessante della ricerca riguarda la modernizzazione dei sistemi legacy, ma il passaggio dal benchmark alla produzione richiede verifiche molto più ampie. Una banca che converte procedure COBOL deve garantire la corrispondenza dei risultati contabili, la gestione corretta delle transazioni, la conservazione dei dati e l’interoperabilità con applicazioni e infrastrutture esistenti. Lo stesso principio vale per le pubbliche amministrazioni che utilizzano procedure sviluppate su piattaforme storiche, nelle quali le regole operative possono essere incorporate direttamente nel codice. Gli strumenti AI possono accelerare la comprensione del software, la generazione dei test e la conversione iniziale, ma rimangono necessari revisione umana, confronti funzionali, controlli di sicurezza e periodi di esecuzione parallela dei sistemi. Il 97,9% dichiarato da OpenAI riguarda un insieme di prove sperimentali, non il tasso di successo garantito nella migrazione di applicazioni bancarie reali. Il risultato dimostra che il modello riesce a preservare molto meglio determinati comportamenti verificabili, senza eliminare la necessità di comprendere quelli non coperti dai test. La prospettiva industriale è comunque significativa: se queste capacità saranno confermate su codebase reali, l’intelligenza artificiale potrebbe ridurre il costo della manutenzione e facilitare la sostituzione graduale dei sistemi più difficili da aggiornare. La questione decisiva non sarà quindi quante righe di COBOL un modello riesca a tradurre, ma quante regole aziendali sia capace di conservare senza introdurre errori invisibili nei processi critici.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.