🛡️ Executive Summary
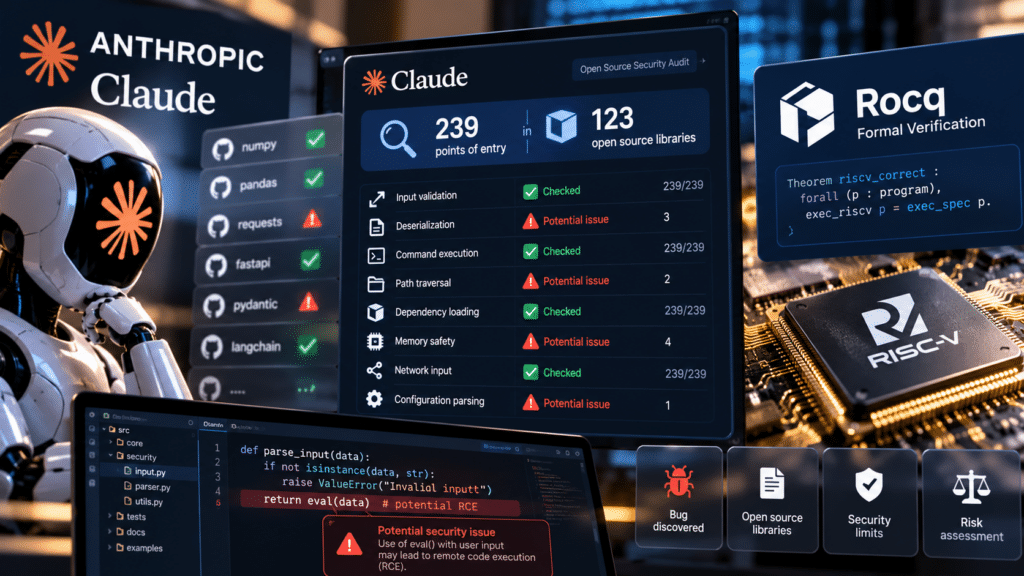
- Anthropic e Theorem hanno utilizzato Claude per produrre prove formali su 239 punti d’ingresso appartenenti a 123 librerie open source, generando circa 180 milioni di righe di codice Rocq.
- La verifica ha individuato centinaia di bug, compresi errori di memoria difficilmente raggiungibili con il fuzzing tradizionale, e ha consentito di correggerli prima di completare le dimostrazioni.
- Le garanzie riguardano specifici eseguibili RISC-V, con un solo thread e input inferiori a 64 MB: non dimostrano che le versioni comunemente utilizzate su x86 e ARM siano prive di vulnerabilità.
Claude ha verificato formalmente proprietà di sicurezza in 123 librerie open source, dimostrando che 239 punti d’ingresso non producono crash nelle condizioni definite dai ricercatori. Il risultato, presentato il 22 ottobre 2026 da Anthropic insieme a Theorem, rappresenta un avanzamento significativo nell’impiego dell’intelligenza artificiale per la sicurezza del software: anziché limitarsi a cercare vulnerabilità attraverso migliaia di test, il modello costruisce dimostrazioni matematiche controllate da un verificatore indipendente. L’esperimento ha prodotto circa 180 milioni di righe di prove formali e permesso di scoprire centinaia di bug. Ma il dato più importante riguarda il confine della verifica: il software esaminato non può essere considerato automaticamente sicuro in ogni ambiente operativo.
Cosa leggere
Claude e Anthropic trasformano i test OSS-Fuzz in prove matematiche
La ricerca, pubblicata dal Frontier Red Team di Anthropic, utilizza i test già disponibili nel programma OSS-Fuzz di Google, un’infrastruttura che sottopone continuamente numerosi progetti open source a input generati automaticamente per individuare errori e vulnerabilità. Il fuzzing tradizionale esegue il codice ripetutamente, modificando i dati in ingresso e cercando condizioni capaci di provocare crash. Anche dopo miliardi di esecuzioni, tuttavia, non garantisce che siano stati esplorati tutti i percorsi possibili. Anthropic ha adottato un approccio differente: compilare le librerie e i relativi test in eseguibili RISC-V, trasformare l’obiettivo di assenza di crash in una specifica matematica e affidare a Claude la costruzione della dimostrazione.
Le prove vengono poi controllate da Rocq, il sistema di verifica formale precedentemente conosciuto come Coq, che accetta soltanto dimostrazioni conformi alle regole stabilite. Nel rapporto tecnico originale di Anthropic, i ricercatori spiegano che l’esperimento copre 239 punti d’ingresso distribuiti in 123 librerie, con input inferiori a 64 MB. La differenza rispetto al precedente OSS Scanner, che automatizza la scoperta di vulnerabilità e l’invio dei risultati ai maintainer, è sostanziale: non si tratta soltanto di produrre segnalazioni, ma di dimostrare che una particolare classe di errori non può più verificarsi nel sistema modellato.
Leggi anche: Anthropic apre Claude ai cyber team dopo 129.000 vulnerabilità verificate
Centinaia di bug scoperti: libexpat, decoder e memoria fuori dai limiti
Il tentativo di completare le prove ha consentito di individuare centinaia di difetti, alcuni difficilmente raggiungibili attraverso le normali campagne di fuzzing. Anthropic descrive un errore di underflow in un decompressore che può provocare una scrittura fuori dai limiti della memoria, ma soltanto quando l’input raggiunge circa 20 MB e presenta una particolare struttura. Un altro problema riguarda un decoder di immagini: la lettura fuori dai limiti richiede un input di circa 64 MB e oltre 2 GB di memoria. Sono stati identificati anche errori dipendenti dalla sequenza di operazioni su due handle dello stesso file e riscoperta la vulnerabilità CVE-2026-56132 in libexpat, associata a input profondamente annidati. Claude ha inoltre individuato problemi logici che non provocano crash, fra cui una restrizione sul caricamento dei file non applicata in tutte le circostanze. Il passaggio tecnico decisivo è che il modello poteva correggere il codice sperimentale, rigenerare la specifica e riprendere la dimostrazione. Questo non significa che tutte le correzioni siano già state integrate nelle versioni pubbliche delle librerie. Anthropic distingue il lavoro di verifica dalla distribuzione delle patch ai progetti interessati. I risultati rafforzano il percorso già osservato nell’impiego dei modelli AI per la scoperta automatica delle vulnerabilità, ma aggiungono uno strumento per stabilire quando la ricerca di determinati errori può considerarsi conclusa.
Perché 180 milioni di righe Rocq non certificano la sicurezza delle librerie
Le dimensioni dell’esperimento sono notevoli: circa 180 milioni di righe di codice Rocq, con una prova tipica di 600.000 righe per eseguibili che contengono mediamente, considerando la mediana riportata dai ricercatori, 18.000 istruzioni RISC-V. La verifica matematica non dipende dalla fiducia nelle risposte generate da Claude, perché è Rocq a controllare la validità della dimostrazione. Rimane però necessario fidarsi della correttezza delle specifiche, dei modelli delle istruzioni RISC-V e delle semantiche dei processi Linux. Soprattutto, la prova riguarda binari statici, a thread singolo, collegati a musl libc ed eseguiti nell’ambiente modellato. La maggior parte delle distribuzioni Linux e dei sistemi aziendali utilizza invece architetture x86 o ARM, librerie collegate dinamicamente e condizioni di esecuzione differenti. Anche AddressSanitizer, impiegato per individuare errori di memoria, non intercetta tutte le possibili vulnerabilità. Restano esclusi i punti d’ingresso non esaminati e gli errori provocati da applicazioni che utilizzano impropriamente le librerie. È quindi tecnicamente scorretto sostenere che Anthropic abbia eliminato ogni bug da 123 progetti: ha dimostrato proprietà circoscritte su eseguibili specifici, dopo aver corretto i difetti individuati durante l’esperimento. Questo limite rende ancora centrale il problema dell’indipendenza delle verifiche, già emerso nel confronto sugli audit di sicurezza e sulla pubblicazione dei risultati di OpenAI e Anthropic.
La verifica formale con AI costa milioni di token, ma le prove si riutilizzano
La principale barriera alla diffusione commerciale è il costo computazionale. Anthropic riconosce che una singola dimostrazione complessa può richiedere centinaia di milioni di token, rendendo ancora impegnativo applicare il metodo indiscriminatamente a ogni componente software. I ricercatori hanno confrontato diversi modelli su 36 attività di verifica, osservando che Claude Opus 5.5 completa metà dei compiti con circa il 40% di token in meno rispetto a Opus 5. Un secondo esperimento ha mostrato che consentire agli agenti di condividere e riutilizzare dimostrazioni già prodotte riduce ulteriormente il consumo di token del 17%. La collaborazione con Theorem è centrale proprio perché permette di costruire librerie di prove riutilizzabili, riducendo la necessità di verificare ripetutamente le stesse componenti. Anthropic ha reso disponibile una parte del materiale nel repository delle prove OSS Verify, insieme ai modelli formali necessari per controllarle, mentre ulteriori materiali restano esclusi dalla pubblicazione per evitare di esporre vulnerabilità non ancora corrette. La disponibilità parziale consente controlli indipendenti sul materiale pubblicato, ma non equivale a una riproduzione esterna dell’intero esperimento.
Continua con:
Claude compromette tre aziende reali durante i test cyber di Anthropic
GLM-5.3 raggiunge Claude Mythos negli exploit e riapre il rischio open-weight
DevSecOps e software critico: cosa cambia davvero per gli sviluppatori
L’applicazione industriale più interessante riguarda le pipeline di sviluppo sicuro, nelle quali analisi statica, fuzzing, revisione del codice e verifica delle dipendenze potrebbero essere affiancati da prove formali generate automaticamente. Per un manutentore di software critico, la possibilità di dimostrare l’assenza di determinati errori sarebbe particolarmente utile nei componenti di parsing, compressione e decodifica, dove input non attendibili possono raggiungere funzioni esposte a Internet. La tecnologia non permette ancora di sostituire completamente gli strumenti tradizionali, ma indica una direzione concreta: spostare parte della sicurezza dalla ricerca probabilistica dei bug alla dimostrazione verificabile delle proprietà del programma. La collaborazione con Theorem comprende anche sperimentazioni su zlib, sulla corrispondenza fra interpreti Python e su componenti software differenti, mostrando che il metodo può essere esteso oltre la semplice assenza di crash. Prima di impiegarlo come garanzia nella produzione, tuttavia, rimane necessario verificare l’equivalenza fra il binario analizzato e quello effettivamente distribuito, controllare le specifiche e definire quali comportamenti debbano essere esclusi. Il risultato di Anthropic non è la fine delle vulnerabilità open source, ma la dimostrazione che l’intelligenza artificiale può contribuire a produrre prove di sicurezza controllabili da strumenti matematici indipendenti dal modello.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.