📌 In Sintesi
- AWS lancia TorchNeuron in beta pubblica: i modelli PyTorch possono funzionare nativamente sui processori Trainium2 e Trainium3, riducendo le modifiche al codice.
- Un video diffuso da HKEPC mostra RTX 5090 smontate e ricostruite per i server AI: GPU e memorie GDDR7 vengono trasferite su nuove schede con raffreddamento blower.
- La competizione AI si sposta sulla disponibilità del calcolo: Amazon riduce le barriere software, mentre le riconversioni delle GPU mostrano la pressione sull’hardware Nvidia, senza dimostrare le dimensioni del mercato parallelo.
Amazon rende più semplice sviluppare intelligenza artificiale sui propri chip Trainium, mentre un video rilanciato da Hong Kong mostra schede Nvidia RTX 5090 smontate e ricostruite per i server AI. Il 20 ottobre 2026 AWS ha aperto la beta pubblica di TorchNeuron, integrazione che permette di eseguire codice PyTorch sui processori Trainium2 e Trainium3 senza riscrivere necessariamente i modelli. Tre giorni dopo HKEPC ha diffuso immagini di laboratori che recuperano GPU e memorie GDDR7 dalle schede gaming. Le due operazioni non sono collegate, ma mostrano le difficoltà dell’industria AI: ridurre la dipendenza dal software ottimizzato per Nvidia e procurarsi comunque hardware capace di sostenere l’inferenza.
Cosa leggere
AWS TorchNeuron porta PyTorch sui chip Trainium2 e Trainium3
TorchNeuron è un backend nativo e open source per PyTorch, il framework usato per sviluppare e addestrare gran parte dei modelli di intelligenza artificiale. Nell’annuncio tecnico pubblicato da PyTorch, AWS spiega che il codice può passare su Trainium usando l’istruzione .to('neuron'), mantenendo le API standard per tensori, modelli e addestramento distribuito. La beta pubblica, rilasciata il 20 ottobre, funziona su istanze EC2 Trn2 e Trn3 e supporta sia l’esecuzione immediata, utile alla ricerca e al debug, sia torch.compile, pensato per ottimizzare i carichi più stabili.
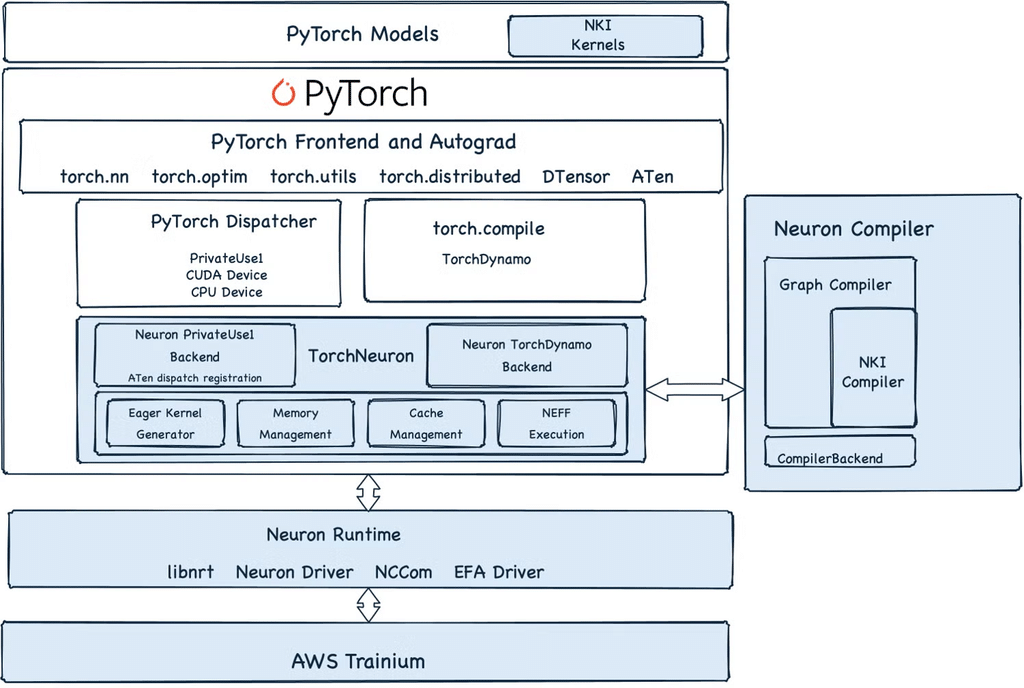
Sono disponibili anche la Neuron Kernel Interface per operatori personalizzati e strumenti di profiling collegati alle singole righe del codice. Compatibilità non significa prestazioni identiche su qualsiasi modello: operatori particolari, versioni software e ottimizzazioni richiedono ancora verifiche, mentre parte del supporto alle precisioni numeriche avanzate è in beta privata. La novità rafforza la strategia industriale descritta nel progetto Amazon Trainium contro la dipendenza da Nvidia: rendere accessibile il silicio proprietario senza chiedere agli sviluppatori di abbandonare il proprio ambiente di lavoro.
Leggi anche: Oltre i modelli autoregressivi: DiffusionGemma e l’approccio AWS a Trainium
Cina, le RTX 5090 vengono smontate per costruire acceleratori AI
In Cina il problema opposto riguarda la disponibilità delle GPU fisiche. Il 23 ottobre il portale di Hong Kong HKEPC ha rilanciato un filmato di lavorazioni su GeForce RTX 5090 che mostra banchi occupati da schede nuove, comprese versioni dei partner Nvidia e unità Founders Edition. Nelle sequenze diffuse gli operatori rimuovono dissipatori, chip grafici GB202 e moduli di memoria, trasferendo i componenti su circuiti stampati differenti con raffreddamento blower a doppio slot, più adatto a installazioni dense nei rack.
La RTX 5090 nasce per il mercato consumer, ma i suoi 32 GB di GDDR7 e la potenza di calcolo la rendono interessante anche per alcuni carichi AI. Il filmato non certifica però l’identità dell’officina, il numero complessivo di schede riconvertite o la provenienza degli acquisti. Le affermazioni secondo cui verrebbero trasformate migliaia di RTX 5090 ogni giorno non sono dimostrate dalle immagini. È documentata la pratica di riconversione mostrata, non la scala nazionale attribuita all’operazione.
Amazon sfida CUDA mentre il mercato parallelo riutilizza Nvidia
La divergenza fra i due casi è industriale prima ancora che tecnologica. Amazon cerca di rendere i processori Trainium un’alternativa praticabile all’ecosistema CUDA, riducendo i costi di adattamento del software e offrendo un’infrastruttura gestita direttamente dentro AWS. Chi riconverte una RTX 5090 cerca invece di sfruttare hardware Nvidia già disponibile, cambiandone la forma fisica senza trasformarlo in un acceleratore progettato e certificato dal produttore per uso continuativo nei data center. Non sono soluzioni equivalenti: TorchNeuron incide sulla portabilità del codice, il trapianto dei componenti sull’utilizzabilità di GPU consumer in chassis server. Il consumo della 5090 può arrivare a 575 W secondo le specifiche Nvidia e il cambio di dissipatore richiede quindi particolare attenzione a flussi d’aria, alimentazione, stabilità e affidabilità. Mancano verifiche indipendenti sulle prestazioni e sulla durata dei moduli mostrati nel filmato. La riconversione appare coerente con la pressione esercitata dall’AI sulle forniture di GPU e componenti per il gaming, ma il video non dimostra da solo che tali laboratori siano la causa principale della scarsità commerciale.
Continua con:
Amazon e Synopsys, accordo da oltre un miliardo per progettare chip con l’AI
Nvidia DLSS 5 alza i consumi della RTX 5090 e riapre il caso del connettore 16 pin
Il prezzo della potenza AI dipende sempre più dalla filiera
Il confronto non dimostra che Nvidia stia perdendo il controllo del mercato AI, né che AWS abbia eliminato i vincoli economici dei propri acceleratori. Trainium richiede istanze compatibili, integrazione del runtime e misurazioni delle prestazioni per ciascun modello; l’adozione di PyTorch riduce l’attrito, ma non rende automaticamente conveniente ogni migrazione. Sul fronte cinese restano opachi provenienza e destinazione dei componenti. La RTX 5090 completa è soggetta a restrizioni di esportazione verso la Cina, dove Nvidia ha commercializzato varianti modificate; dalle immagini non si può ricostruire se e come siano state violate le regole commerciali. Per imprese e sviluppatori italiani la scelta continua a dipendere da costo totale del calcolo, disponibilità regionale, supporto software e continuità della filiera, non soltanto dai benchmark di picco. Il tema è già emerso nella pressione dell’AI su prezzi e memoria dei dispositivi. Il punto comune è che il calcolo AI non dipende soltanto dalla potenza del chip: conta la possibilità concreta di procurarselo, programmarlo e farlo funzionare con costi sostenibili.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.