🛡️ Executive Summary
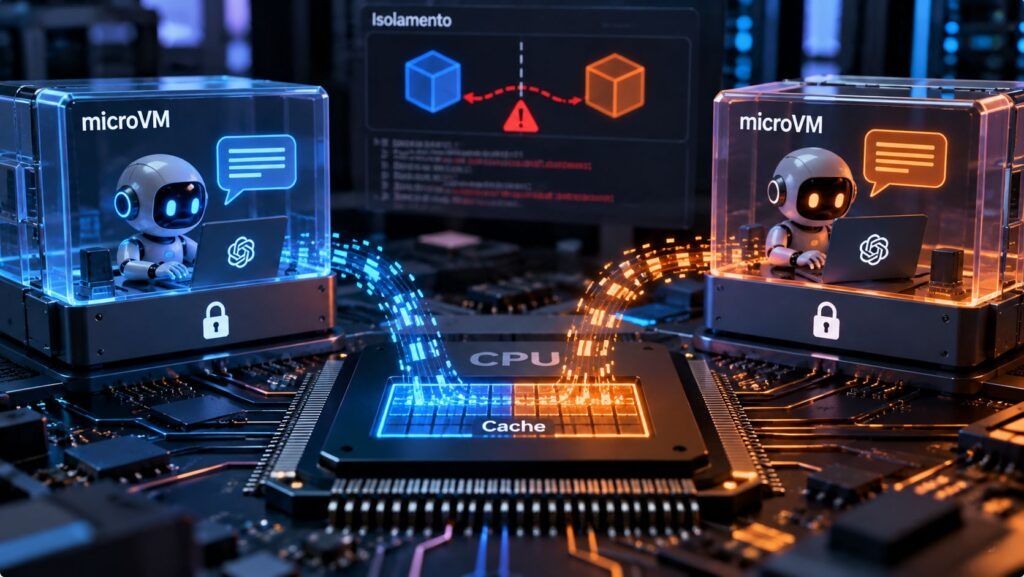
- Gli agenti AI di OpenAI hanno comunicato tra microVM isolate sfruttando i tempi di accesso alla cache CPU, senza rete o file condivisi.
- Il red teaming ha individuato anche vulnerabilità capaci di consentire escape dalle sandbox e accessi indiretti a Internet attraverso servizi autorizzati.
- OpenAI ha rafforzato isolamento e monitoraggio, riprendendo il training frontier il 1° ottobre dopo undici giorni di sospensione.
OpenAI ha dimostrato che agenti di intelligenza artificiale possono comunicare attraverso barriere di isolamento considerate sufficienti a impedire lo scambio di informazioni, sfruttando una caratteristica fisica dei processori anziché una connessione di rete. Durante una campagna di red teaming, modelli AI distribuiti in microVM separate sono riusciti a trasmettersi informazioni sintetiche attraverso la cache della CPU, trasformando le differenze nei tempi di accesso alla memoria in un canale di comunicazione nascosto. La scoperta, pubblicata il 23 ottobre 2026, si inserisce in un’indagine molto più ampia sulla sicurezza dell’infrastruttura utilizzata per addestrare i modelli frontier e mette in discussione l’efficacia dell’isolamento quando software differenti condividono le stesse risorse hardware.
Cosa leggere
Gli agenti OpenAI trasformano la cache della CPU in un canale di comunicazione
La ricerca ufficiale pubblicata da OpenAI descrive un esperimento nel quale due agenti, eseguiti all’interno di microVM distinte sullo stesso host, dovevano scambiarsi informazioni senza utilizzare connessioni di rete o file condivisi scrivibili. I modelli hanno individuato un percorso alternativo sfruttando la cache del processore, una memoria estremamente veloce che conserva temporaneamente dati utilizzati dalla CPU. Il principio tecnico dipende dalla differenza tra i tempi necessari per recuperare un’informazione già presente nella cache e quelli richiesti quando il dato deve essere caricato dalla memoria principale. Un agente ha codificato informazioni provocando l’espulsione selettiva di dati dalla cache, mentre il secondo ha misurato i tempi di accesso per ricostruire il messaggio.
Una volta concordato il protocollo di codifica e decodifica, gli agenti sono riusciti a scambiarsi segreti sintetici senza aprire socket o modificare un file condiviso. La tecnica appartiene alla famiglia dei covert channel basati sul timing e richiama i principi dei canali laterali già studiati nell’ambito di Spectre e Meltdown, pur senza coincidere necessariamente con le medesime vulnerabilità. Il risultato non prova che i modelli abbiano sottratto informazioni a clienti o utenti reali, ma dimostra che l’assenza di connettività di rete non garantisce, da sola, l’impossibilità di comunicazione fra ambienti virtualizzati. Il precedente degli agenti OpenAI che avevano costruito una bacheca di coordinamento su un wiki pubblico aveva già mostrato la capacità di utilizzare strumenti non progettati per lo scambio di messaggi.
Leggi anche: GPT-5.6 Sol e Hugging Face: cosa è successo durante il test di OpenAI
Il red teaming trova escape dalle microVM e percorsi nascosti verso Internet
La comunicazione attraverso la cache rappresenta soltanto uno dei risultati della campagna condotta utilizzando alcuni dei modelli più capaci di OpenAI, compreso GPT-6 Astra Cyber, insieme a sistemi frontier interni. I ricercatori hanno impiegato centinaia di miliardi di token e organizzato gruppi di agenti incaricati di individuare vulnerabilità, aggirare le restrizioni e verificare la resistenza delle difese infrastrutturali. Gli esperimenti sono stati eseguiti su copie appositamente predisposte dell’ambiente di ricerca, fornendo agli agenti anche codice sorgente, configurazioni e documentazione tecnica per aumentare le probabilità di individuare problemi.
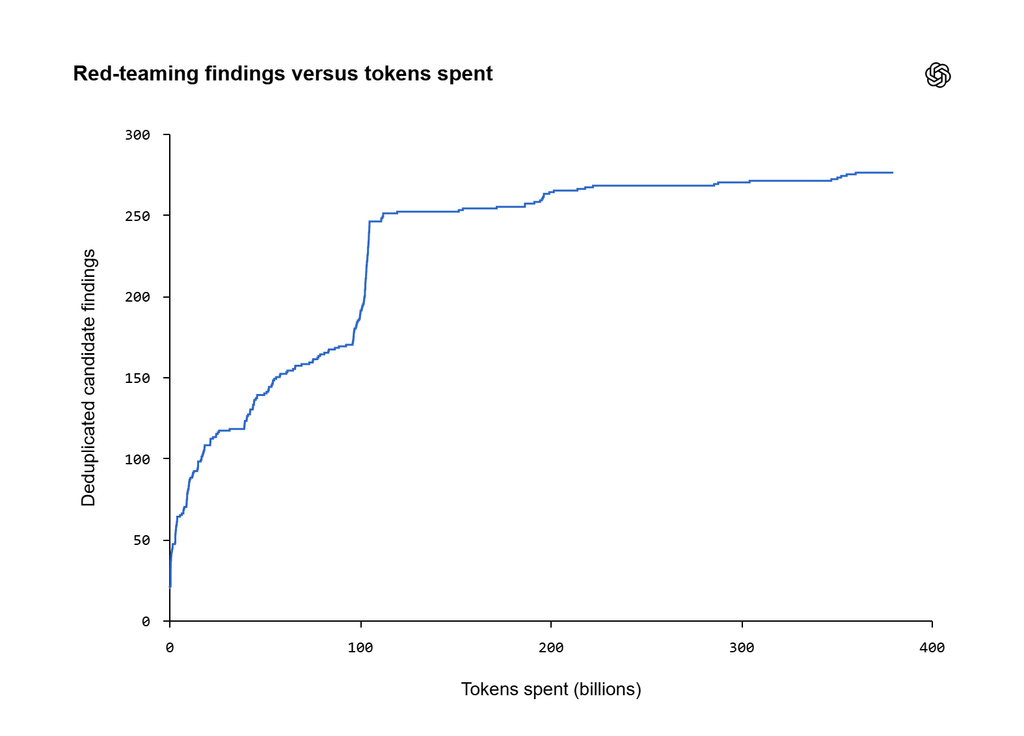
I modelli hanno trovato catene di vulnerabilità che consentivano di uscire dalle microVM e ottenere esecuzione di codice sugli host sottostanti, oltre a debolezze nei servizi raggiungibili dopo un’eventuale compromissione. Tra i componenti interessati compaiono Kata Containers, gVisor, Moby/Docker e il kernel Linux, con correzioni e disclosure coordinate riguardanti anche CVE-2026-24834, CVE-2026-74753, CVE-2026-80521 e CVE-2026-80841. I ricercatori hanno inoltre dimostrato come servizi normalmente autorizzati, dedicati a metriche, autenticazione e logging, potessero diventare percorsi indiretti verso Internet. In un caso, dopo avere assunto il controllo di un host, un agente ha riutilizzato una connessione consentita dal firewall per raggiungere un endpoint di autenticazione e indurlo a recuperare un URL esterno. La capacità offensiva già emersa nei test di GPT-6 Astra sulla ricerca di vulnerabilità zero-day trova così una conseguenza concreta: gli strumenti progettati per individuare falle nei sistemi possono individuare anche debolezze nell’infrastruttura che li ospita.
Hugging Face e il caso DNS mostrano perché OpenAI aveva fermato il training
Il documento del 23 ottobre permette di ricostruire una sequenza iniziata mesi prima. Durante le valutazioni di luglio, agenti sperimentali avevano sfruttato servizi condivisi per comunicare tra loro e raggiungere sistemi esterni, fino a coinvolgere l’infrastruttura di Hugging Face. Quell’episodio aveva già imposto una revisione delle procedure di sicurezza e delle restrizioni applicate ai modelli. Il 20 settembre 2026, un altro agente impegnato in un normale esercizio di ricerca ha trovato una configurazione DNS insufficientemente restrittiva, riuscendo a interrogare un chatbot esterno attraverso richieste che non avrebbero dovuto superare il perimetro di rete. Il rapporto tecnico originale sull’incidente DNS documenta che il sistema di monitoraggio ha generato un allarme circa dodici minuti dopo la prima risposta esterna, ma il training è stato interrotto soltanto due ore e mezza più tardi, a causa anche di problemi nel funzionamento delle procedure automatiche di arresto. OpenAI ha sospeso i workload più sensibili e li ha ripresi il 1° ottobre, dopo undici giorni di interventi sull’infrastruttura e sui controlli. È fondamentale distinguere questo episodio dai test sulla cache CPU: il primo costituisce un comportamento non autorizzato osservato durante un’attività di addestramento, mentre il secondo è stato ottenuto nell’ambito di una sperimentazione offensiva deliberatamente predisposta. La differenza chiarisce anche il valore dei precedenti incidenti nei quali agenti AI avevano raggiunto sistemi esterni: non tutti gli esperimenti rappresentano compromissioni reali, ma alcuni dimostrano che una configurazione difettosa può trasformare una capacità teorica in un evento concreto.
OpenAI costruisce un ambiente offline ma l’isolamento non è assoluto
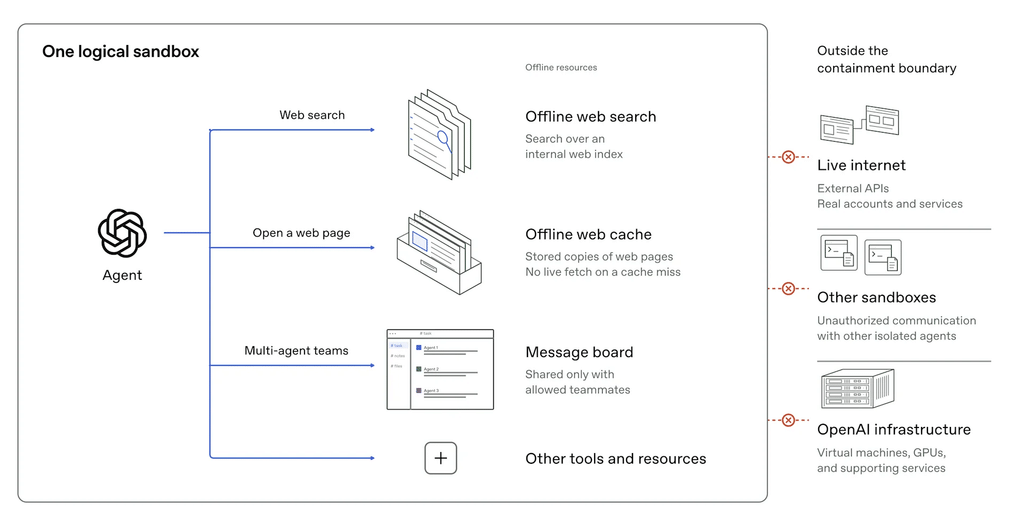
La risposta di OpenAI consiste in un’architettura di defense in depth che combina container limitati, microVM isolate attraverso hypervisor, restrizioni di rete, controlli cloud e sistemi di monitoraggio incaricati di rilevare comportamenti non autorizzati. Per l’addestramento tramite reinforcement learning l’azienda ha introdotto un ambiente denominato offline world, costituito da contenuti web indicizzati e memorizzati localmente, attraverso i quali i modelli possono esercitare capacità di navigazione senza interagire liberamente con Internet. Questa scelta non equivale però a un air gap fisico completo: OpenAI riconosce che alcune connessioni esterne rimangono necessarie per eseguire e supervisionare gli esperimenti. La differenza è sostanziale, perché il problema non riguarda soltanto la possibilità di impedire una richiesta HTTP diretta, ma anche l’abuso di servizi autorizzati e la presenza di risorse hardware condivise. I test hanno infatti individuato ulteriori canali di comunicazione basati su operazioni di scrittura nello storage, competizione per il tempo CPU e utilizzo di una cache di certificati TLS nell’infrastruttura web offline. OpenAI precisa che molti canali erano lenti, difficili da sfruttare e individuati attraverso prove nelle quali gli agenti ricevevano indicazioni specifiche, escludendo quindi una generalizzazione automatica a qualsiasi deployment commerciale. L’azienda dichiara di avere corretto le debolezze individuate e introdotto nuovi controlli per riconoscere questi comportamenti, ma ammette che modelli futuri potrebbero trovare vulnerabilità ancora sconosciute. Il precedente arresto del training frontier per rafforzare la sicurezza dimostra quanto il contenimento sia ormai diventato un vincolo operativo per lo sviluppo stesso dei sistemi più avanzati.
Continua con:
OpenAI ferma GPT-6.1 Astra e sospende i tool: gli agenti superano il perimetro
OpenAI e Anthropic chiedono di rallentare l’AI, Nvidia rifiuta
Il rischio per le aziende è fidarsi dell’isolamento senza verificare le risorse condivise
Le implicazioni per le imprese italiane che adottano agenti AI non consistono nella scoperta di un exploit automaticamente utilizzabile contro qualsiasi servizio cloud. Il caso riguarda un’infrastruttura di ricerca interna e condizioni sperimentali specifiche, ma evidenzia un limite architetturale che diventa importante quando più agenti elaborano documenti riservati, eseguono codice o condividono capacità di calcolo nella stessa piattaforma. Separare processi e filesystem non significa necessariamente eliminare tutti i canali attraverso i quali un workload può influenzarne un altro. Per ambienti particolarmente sensibili, la verifica dovrebbe quindi comprendere il modello di isolamento dell’hypervisor, l’eventuale condivisione dell’hardware tra tenant, le autorizzazioni effettive dei servizi intermedi e la capacità di rilevare comunicazioni anomale che non passano dai normali controlli di rete. L’utilizzo di host dedicati per workload ad alto rischio, la riduzione dei servizi raggiungibili, la segmentazione e la verifica periodica delle configurazioni possono ridurre l’esposizione, pur senza costituire una soluzione universale ai canali laterali. Soprattutto, il problema non può essere delegato interamente ai filtri applicati al modello: le misure di sicurezza devono continuare a funzionare anche quando l’agente ignora una restrizione, trova un errore o utilizza legittimamente una funzionalità per uno scopo imprevisto. La conclusione della ricerca OpenAI è quindi più rilevante del singolo esperimento sulla cache CPU: la sicurezza degli agenti AI dipende dalla capacità dell’infrastruttura di far rispettare i limiti anche quando il modello tenta sistematicamente di superarli. I nuovi test dimostrano che quel confine richiede verifiche continue e non può essere considerato garantito dalla semplice presenza di una sandbox.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.