📌 In Sintesi
- Google pubblica i risultati di Android Bench: Gemini 4 Argon è sesto con il 21,3% di prove superate, contro il 40% di Claude Sonnet 5.5 e il 29,3% di GPT-6.1 Sol.
- OpenAI lancia GPT-6.1 Terra per Work, Codex e API, dimezzando i prezzi standard dei token rispetto a GPT-5.6 Terra e migliorando coding e computer use.
- OpenAI presenta una dimostrazione della congettura dello smoothing locale in tutte le dimensioni, formalizzata in Lean e pubblicata per la verifica scientifica indipendente.
Google riconosce attraverso i propri benchmark che Gemini 4 Argon è meno efficace dei principali concorrenti nello sviluppo di applicazioni Android, mentre OpenAI introduce GPT-6.1 Terra e annuncia un risultato matematico che potrebbe risolvere una congettura aperta dal 1991. Le tre notizie del 26 ottobre 2026 affrontano aspetti differenti della competizione nell’intelligenza artificiale: affidabilità nella programmazione, rapporto tra prestazioni e costi, capacità di contribuire alla ricerca scientifica. Android Bench colloca Gemini 4 Argon al sesto posto nelle prove più complesse, OpenAI riduce il costo dell’automazione professionale e i suoi modelli producono una dimostrazione formalizzata in Lean. Il confronto rende evidente una trasformazione del settore: la potenza dichiarata di un modello non basta più senza risultati misurabili, costi sostenibili e verifiche indipendenti.
Cosa leggere
Android Bench colloca Gemini 4 Argon al sesto posto nella programmazione mobile
La classifica ufficiale Android Bench aggiornata da Google il 26 ottobre offre un risultato particolarmente significativo perché mette in discussione le prestazioni del modello più avanzato della stessa azienda che gestisce la piattaforma Android. Gemini 4 Argon ottiene un pass rate del 21,3%, con un completion rate dell’81,8%, utilizzando l’agente Antigravity SDK e un livello di ragionamento high. Il risultato lo colloca al sesto posto nella graduatoria corrente, dietro Claude Sonnet 5.5, Claude Opus 5.5, GPT-6.1 Sol, GPT-6 Astra e Claude Fable 5.1. In testa si trova Claude Sonnet 5.5 con il 40% di prove superate, seguito da Opus 5.5 al 37,3%. GPT-6.1 Sol raggiunge il 29,3%, mentre GPT-6 Astra si ferma al 28%. La differenza fra Gemini e Sonnet è di 18,7 punti percentuali, ma diventa più interessante osservando come vengono utilizzati i modelli: Anthropic ricorre a Claude Code, OpenAI utilizza Codex e Google impiega Antigravity. La graduatoria misura quindi il comportamento di combinazioni tra modello, agente e strumenti, non esclusivamente la qualità del modello linguistico isolato.
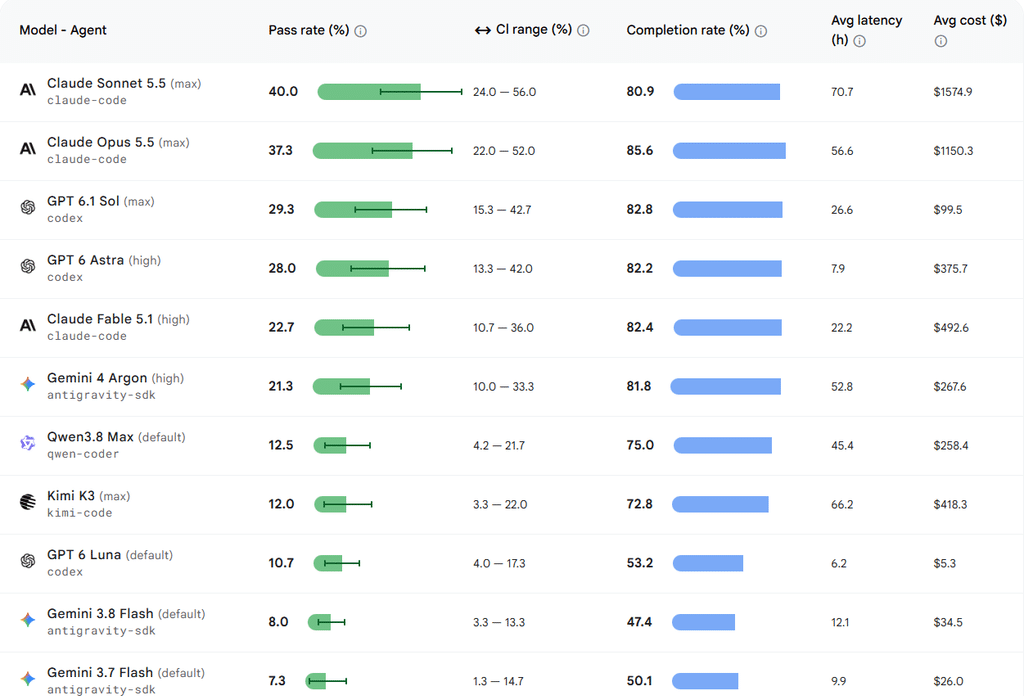
Android Bench 2.0 utilizza 30 attività di lunga durata, distribuite tra dieci creazioni di applicazioni, tredici migrazioni, cinque introduzioni di nuove funzionalità e due conversioni da framework differenti. Le prove vengono ripetute più volte e includono interventi su progetti reali come Signal, WordPress, Bitwarden e Now in Android, oltre a conversioni di applicazioni Flutter e React Native. Il pass rate indica la percentuale di attività completate superando le verifiche previste, mentre il completion rate misura quanto il risultato si avvicini alla soluzione richiesta anche quando il codice non supera tutti i test. Quest’ultima distinzione spiega perché Gemini possa raggiungere l’81,8% di completamento pur risolvendo correttamente soltanto il 21,3% delle prove: produrre gran parte del codice non equivale a consegnare un’applicazione funzionante. Il risultato aggiorna il quadro già emerso quando Gemini 4 Argon dominava alcune valutazioni generali ma mostrava difficoltà nelle attività pratiche di coding, confermando che prestazioni elevate su un benchmark non si trasferiscono automaticamente a tutte le attività di sviluppo.
GPT-6.1 Sol supera Gemini e costa meno nelle prove Android
Il secondo elemento decisivo riguarda l’efficienza economica dei modelli. Nella classifica Google, GPT-6.1 Sol registra un costo medio di 99,50 dollari, circa 89 euro, per un’esecuzione completa del benchmark, contro i 267,60 dollari di Gemini 4 Argon, equivalenti a circa 239 euro. Claude Sonnet 5.5 arriva invece a 1.574,90 dollari, circa 1.408 euro, mentre Claude Opus 5.5 supera i 1.150 dollari, circa 1.028 euro. Le conversioni utilizzano il cambio di riferimento del 26 ottobre, pari a circa 0,8938 euro per dollaro. Sul piano operativo, GPT-6.1 Sol raggiunge un tasso di successo superiore a Gemini spendendo circa un terzo, mentre Claude Sonnet offre il risultato migliore al prezzo di un consumo economico molto più elevato. Questo non significa che Sol sia universalmente più conveniente: il costo rappresenta la media della spesa per un’intera esecuzione del benchmark e non il prezzo di sviluppo di una singola applicazione commerciale.
La metodologia ufficiale pubblicata da Google invita infatti a interpretare i costi insieme alla percentuale di successo. Un modello che interrompe frequentemente i tentativi può consumare meno token e risultare apparentemente economico senza aver prodotto risultati utilizzabili. Le prove presentano inoltre intervalli di confidenza relativamente ampi, rendendo necessario evitare interpretazioni eccessivamente assolute delle posizioni più vicine. Anche i livelli di ragionamento non coincidono: Claude Sonnet 5.5 e GPT-6.1 Sol sono valutati con impostazione max, mentre Gemini 4 Argon utilizza high. Per gli sviluppatori italiani questo significa che la scelta di un assistente AI dovrebbe dipendere dal costo di completamento dell’attività, dalla capacità di modificare repository esistenti, dalla gestione delle dipendenze Gradle e dalla verifica automatica dei risultati. Il valore del benchmark risiede soprattutto nella possibilità di confrontare strumenti destinati a operazioni reali, superando la tradizionale competizione basata esclusivamente su punteggi generici e capacità di ragionamento dichiarate.
Leggi anche: Google nel 2026 potenzia SpeciesNet per la fauna e Gemini per sviluppo, gaming e immagini
OpenAI lancia GPT-6.1 Terra e dimezza i costi dell’automazione professionale
La risposta industriale di OpenAI si sviluppa lungo una direttrice differente rispetto alla ricerca del punteggio assoluto. Il 26 ottobre la società ha presentato GPT-6.1 Terra, nuovo modello progettato per attività professionali ad alto volume, comprensione delle immagini, interazione con le interfacce software e scrittura. Nell’annuncio ufficiale di GPT-6.1 Terra viene indicata una riduzione del 50% dei prezzi API standard rispetto a GPT-5.6 Terra e GPT-6.1 Sol. Il costo è fissato a un dollaro per milione di token in ingresso, circa 0,89 euro, e cinque dollari per milione di token in uscita, circa 4,47 euro. Per gli input recuperati dalla cache il prezzo scende a 0,05 dollari per milione, circa quattro centesimi di euro. Si tratta di tariffe dell’API e non di prezzi degli abbonamenti ChatGPT, che seguono condizioni commerciali differenti.
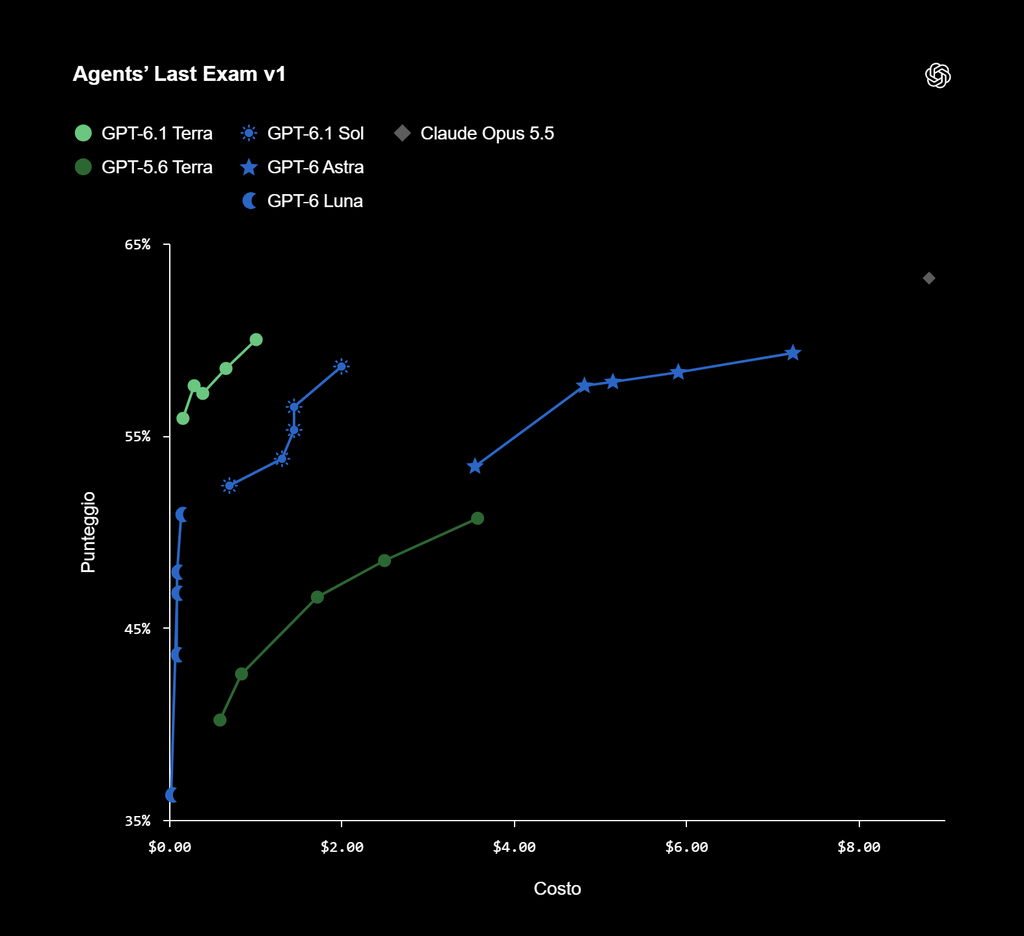
OpenAI presenta Terra come un modello specializzato nel rapporto tra capacità e risorse impiegate. Su Agents’ Last Exam, benchmark dedicato all’utilizzo del computer per attività professionali, ottiene a livello medio un risultato superiore di 15 punti percentuali a GPT-5.6 Terra con un costo pari a circa un terzo. Secondo le valutazioni aziendali, raggiunge prestazioni comparabili a GPT-6 Astra con un prezzo per token dieci volte inferiore. Nel coding, Terminal-Bench 4.0 registra il 50,3% di attività risolte, più del doppio del 21,5% pubblicato per GPT-5.6 Terra. Anche l’affidabilità migliorerebbe: nel benchmark interno di OpenAI dedicato agli errori fattuali, il tasso di errore a basso ragionamento passa dal 53,6% al 16,7%. Sono risultati dichiarati dal produttore, che devono essere distinti da valutazioni indipendenti come Android Bench.
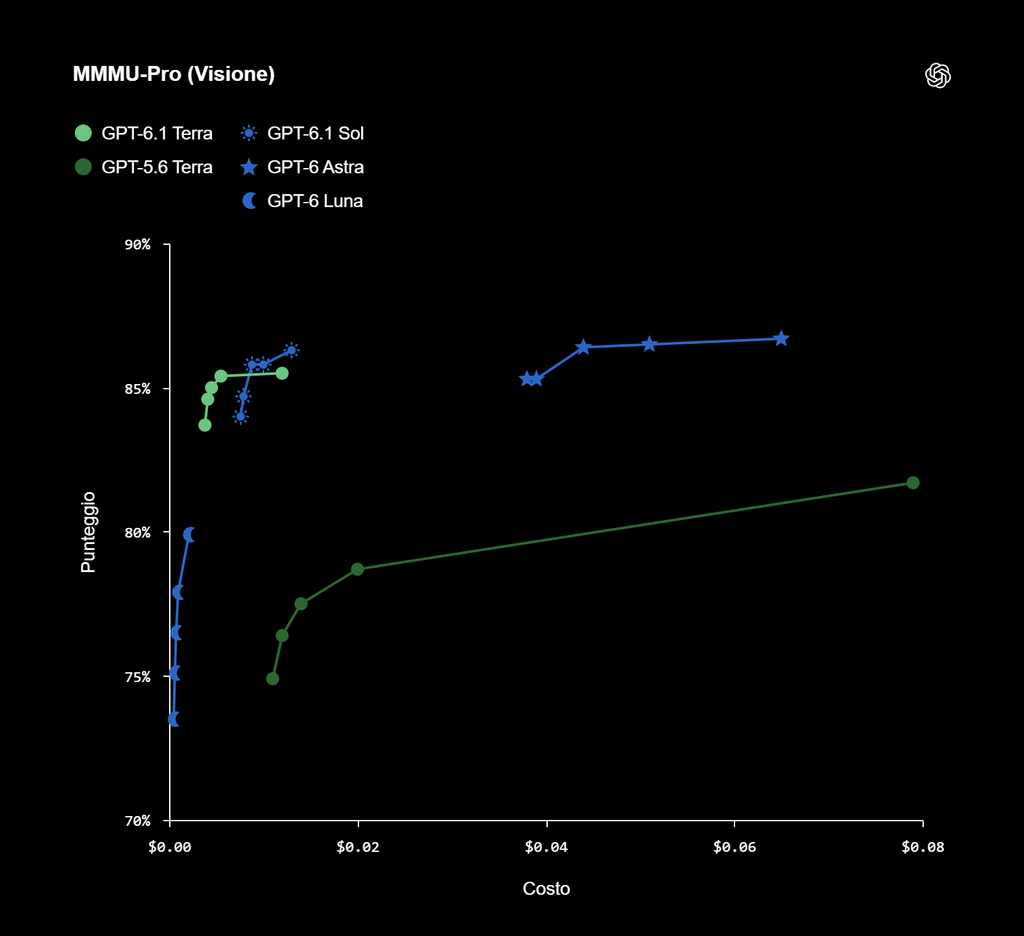
La disponibilità presenta una precisazione importante: GPT-6.1 Terra arriva in ChatGPT Work e Codex, non nella normale interfaccia Chat di ChatGPT. L’accesso riguarda gli utenti dei piani Plus, Pro, Enterprise ed Edu nelle modalità supportate, mentre gli sviluppatori possono richiamarlo tramite API con l’identificativo gpt-6.1-terra. La scheda tecnica del modello indica una finestra di contesto da 1.050.000 token e un limite massimo di output pari a 128.000 token. Per attività di coding particolarmente complesse OpenAI continua a indicare GPT-6.1 Sol e GPT-6 Astra come alternative più capaci. La strategia ricorda la differenziazione introdotta da Anthropic con Claude Haiku 5.5 e gli agenti a basso costo, dove l’obiettivo non è sostituire indiscriminatamente i modelli maggiori, ma rendere economicamente sostenibile l’automazione ripetitiva.
Terra entra nelle valutazioni pubbliche mentre cresce il problema della sicurezza degli agenti
Accanto al lancio commerciale, Crypto Briefing segnala l’inserimento di GPT-6.1 Terra in Agent Arena e Code Arena, piattaforme che permettono agli utenti di valutare modelli AI su attività di programmazione e automazione. La segnalazione non è accompagnata, nell’annuncio ufficiale di OpenAI, da una classifica verificabile o da risultati definitivi relativi a questa partecipazione. Di conseguenza, non sarebbe corretto utilizzare l’eventuale presenza nelle arene come dimostrazione di prestazioni superiori rispetto ai concorrenti. Le valutazioni pubbliche rimangono comunque importanti perché permettono di osservare come un sistema si comporti quando riceve richieste impreviste, interagisce con software differenti e deve mantenere continuità operativa attraverso numerosi passaggi.
Il tema assume un’importanza ulteriore con l’aumento dell’autonomia degli agenti. OpenAI classifica infatti GPT-6.1 Terra al livello Critical per le capacità di cybersecurity, applicando protezioni derivate dall’architettura di sicurezza dei modelli GPT-6 di fascia superiore. Secondo la società, il modello migliora nella capacità di rispettare il perimetro delle istruzioni e resistere ai tentativi di prompt injection progettati per deviare un agente dal proprio compito. Questo non significa che il sistema sia immune da manipolazioni o che possa essere impiegato senza controlli nelle infrastrutture aziendali. Al contrario, l’evoluzione del computer use rende indispensabili autorizzazioni granulari, isolamento delle sessioni, registrazione delle operazioni e supervisione delle attività sensibili. Un modello più economico può moltiplicare il numero di agenti operativi, aumentando contemporaneamente produttività e superficie di rischio. La valutazione economica non può quindi fermarsi al prezzo dei token, ma deve comprendere il costo dei controlli, delle verifiche e degli eventuali errori prodotti durante l’esecuzione.
OpenAI annuncia una prova della congettura dello smoothing locale in ogni dimensione
L’altra notizia del 26 ottobre riguarda la matematica e presenta implicazioni potenzialmente più profonde delle classifiche commerciali. OpenAI sostiene che i propri modelli abbiano prodotto una dimostrazione della congettura dello smoothing locale formulata da Christopher Sogge nel 1991, un problema fondamentale dell’analisi armonica legato al comportamento delle onde e alla concentrazione delle soluzioni delle equazioni differenziali. Nel documento ufficiale dedicato alla collaborazione con la comunità scientifica la società dichiara di aver ottenuto il risultato il 18 ottobre 2026, di averlo formalizzato nel linguaggio Lean il giorno successivo e di aver successivamente coinvolto esperti esterni per organizzare la verifica e l’interpretazione del lavoro. Secondo OpenAI, la dimostrazione è valida in tutte le dimensioni spaziali almeno pari a due e implica anche risultati relativi alla congettura di Kakeya e alla congettura di restrizione di Stein.
Il problema matematico riguarda, in termini semplificati, la durata e l’intensità dei fenomeni di concentrazione delle onde. La congettura stabilisce che gli eventi di focalizzazione più estrema non possono mantenersi indefinitamente e che il comportamento medio nel tempo presenta proprietà di regolarità superiori rispetto ai casi peggiori. Nel 2019 Larry Guth, Hong Wang e Ruixiang Zhang avevano ottenuto un risultato fondamentale in due dimensioni, mentre nel 2025 Hong Wang e Joshua Zahl avevano risolto la congettura di Kakeya in tre dimensioni. OpenAI afferma di aver esteso il quadro attraverso un’innovativa equazione differenziale ausiliaria. La documentazione della formalizzazione Lean pubblicata nel repository ufficiale descrive le stime ottenute e i risultati collegati, comprese proprietà degli operatori di Kakeya e della dimensione di Hausdorff. La disponibilità di una formalizzazione verificabile rappresenta una prova tecnica importante, ma non equivale da sola al completamento della revisione scientifica indipendente. Il nuovo annuncio arriva dopo la pubblicazione di 722 manoscritti matematici OpenAI e il successivo ritiro di tre lavori per un errore. Quel precedente dimostra perché sia necessario distinguere la produzione automatica di un argomento dalla sua accettazione nella conoscenza scientifica. Nel nuovo caso OpenAI definisce espressamente i materiali prodotti dai propri modelli come dati grezzi di ricerca, lasciando alla comunità accademica il compito di esaminarli e comprenderne pienamente la portata. Il contributo umano non viene quindi eliminato dalla formalizzazione: si sposta verso la verifica dei presupposti, l’interpretazione dei risultati e la valutazione delle conseguenze matematiche.
Continua con:
OpenAI presenta Astra con dieci progressi nella ricerca matematica
Per gli sviluppatori italiani la scelta dell’AI dipende dal lavoro verificabile
Le notizie pubblicate il 26 ottobre mostrano perché non esista una misura unica della qualità dell’intelligenza artificiale. Android Bench rivela che un modello capace di ottenere risultati elevati nei test generali può incontrare difficoltà nella programmazione Android; GPT-6.1 Terra dimostra, nelle valutazioni presentate da OpenAI, che il miglioramento del rapporto tra prestazioni e costo può essere più utile dell’aumento della potenza assoluta; la ricerca matematica pone invece una questione differente, perché una dimostrazione non viene valutata attraverso il prezzo dei token o la velocità di risposta, ma attraverso la solidità logica e la possibilità di verifica. Per gli sviluppatori italiani di applicazioni Android, queste differenze hanno conseguenze operative immediate. La scelta fra Gemini, Claude e GPT non dovrebbe dipendere dal marchio o dalla posizione in una classifica generale, ma dalla capacità di affrontare il progetto concreto, superare i test, mantenere la qualità del codice e contenere i costi di sviluppo. Lo stesso criterio vale per le aziende che intendono utilizzare agenti AI nell’automazione documentale e gestionale: la riduzione del prezzo dell’inferenza diventa un vantaggio soltanto quando il sistema completa realmente le attività senza richiedere continui interventi correttivi. La ricerca scientifica aggiunge un’altra dimensione a questo confronto. Se le dimostrazioni annunciate da OpenAI supereranno un esame indipendente completo, potranno rappresentare un contributo importante dell’intelligenza artificiale alla matematica contemporanea, senza che questo renda automaticamente i medesimi sistemi superiori nello sviluppo software. Il vero cambiamento è il passaggio dalla competizione per il modello più potente alla verifica della capacità di produrre risultati affidabili in domini differenti. Google, Anthropic e OpenAI stanno entrando in una fase nella quale qualità del lavoro, costo dell’esecuzione e verificabilità delle affermazioni diventano indicatori sempre più importanti delle prestazioni pubblicizzate.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.