📌 In Sintesi
- Microsoft separa AI Training e AI Grounding, consentendo agli editori di vietare l’addestramento dei modelli senza rinunciare automaticamente all’utilizzo dei contenuti nelle risposte AI.
- Le preferenze saranno applicate dal 1° febbraio 2027. Per i siti che utilizzano NoArchive e NoCache è prevista una transizione con scadenza il 1° marzo.
- Le nuove direttive non modificano l’idoneità alla ricerca tradizionale di Bing, ma le restrizioni sul grounding possono ridurre la visibilità nelle risposte AI. Nessuna opzione garantisce traffico o compensi.
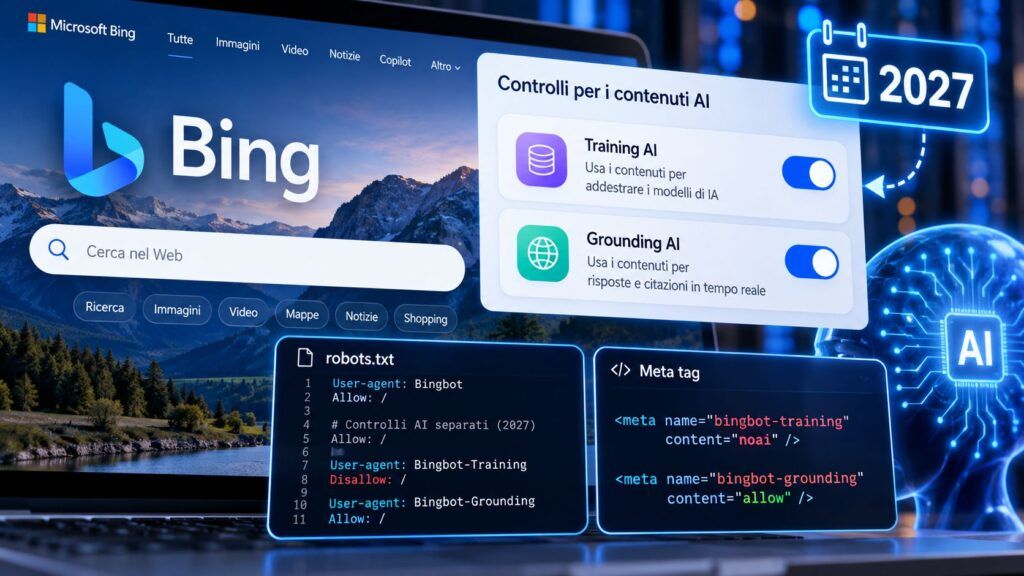
Microsoft introduce una distinzione fondamentale tra l’utilizzo dei contenuti editoriali per addestrare l’intelligenza artificiale e quello necessario a costruire risposte generate dai modelli. Dal 1° febbraio 2027, Bing inizierà a rispettare nuove preferenze espresse attraverso robots.txt, meta tag e intestazioni HTTP, permettendo agli editori di decidere separatamente se autorizzare AI Training e AI Grounding. La scelta non dovrebbe compromettere l’idoneità dei contenuti a comparire nei risultati tradizionali del motore di ricerca, ma Microsoft avverte che limitare il grounding può ridurre sensibilmente la presenza nelle esperienze AI. L’annuncio introduce inoltre una transizione obbligatoria per chi utilizza le precedenti direttive NoArchive e NoCache, mettendo in evidenza un problema centrale per l’editoria digitale: controllare l’utilizzo delle notizie senza dover rinunciare alla distribuzione del traffico.
Cosa leggere
Microsoft distingue l’addestramento AI dall’utilizzo delle fonti nelle risposte
Il cambiamento annunciato da Krishna Madhavan, Principal Product Manager di Microsoft Bing, parte da una distinzione che fino a oggi è stata spesso affrontata in maniera indistinta nel confronto tra motori di ricerca ed editori. AI Training identifica l’utilizzo di contenuti per modificare i parametri appresi da un modello generativo, mentre AI Grounding riguarda l’impiego di informazioni esterne per costruire, verificare o contestualizzare una risposta nel momento in cui viene generata. Le due operazioni hanno finalità tecniche differenti e Microsoft decide di introdurre preferenze indipendenti, consentendo agli editori di vietare la prima senza bloccare necessariamente la seconda. Nel comunicato ufficiale Your content, your choice, l’azienda precisa che le nuove regole riguardano i contenuti web raccolti attraverso i propri crawler e utilizzati per addestrare modelli o alimentare risposte generate all’interno di Bing, Copilot e Microsoft 365. La preferenza relativa al training si inserisce nel lavoro del gruppo IETF AI Preferences, che da oltre un anno sviluppa una sintassi comune per permettere ai siti web di dichiarare le proprie condizioni. Il lavoro è ancora descritto in un Internet-Draft, non in uno standard definitivo, mentre Microsoft aggiunge una preferenza specifica per il grounding. Il risultato non è un sistema universale di autorizzazione vincolante per tutti gli operatori AI, ma un insieme di direttive che Microsoft dichiara di voler rispettare nei propri processi di raccolta e utilizzo dei contenuti.
Robots.txt controlla il training, i meta tag regolano le singole pagine
La novità operativa riguarda il modo in cui gli editori potranno esprimere le proprie preferenze senza bloccare l’indicizzazione ordinaria dei contenuti. Per impedire l’utilizzo dell’intero sito nell’addestramento dei modelli generativi, Microsoft introduce una direttiva specifica nel file robots.txt, basata sullo user-agent __usage_ai-training. La sintassi prevista dal comunicato è:
User-Agent: __usage_ai-training
Disallow: /
La direttiva esprime una preferenza di divieto per l’intero dominio, mentre un percorso specifico può essere utilizzato per limitare il training soltanto a determinate sezioni del sito. Microsoft ammette anche la possibilità di autorizzare esplicitamente l’addestramento attraverso Allow: /, sebbene questa sia già la condizione predefinita in assenza di restrizioni. Per le singole pagine viene introdotta una seconda modalità, basata su meta tag HTML oppure intestazioni HTTP. Un editore può quindi utilizzare <meta name="Bingbot" content="ai-training:disallow"> oppure l’intestazione X-Robots-Tag: Bingbot: ai-training:disallow. La differenza non è marginale: la preferenza di training dichiarata a livello di pagina prevale su quella presente in robots.txt, permettendo di gestire eccezioni per articoli, sezioni e tipologie di contenuti. Il grounding utilizza invece esclusivamente impostazioni a livello di pagina, attraverso ai-grounding:disallow oppure la variante più granulare ai-grounding:disallowextended. Microsoft non introduce una direttiva robots.txt valida per vietare il grounding di un intero dominio. Gli editori che intendono applicare questa restrizione a tutti gli articoli dovranno quindi predisporre una configurazione capace di pubblicarla sulle singole pagine, per esempio attraverso il template del CMS o le intestazioni generate dal server.
DisallowExtended limita l’AI dei partner senza escludere Copilot
La possibilità di scegliere fra tre impostazioni di grounding costituisce uno degli elementi più significativi dell’annuncio. Allow autorizza l’utilizzo dei contenuti per costruire risposte AI ed è la condizione predefinita quando il sito non pubblica una preferenza applicabile. Disallow impedisce invece che quei contenuti vengano utilizzati per informare le risposte generate dai sistemi coperti dalla policy Microsoft. Tra queste due opzioni viene introdotta DisallowExtended, che consente il grounding nelle esperienze gestite direttamente da Microsoft ma lo esclude dai servizi di grounding forniti a soggetti terzi. La distinzione comprende prodotti come Bing AI Mode, AI Overview, Copilot e Microsoft 365, che possono continuare a utilizzare il contenuto, mentre vengono escluse le integrazioni commerciali offerte attraverso Web IQ e le API di grounding disponibili in Microsoft Foundry. Per un editore significa poter distinguere l’utilizzo all’interno dei prodotti Microsoft dalla distribuzione del proprio contenuto a servizi esterni che si appoggiano alle infrastrutture del gruppo. Il sistema introduce così una separazione tecnica fra ricerca, addestramento, risposte AI proprietarie e servizi commerciali di terze parti. Microsoft avverte però che la scelta di DisallowExtended o Disallow comporterà una riduzione della visibilità del marchio nelle esperienze AI, pur non modificando l’idoneità dei contenuti ai normali risultati di ricerca Bing. Il mantenimento dell’indicizzazione non equivale quindi alla conservazione della stessa esposizione commerciale, soprattutto quando una quota crescente delle informazioni viene presentata direttamente nelle risposte generate.
Dal 1° febbraio al 1° marzo 2027 cambia la gestione di NoArchive e NoCache
Il calendario di transizione richiede particolare attenzione perché riguarda direttamente gli editori che utilizzano le precedenti direttive Microsoft NoArchive e NoCache. Il 15 dicembre 2026 verrà aperta in Bing Webmaster Tools una procedura temporanea dedicata ai siti che risultano utilizzare queste restrizioni a quella data. Dal 1° febbraio 2027, Bing inizierà a rispettare le nuove preferenze AI Training e AI Grounding quando effettuerà la scansione delle pagine. Il termine decisivo è però il 1° marzo 2027: dopo questa data Microsoft non interpreterà più NoArchive e NoCache come preferenze valide per training e grounding. I publisher che intendono conservare le precedenti limitazioni dovranno quindi pubblicare le nuove direttive e, per il grounding, registrare anche una preferenza temporanea in Bing Webmaster Tools se rientrano nei requisiti della transizione. Questa misura serve a evitare che la mancata scansione immediata delle pagine faccia decadere una restrizione già espressa. La preferenza temporanea rimarrà valida fino alla nuova scansione della pagina oppure al 30 settembre 2027, a seconda di quale evento si verifichi per primo. Se un editore non registra la preferenza temporanea entro il 1° marzo, i contenuti precedentemente protetti da NoArchive o NoCache potranno tornare alla condizione predefinita Allow per il grounding fino alla scoperta delle nuove direttive. Microsoft chiarisce inoltre che, quando rileva una nuova preferenza AI Training o AI Grounding, ignora le eventuali vecchie direttive ancora presenti sul sito. La pubblicazione di un meta tag non equivale alla sua immediata applicazione: occorre che Bing effettui una nuova scansione. IndexNow può segnalare la modifica e favorire il recrawl, ma non ne garantisce la data.
Per gli editori italiani il consenso tecnico non risolve il problema economico
La decisione di Microsoft interviene mentre il rapporto fra piattaforme AI e industria dell’informazione è al centro di controversie economiche e giuridiche. La possibilità di rifiutare l’addestramento mantenendo la presenza nella ricerca tradizionale rappresenta un miglioramento rispetto a modelli nei quali il publisher deve bloccare completamente i crawler per limitare determinati utilizzi. Rimane però aperta una distinzione essenziale: un meccanismo di opt-out non coincide con un contratto di licenza, non stabilisce un compenso e non determina il valore economico dei contenuti utilizzati. Microsoft lo afferma esplicitamente, precisando che nessuna delle scelte garantisce inclusione nelle risposte AI, traffico verso il sito o pagamenti. È un punto particolarmente rilevante nel contesto italiano, dove la discussione sull’equo compenso e sui rapporti commerciali fra editori e piattaforme ha già mostrato quanto sia complesso trasformare il riconoscimento del valore dell’informazione in una remunerazione effettiva. Il controllo annunciato da Bing interviene sul piano tecnico delle preferenze, senza affrontare direttamente la negoziazione economica, la rendicontazione degli utilizzi o la possibilità di verificare in maniera indipendente il rispetto delle restrizioni. Per una testata giornalistica il problema è concreto: autorizzare il grounding può favorire citazioni e visibilità, ma non assicura una visita; limitarlo può ridurre l’impiego dei contenuti nei sistemi generativi, ma restringe contemporaneamente le opportunità di essere individuati attraverso quelle interfacce. L’editore conserva una scelta, ma deve esercitarla in un mercato nel quale la piattaforma controlla ancora una parte rilevante della distribuzione.
Leggi anche: Bing misura la SEO nell’AI: Topics Portfolio mostra dove un sito conta davvero
Bing Webmaster Tools separa visibilità AI e controllo dei diritti
Le nuove preferenze assumono ulteriore significato se confrontate con gli strumenti di misurazione introdotti da Microsoft nel corso del 2026. Bing Webmaster Tools aveva già iniziato a distinguere le tradizionali impressioni di ricerca dalle citazioni prodotte nei sistemi generativi, introducendo metriche come Citation Share, Intents, Topics e Opportunity Queries. Il nuovo sistema aggiunge una dimensione differente: il publisher non deve soltanto osservare dove il proprio contenuto viene utilizzato, ma può decidere per quali categorie di utilizzo dichiarare il consenso o il divieto tecnico. La separazione fra ricerca e grounding rappresenta un elemento importante perché chiarisce che l’indicizzazione di una pagina e il suo impiego nella generazione di risposte non sono necessariamente la stessa attività. Microsoft precisa infatti che i risultati tradizionali di Bing continuano a essere disciplinati dai normali requisiti di scansione e indicizzazione, mentre le preferenze AI non concedono automaticamente accesso ai contenuti quando Bingbot è bloccato dal robots.txt. La distinzione non produce neppure nuove licenze: esprime condizioni che Microsoft dichiara di applicare ai propri servizi. Il sistema di misurazione delle citazioni può quindi aiutare un editore a capire quale visibilità rischia di ridurre attraverso un divieto, ma non dimostra da solo quante visite o quanti ricavi quella scelta potrebbe produrre. La precedente introduzione di AI Visibility Insights aveva già evidenziato che la presenza di un sito nei risultati generativi richiede indicatori differenti da quelli utilizzati nella SEO tradizionale. Le nuove preferenze rendono questa distinzione ancora più concreta.
WordPress e CMS dovranno gestire le preferenze per ogni contenuto
Per i siti editoriali basati su WordPress, la conseguenza operativa è la necessità di distinguere le direttive generali pubblicate in robots.txt dai controlli specifici inseriti nelle pagine. Un editore che desideri impedire l’addestramento AI dell’intero archivio può utilizzare la preferenza globale, ma dovrà valutare separatamente il grounding, soprattutto se intende consentire l’impiego di alcuni contenuti nelle risposte Copilot ed escluderne altri. La gestione potrebbe richiedere modifiche ai template, alle intestazioni HTTP o alle configurazioni SEO, prestando attenzione a eventuali direttive contrastanti prodotte da più componenti del CMS. Non è sufficiente aggiungere un blocco indiscriminato dei crawler, perché un divieto di scansione può interferire con l’indicizzazione tradizionale che Microsoft dichiara di voler preservare attraverso le nuove preferenze. Occorre inoltre verificare il comportamento del sistema di cache e del CDN affinché i meta tag e le intestazioni restituiti ai crawler corrispondano alle scelte effettive dell’editore. Il passaggio finale resta il monitoraggio delle scansioni e dell’applicazione delle preferenze: una configurazione tecnicamente corretta non produce effetti immediati se Microsoft non ha ancora acquisito la versione aggiornata della pagina. La finestra temporale che si aprirà nel febbraio 2027 rende quindi necessario programmare la transizione senza attendere il superamento della scadenza del 1° marzo.
Continua con:
Google paga gli editori per l’AI, ma non per ogni AI Overview
Microsoft concede più scelta ma il valore economico delle notizie rimane fuori
L’annuncio di Bing introduce un passaggio significativo nella regolazione tecnica dei rapporti fra editori e sistemi generativi: training e grounding vengono riconosciuti come utilizzi distinti, con preferenze autonome e conseguenze differenti. Un sito potrà vietare che i propri contenuti contribuiscano all’addestramento dei modelli, continuando a renderli disponibili per la generazione di risposte Microsoft, oppure scegliere restrizioni più severe, fino a escludere il grounding. La ricerca tradizionale rimarrà formalmente separata, ma la piattaforma avverte che rinunciare alle esperienze AI comporterà una minore visibilità in quegli ambienti. È proprio questa condizione a rappresentare il limite più rilevante del nuovo sistema: l’editore può scegliere come dichiarare le proprie preferenze, ma non determina il peso che quelle preferenze avranno sulla distribuzione delle notizie. Nessuna direttiva stabilisce un compenso, una licenza commerciale o un diritto automatico al traffico, mentre il rispetto operativo delle scelte continuerà a dipendere dai crawler e dai servizi gestiti da Microsoft. La nuova architettura risolve quindi una parte del problema del controllo tecnico, senza risolvere quello economico dell’utilizzo dei contenuti editoriali da parte dell’intelligenza artificiale. Per il giornalismo indipendente europeo la distinzione è decisiva: poter rifiutare un impiego della propria informazione costituisce una possibilità concreta, ma non equivale ancora alla capacità di negoziarne il valore.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.