📌 In Sintesi
- Le Linee Guida AgID del 9 novembre 2026 trasformano l’adozione dell’IA nella PA in un processo organizzativo permanente, che comprende strategia, governance, gestione del rischio, dati, sicurezza, formazione, monitoraggio e responsabilità.
- Il Responsabile per la Transizione Digitale resta il perno della governance, mentre nelle amministrazioni con uso intensivo dell’IA può essere istituito un Responsabile dell’Intelligenza Artificiale con un proprio ufficio, sempre sotto le direttive del RTD.
- L’IA pubblica non può essere valutata soltanto per accuratezza o velocità: servono controllo umano, qualità dei dati, tracciabilità, privacy, sicurezza cibernetica, trasparenza, auditabilità e capacità della PA di mantenere il controllo sui fornitori e sull’intero ciclo di vita.
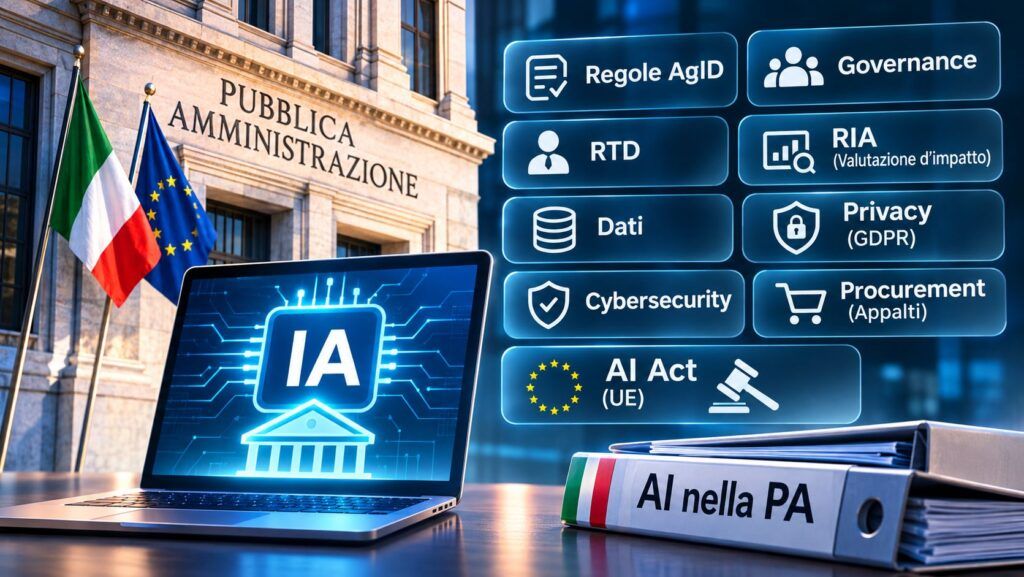
L’intelligenza artificiale entra definitivamente nella Pubblica Amministrazione italiana non come semplice strumento sperimentale, ma come una nuova componente dell’organizzazione dello Stato. Le Linee Guida AgID per l’adozione di IA nella PA, nella versione definitiva del 9 novembre 2026, costruiscono un modello che parte dalla strategia e arriva alla dismissione del sistema, attraversando governance, responsabilità, dati, formazione, trasparenza, cybersecurity e valutazione dei rischi. Il salto è sostanziale: non basta più acquistare un chatbot, collegare un modello linguistico a un archivio o automatizzare una pratica amministrativa. La PA deve sapere perché usa l’IA, chi ne risponde, quali dati alimentano il sistema, quali rischi produce, come viene controllato e cosa accade quando il fornitore cambia, il modello viene aggiornato o il servizio deve essere dismesso.
Cosa leggere
La determinazione con cui AgID ha adottato le Linee Guida definitive colloca il documento dentro il Piano triennale per l’informatica nella Pubblica Amministrazione 2024-2026 e dentro una cornice ormai molto più ampia del semplice Codice dell’amministrazione digitale. Il testo nasce infatti dal lavoro congiunto di AgID, ACN, ANAC, ANCI, Regioni, Consip, Dipartimento della Funzione Pubblica, Dipartimento per la Trasformazione Digitale, INAIL, INPS, ISTAT, IPZS, MEF, MIMIT, PagoPA e UPI. È quindi un documento che prova a trasformare il dibattito teorico sull’IA pubblica in una struttura amministrativa concreta.
Le Linee Guida AgID cambiano il modo in cui la PA deve pensare l’intelligenza artificiale
Le Linee Guida non riguardano soltanto i sistemi classificati ad alto rischio dall’AI Act. Il loro ambito oggettivo comprende tutti i sistemi e i modelli di intelligenza artificiale definiti dal regolamento europeo e richiamati dalla normativa nazionale, mentre l’ambito soggettivo coincide con le amministrazioni individuate dall’articolo 2, comma 2, del CAD. Questo significa che l’approccio organizzativo indicato da AgID è destinato a entrare nella gestione quotidiana dell’innovazione pubblica, ben oltre i casi estremi o più sensibili. Il lessico utilizzato è particolarmente importante. Nel documento, “DEVE” indica un requisito obbligatorio, “NON DEVE” un divieto assoluto, “DOVREBBE” una raccomandazione dalla quale ci si può discostare solo valutandone consapevolmente le conseguenze, mentre “PUÒ” identifica una possibilità. Non si tratta quindi di una raccolta generica di buone pratiche. La struttura è prescrittiva e costruisce un percorso che le amministrazioni devono poter documentare.
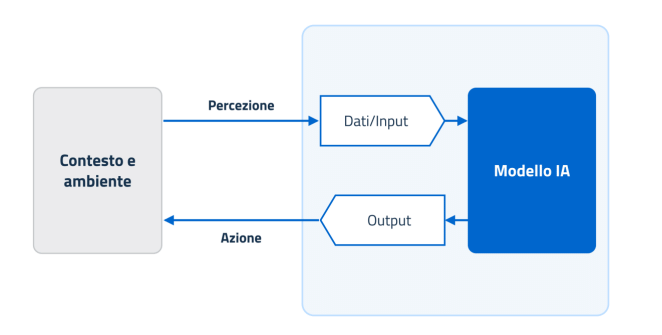
Il modello parte da un principio semplice: un sistema di IA non coincide con il modello che lo alimenta. Nello schema funzionale illustrato a pagina 24 delle Linee Guida, il modello riceve dati e input, produce output e interagisce con un contesto fisico o virtuale attraverso azioni e decisioni. Questa distinzione è fondamentale perché una PA non può valutare soltanto il modello linguistico o predittivo acquistato dal fornitore. Deve valutare l’intero sistema: dati, API, interfacce, autorizzazioni, strumenti collegati, log, infrastruttura, persone e processi amministrativi sui quali gli output incidono. Il precedente dedicato alle bozze AgID su IA, lock-in e sovranità digitale aveva già individuato il rischio principale: modernizzare l’amministrazione acquistando tecnologie che aumentano la dipendenza dai fornitori invece di rafforzare il controllo pubblico. La versione definitiva sposta ora l’attenzione dall’enunciazione del principio alla costruzione di una vera governance interna.
Dalla sperimentazione alla strategia: l’IA entra nel governo dell’amministrazione
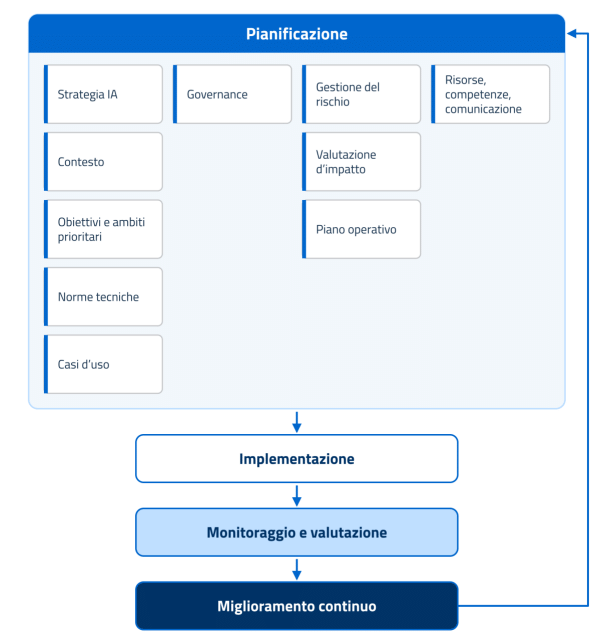
Il passaggio più importante riguarda la strategia per l’intelligenza artificiale. L’amministrazione non dovrebbe partire dalla domanda “quale modello possiamo acquistare?”, ma dall’analisi dei propri obiettivi, dei procedimenti, dei dati disponibili, delle infrastrutture, delle competenze e dei rischi. Le Linee Guida organizzano il percorso in strategia, analisi del contesto, individuazione degli ambiti prioritari, norme tecniche, casi d’uso, KPI, governance, gestione del rischio, valutazione d’impatto, piano operativo, risorse, implementazione, monitoraggio e miglioramento continuo.
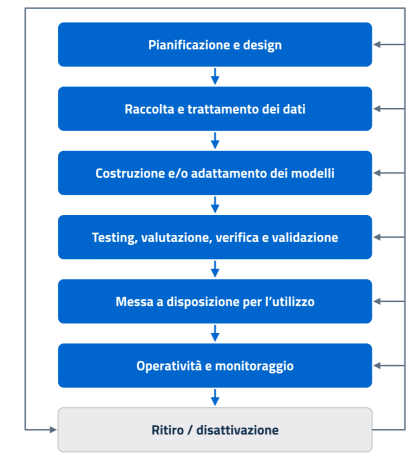
La logica è quella del ciclo di vita. Non esiste più una fase in cui l’ente “compra l’AI” e il progetto può considerarsi concluso. Ogni sistema deve essere pianificato, sviluppato o acquisito, implementato, monitorato, modificato e infine dismesso. L’amministrazione deve quindi essere capace di governare non soltanto la scelta iniziale, ma anche gli aggiornamenti del modello, i cambiamenti dei dataset, le nuove vulnerabilità, la variazione delle prestazioni e l’evoluzione normativa.
Questo approccio modifica anche la natura delle sperimentazioni. Le Linee Guida incoraggiano l’avvio da casi d’uso meno complessi e da quick win, anche attraverso forme aggregate tra amministrazioni, ma chiedono che la sperimentazione abbia un obiettivo, indicatori e un percorso verso la messa in esercizio. Il proof of concept non può trasformarsi in un limbo permanente nel quale tecnologie esterne vengono provate su dati pubblici senza una chiara governance. La conseguenza è che l’IA diventa materia del PIAO, della strategia digitale, della data governance e della programmazione dell’ente. È un cambiamento rilevante: la tecnologia smette di essere progetto confinato alla direzione informatica e diventa parte del modo in cui l’amministrazione organizza servizi, responsabilità e processi decisionali.
RTD, RIA e UIA: chi governa l’intelligenza artificiale nella PA
Il centro della governance resta il Responsabile per la Transizione Digitale, insieme all’Ufficio per la Transizione Digitale. Le Linee Guida attribuiscono al RTD il coordinamento della strategia IA e della governance dei dati, prevedendo il coinvolgimento del Responsabile della protezione dei dati e del referente per la cybersicurezza. Nei contesti in cui l’uso dell’intelligenza artificiale diventa particolarmente intenso, l’amministrazione può istituire un Responsabile dell’Intelligenza Artificiale, RIA, al quale può essere assegnato un Ufficio del Responsabile dell’Intelligenza Artificiale, UIA.
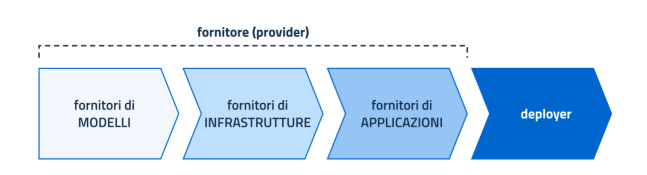
La distinzione è importante. Il RIA non sostituisce il RTD e non crea automaticamente una nuova catena gerarchica autonoma. Opera secondo le direttive del responsabile della transizione digitale e serve soprattutto dove la quantità e la complessità dei sistemi adottati rendono necessaria una funzione specializzata. Il modello evita così, almeno sulla carta, due errori opposti: lasciare l’IA nelle mani di singoli uffici che acquistano strumenti senza coordinamento oppure creare un nuovo “capo dell’AI” scollegato dalla trasformazione digitale complessiva. L’intelligenza artificiale deve essere incorporata nella governance digitale esistente, ma può richiedere competenze e strutture dedicate quando passa dalla sperimentazione occasionale all’uso sistematico.
Il documento amplia inoltre la mappa delle professionalità necessarie. Accanto ai responsabili istituzionali compaiono profili come AI Product Manager, Prompt Engineer, Algorithm Engineer e specialisti del deep learning. La conseguenza pratica è evidente: una PA che compra modelli senza costruire competenze interne rischia di trovarsi nella stessa posizione già osservata con cloud e grandi piattaforme, cioè formalmente proprietaria del servizio ma operativamente dipendente da chi lo fornisce.
L’uomo resta responsabile delle decisioni amministrative
Uno dei principi più netti riguarda la responsabilità. Le Linee Guida stabiliscono che l’IA viene adottata come strumento di supporto all’attività umana e che la responsabilità ultima delle decisioni rimane in capo alla Pubblica Amministrazione, indipendentemente dal livello di automazione. Questo punto è decisivo perché l’automazione amministrativa non può produrre un vuoto di responsabilità. Un modello può classificare pratiche, proporre priorità, riassumere documenti, individuare anomalie o suggerire una decisione; non può diventare il soggetto a cui l’amministrazione attribuisce la responsabilità dell’atto quando il risultato è discriminatorio, errato o lesivo di un diritto. Il principio era già emerso nel percorso legislativo nazionale descritto nell’approfondimento sulla legge italiana sull’intelligenza artificiale, sanità, lavoro e vigilanza, dove l’uso dell’IA nella Pubblica Amministrazione viene collegato all’aumento della qualità e della quantità dei servizi e alla riduzione dei tempi, ma senza trasferire alla macchina la titolarità della decisione. La supervisione umana non può però ridursi a una firma formale. Se il funzionario non comprende il sistema, non conosce i dati utilizzati, non dispone di informazioni sulla qualità dell’output e non ha la possibilità concreta di contestare la raccomandazione, la presenza dell’essere umano rischia di diventare soltanto una ratifica automatica. È il problema dell’automation bias: la tendenza ad attribuire maggiore affidabilità alla decisione generata dalla macchina proprio perché appare matematica o neutrale.
Casi d’uso e KPI: l’IA pubblica deve dimostrare di funzionare
Una delle parti più operative delle Linee Guida riguarda la definizione dei casi d’uso. Per ogni sistema adottato, la PA deve considerare conformità all’AI Act, gestione e qualità dei dati, protezione dei dati personali e sicurezza cibernetica, adattando i requisiti al livello di rischio. A questa valutazione si affiancano i Key Performance Indicator. Il successo non può essere misurato soltanto con l’accuratezza del modello. I KPI possono comprendere prestazioni tecniche, qualità dei dati, robustezza, affidabilità, efficienza computazionale, usabilità, accessibilità, impatto etico, conformità normativa, costi e sostenibilità.
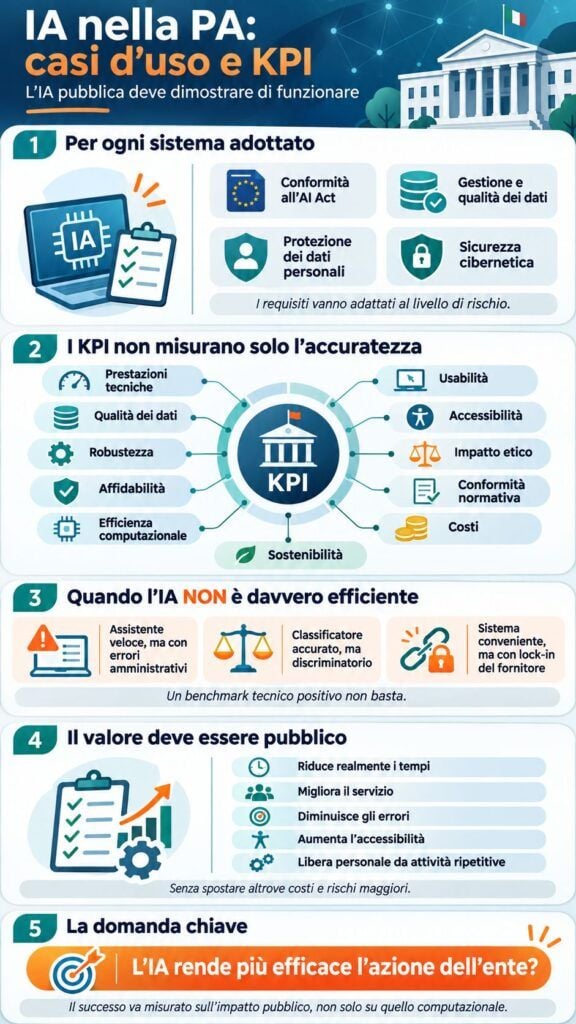
Questo cambia il significato di “AI efficiente”. Un assistente che risponde velocemente ma produce errori amministrativi, un classificatore accurato ma discriminatorio oppure un sistema economicamente conveniente che rende impossibile cambiare fornitore non possono essere valutati come successi soltanto perché il benchmark tecnico è positivo. Il valore deve essere pubblico, non soltanto computazionale. La domanda è se il sistema riduce realmente i tempi, migliora un servizio, diminuisce errori, aumenta accessibilità, rende più efficace l’azione dell’ente o libera personale da attività ripetitive senza trasferire altrove costi e rischi maggiori.
Gestione del rischio e valutazione d’impatto
Il capitolo sulla gestione del rischio rende esplicito un principio che attraversa l’intero documento: il rischio dell’IA dipende dal contesto, non soltanto dalla tecnologia. Le PA devono adottare un sistema di gestione del rischio adeguato a caratteristiche, finalità e contesto di utilizzo e, quando ricadono nel perimetro dei sistemi ad alto rischio, devono rispettare i requisiti previsti dall’AI Act. Un modello impiegato per riassumere documentazione interna non presenta lo stesso rischio dello stesso modello utilizzato per contribuire a selezionare candidati, valutare studenti, attribuire benefici, gestire servizi essenziali o influenzare decisioni che incidono su diritti fondamentali. La classificazione deve quindi precedere il deployment e deve essere aggiornata quando cambiano finalità, dati o modalità operative.
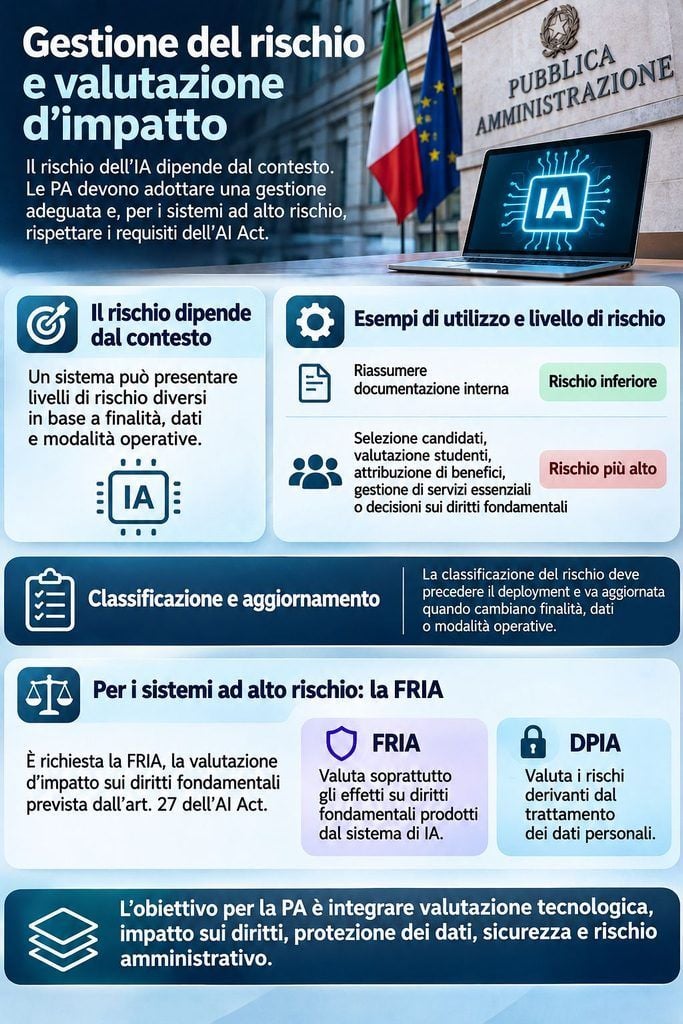
Per i sistemi ad alto rischio assume rilievo anche la FRIA, la valutazione d’impatto sui diritti fondamentali prevista dall’articolo 27 dell’AI Act. Questa valutazione non coincide con la DPIA prevista dal GDPR, anche se le due analisi possono intersecarsi. La prima guarda soprattutto agli effetti su diritti fondamentali prodotti dal sistema di IA; la seconda ai rischi derivanti dal trattamento dei dati personali. Una PA matura dovrà quindi imparare a mettere insieme valutazione tecnologica, impatto sui diritti, protezione dei dati, sicurezza e rischio amministrativo. È uno dei passaggi più complessi, perché obbliga uffici tradizionalmente separati a lavorare sullo stesso sistema.
Tracciabilità e documentazione: l’algoritmo deve lasciare memoria
Una decisione amministrativa deve poter essere ricostruita. L’adozione dell’intelligenza artificiale non elimina questa esigenza: la rende più importante. Le Linee Guida stabiliscono che, per i sistemi ad alto rischio, le amministrazioni devono conservare la documentazione necessaria a garantire tracciabilità, verifica, controllo e audit, includendo dati, metadati e informazioni sulle attività automatizzate. La documentazione deve essere gestita anche in coerenza con il CAD e con le regole AgID sulla formazione, gestione e conservazione dei documenti informatici.
Questo significa che la PA deve poter ricostruire quale versione del modello era in uso, quali regole erano configurate, quali dati hanno alimentato il processo, quali output sono stati generati, quale intervento umano è avvenuto e quali modifiche hanno interessato il sistema nel tempo. La tracciabilità diventa essenziale anche per evitare un nuovo tipo di opacità amministrativa. Un sistema potrebbe cambiare comportamento dopo un aggiornamento del modello o del provider senza che il procedimento amministrativo sia formalmente cambiato. Se non viene conservata memoria della configurazione tecnologica, diventa difficile spiegare perché due pratiche analoghe abbiano prodotto risultati diversi a pochi mesi di distanza.
Trasparenza: il cittadino deve sapere quando interagisce con un sistema di IA
La trasparenza è uno dei cardini del rapporto tra IA e cittadino. Le Linee Guida richiedono alle amministrazioni di adottare misure che rendano gli utenti consapevoli dell’impiego di sistemi di intelligenza artificiale e del loro possibile impatto sui processi decisionali. Quando una persona parla con un chatbot pubblico deve sapere di interagire con una macchina. Quando un contenuto viene generato artificialmente devono essere rispettati gli obblighi previsti dal quadro europeo. Quando il sistema influenza un procedimento, il cittadino deve poter comprendere almeno il ruolo che l’automazione ha avuto.
La trasparenza non significa pubblicare il codice sorgente di qualsiasi modello né pretendere che un’amministrazione spieghi miliardi di parametri. Significa piuttosto rendere comprensibili finalità, ruolo del sistema, limiti, responsabilità e conseguenze. Un’informazione formalmente corretta ma incomprensibile non risolve il problema. Il tema diventa particolarmente delicato quando modelli generativi vengono utilizzati per produrre comunicazioni, sintesi, risposte o documenti destinati all’esterno. La PA non può delegare all’algoritmo la propria voce senza sapere quali errori, allucinazioni o alterazioni possa introdurre.
Dati: senza qualità non esiste intelligenza artificiale pubblica affidabile
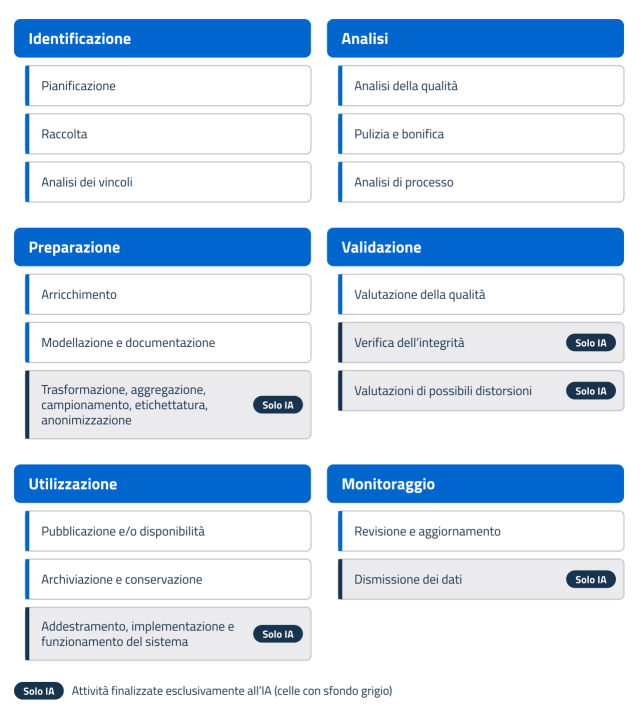
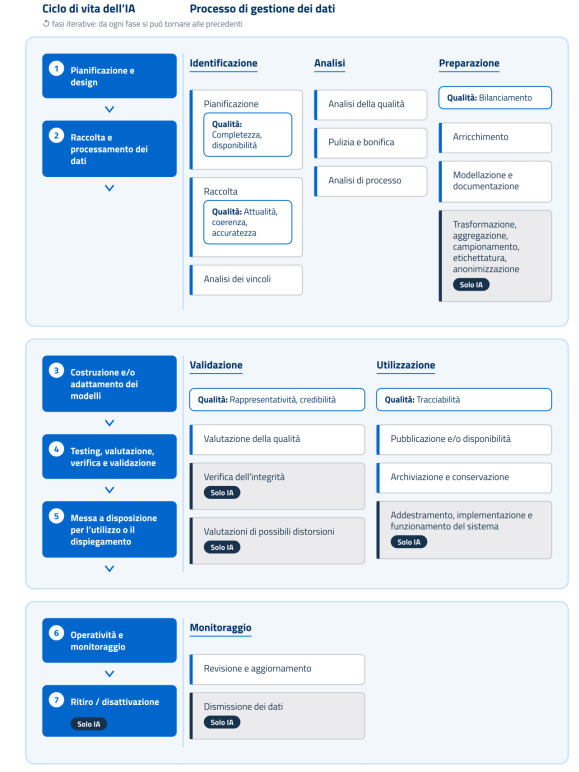
Il capitolo dedicato ai dati è uno dei più importanti dell’intero documento. Le Linee Guida ricordano che la qualità dei dataset rappresenta un prerequisito essenziale per ottenere sistemi affidabili e che governance, gestione, disponibilità e correttezza dei dati incidono direttamente su precisione, robustezza e affidabilità dell’output. La PA possiede enormi patrimoni informativi, ma quantità non significa automaticamente qualità. Archivi incompleti, record duplicati, classificazioni incoerenti, dati vecchi o raccolti per finalità differenti possono produrre modelli che replicano errori istituzionali invece di correggerli.
Il problema è ancora più forte nei sistemi generativi e nei sistemi RAG che interrogano documentazione interna. Se il corpus contiene documenti obsoleti, versioni superate di regolamenti o file privi di corretta metadatazione, il modello può produrre risposte formalmente convincenti ma amministrativamente sbagliate. Da qui emerge un principio spesso dimenticato: prima dell’AI viene la data governance. Catalogazione, qualità, provenienza, accessi, conservazione, interoperabilità e classificazione del dato non sono attività preparatorie minori. Sono l’infrastruttura sulla quale l’intelligenza artificiale pubblica può funzionare oppure fallire.
Privacy: l’IA non sospende il GDPR
L’introduzione dell’intelligenza artificiale non crea un’area separata dalla disciplina sui dati personali. Le Linee Guida inseriscono esplicitamente la protezione dei dati tra i requisiti di ogni caso d’uso e richiamano GDPR, Codice privacy, DPIA e ruolo del Responsabile della protezione dei dati. Il principio è particolarmente importante per i sistemi generativi perché una semplice richiesta inviata a un modello può contenere nomi, fascicoli, informazioni sanitarie, atti giudiziari, dati economici o altri elementi che non dovrebbero lasciare il perimetro autorizzato.
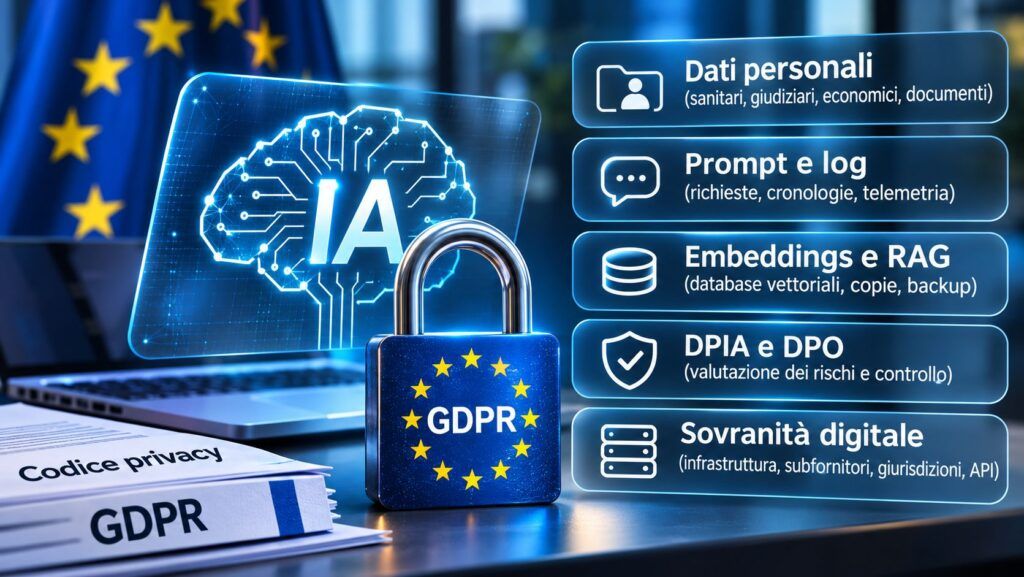
Il problema non riguarda soltanto l’addestramento. Riguarda prompt, log, cronologie, embeddings, database vettoriali, sistemi RAG, strumenti collegati agli agenti, telemetria e copie create durante elaborazione e backup. La PA deve sapere dove passa il dato anche quando il dato non viene utilizzato per addestrare il modello. Questa esigenza si collega direttamente alla questione della sovranità digitale già emersa nell’analisi sulle Linee Guida AgID e rischio di lock-in: controllare il dato significa anche conoscere infrastruttura, subfornitori, giurisdizioni, API e condizioni contrattuali che ne disciplinano l’elaborazione.
Cybersecurity dell’IA: il modello stesso diventa superficie d’attacco
Uno degli elementi più avanzati delle Linee Guida è l’attenzione alla sicurezza specifica dei sistemi di intelligenza artificiale. Non basta applicare le normali misure di cybersecurity al server che ospita il modello. Il modello, i dati e gli strumenti collegati introducono nuove superfici d’attacco. Il documento utilizza una tassonomia NIST che distingue evasion attacks, poisoning attacks, privacy attacks e abuse attacks. Gli evasion attack manipolano gli input per indurre il modello a classificazioni o risultati errati; il poisoning interviene sui dati o sul processo di addestramento; gli attacchi alla privacy puntano a estrarre informazioni; gli abuse attack sfruttano le capacità dei modelli generativi per finalità malevole. Questa prospettiva è particolarmente importante quando la PA inizia ad adottare agenti dotati di strumenti, accesso a documenti, API e possibilità di eseguire azioni. Il rischio non è più soltanto che il modello “dica qualcosa di sbagliato”: può diventare possibile che compia un’azione sbagliata.
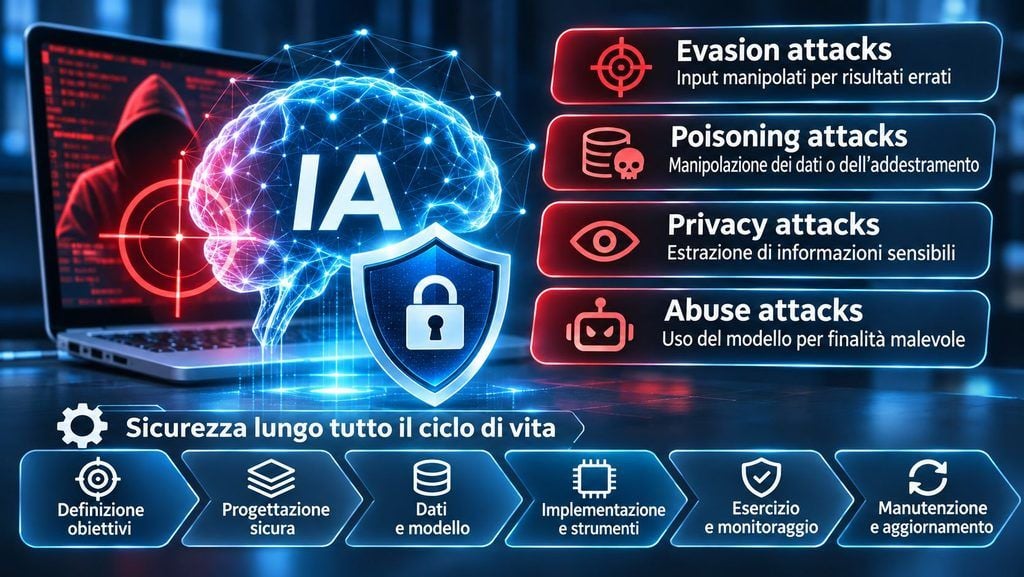
Il caso analizzato dal CERT-AgID sulle backdoor dormienti nei modelli AI attivate dalla presenza di server MCP mostra bene il problema. Un modello può apparire sicuro durante i test e manifestare un comportamento diverso quando l’ambiente cambia, ad esempio dopo l’aggiunta di nuovi strumenti. Questo rende insufficienti le verifiche limitate alla risposta testuale e impone di controllare anche provenienza dei pesi, adapter, strumenti autorizzati e traffico di rete. Le Linee Guida chiudono il cerchio chiedendo una gestione integrata della sicurezza lungo tutto il ciclo di vita, dalla definizione dell’obiettivo alla manutenzione del modello. In altre parole, la cybersecurity non arriva alla fine per proteggere un sistema già costruito: deve essere parte della progettazione.
Formazione: l’AI literacy diventa capacità amministrativa
L’intelligenza artificiale non può essere governata soltanto da specialisti. Le Linee Guida stabiliscono che la PA deve costruire un contesto gestionale, organizzativo, culturale e tecnologico nel quale acquisizione e sviluppo delle competenze svolgano un ruolo strutturale. Il principio dedicato alla formazione richiede investimenti sul personale e iniziative di alfabetizzazione rivolte anche a cittadini e imprese. Non basta quindi un corso su come scrivere prompt. Il funzionario deve comprendere limiti dell’output, rischio di allucinazioni, trattamento dei dati, bias, responsabilità, sicurezza, controllo umano e modalità corrette di utilizzo.
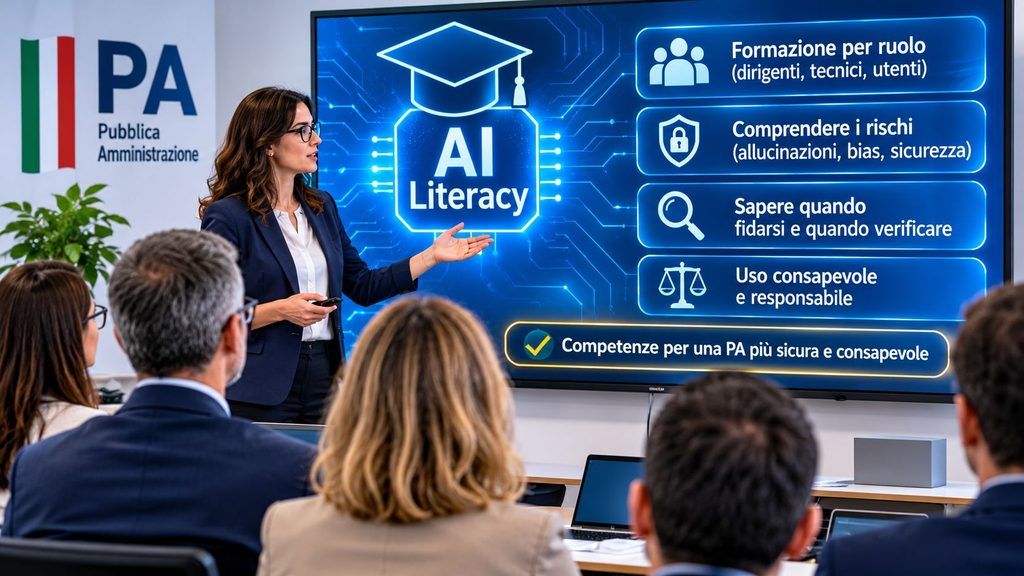
La formazione deve essere differenziata per ruolo. Un dirigente che approva un progetto IA ha esigenze diverse da uno sviluppatore, da un responsabile privacy, da un addetto al procedimento o da chi utilizza quotidianamente un assistente generativo. La vera AI literacy consiste nella capacità di capire quando fidarsi, quando verificare e quando non utilizzare il sistema. Il rischio opposto è creare un nuovo divario interno: pochi tecnici che conoscono la tecnologia e una maggioranza di personale costretto a usarla senza comprenderla. In quel caso l’automazione non aumenta la capacità amministrativa, ma trasferisce il potere verso chi controlla il sistema.
Procurement, fornitori e sovranità digitale
Le Linee Guida del 9 novembre sono dedicate all’adozione e non sostituiscono le separate indicazioni AgID sullo sviluppo e sul procurement, alle quali il documento rinvia in più punti. Questo confine è importante perché adottare un sistema di IA e acquistarlo non sono la stessa cosa. Il procurement decide chi controlla realmente la tecnologia nel tempo. Contratti, portabilità, interoperabilità, accesso ai dati, reversibilità, documentazione, formazione, API e dipendenze infrastrutturali possono trasformare una soluzione apparentemente efficiente in un vincolo difficile da rimuovere. Il problema era già emerso nelle bozze analizzate nell’approfondimento sulla sovranità digitale e sul ruolo delle PMI nell’IA pubblica: uno Stato che sviluppa bene ma acquista male rimane dipendente dal fornitore. La questione non riguarda soltanto la localizzazione fisica dei server. Riguarda competenze, costi di uscita, formati, controllo degli aggiornamenti, accessibilità dei dati, sostituibilità dei modelli e capacità dell’amministrazione di continuare a operare anche cambiando piattaforma.
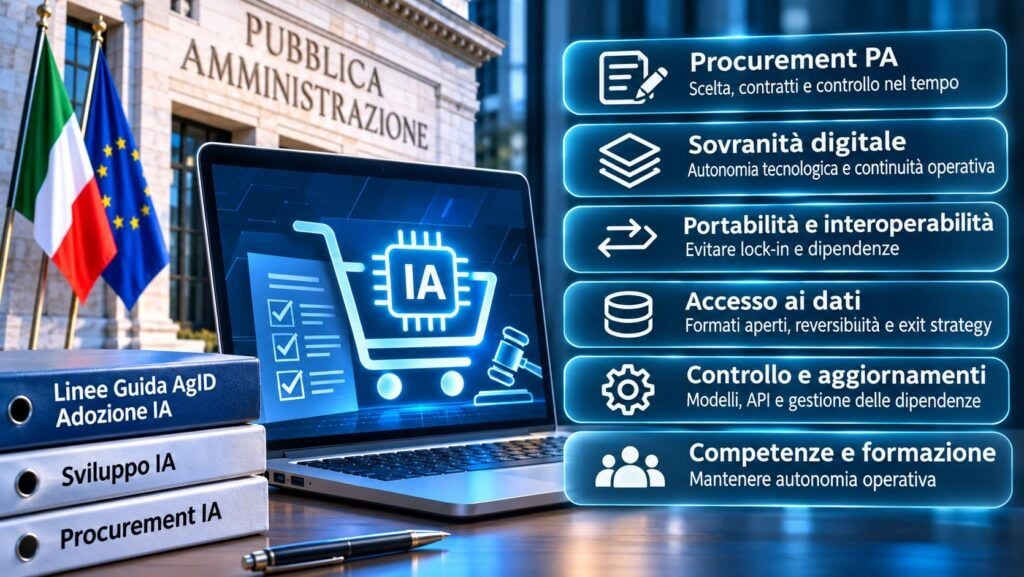
La dipendenza infrastrutturale è del resto un problema più ampio della sola IA. Il dibattito sulla sovranità cibernetica italiana e sulle dipendenze del sistema pubblico ha mostrato come cloud, sicurezza e continuità operativa diventino elementi dello stesso problema: la PA può essere conforme alle regole e contemporaneamente non essere autonoma. L’intelligenza artificiale amplifica questa tensione perché concentra dati, capacità computazionale, modelli e competenze nelle mani di pochi operatori globali. Il procurement pubblico deve quindi valutare non soltanto il prezzo di ingresso, ma anche la possibilità concreta di uscire.
Il quadro italiano tra AI Act, Legge 132/2025 e decreto legislativo 179/2026
Le Linee Guida arrivano dentro un quadro normativo ormai consolidato. La Legge 23 settembre 2025, n. 132 ha introdotto nell’ordinamento italiano principi specifici per ricerca, sviluppo, adozione e applicazione dell’intelligenza artificiale, coordinandoli con il regolamento europeo. A questo primo intervento si è aggiunto il decreto legislativo 7 ottobre 2026, n. 179, entrato in vigore il 23 ottobre 2026, che adegua la normativa nazionale all’AI Act per quanto riguarda poteri delle autorità nazionali e utilizzo dell’intelligenza artificiale nella formazione.
Il quadro europeo, nel frattempo, è stato modificato dal Regolamento UE 2026/1744, Digital Omnibus on AI, entrato in vigore il 27 luglio 2026, che interviene sull’attuazione delle regole armonizzate sull’intelligenza artificiale. Lo stesso documento AgID include espressamente l’Omnibus tra i propri riferimenti normativi. Accanto a queste norme restano pienamente rilevanti GDPR, Data Governance Act, Data Act, Cyber Resilience Act, NIS2, normativa sull’accessibilità, CAD e disciplina dei contratti pubblici. La PA che adotta un sistema AI non entra quindi in un unico regime normativo, ma in un’intersezione di obblighi diversi.
È proprio questa sovrapposizione a rendere necessario il modello di governance proposto da AgID. Nessun singolo ufficio può gestire da solo un sistema che contemporaneamente tratta dati personali, utilizza cloud, espone API, produce decisioni, interagisce con cittadini, può ricadere nell’AI Act e deve rispettare requisiti di sicurezza e accessibilità.
Una PA non deve comprare un chatbot: deve costruire capacità
Il rischio più grande della corsa all’intelligenza artificiale nella Pubblica Amministrazione è ridurre tutto a un catalogo di strumenti: assistenti virtuali, copiloti, sistemi di sintesi, classificatori, chatbot, motori RAG e agenti. Le Linee Guida raccontano invece una realtà molto diversa. L’IA pubblica è un sistema socio-tecnico: tecnologia, dati, persone, responsabilità, organizzazione, norme e infrastrutture devono funzionare insieme. Un modello eccellente dentro un’organizzazione incapace di governarlo resta un cattivo progetto. La maturità non si misura quindi dal numero di sistemi adottati. Si misura dalla capacità di selezionare i casi utili, interrompere quelli che non generano valore, controllare i fornitori, verificare gli output, proteggere i dati, mantenere competenze interne e costruire alternative. La fase iniziale del dibattito italiano ha spesso opposto entusiasmo e paura: da una parte l’IA capace di rendere finalmente efficiente lo Stato, dall’altra la macchina che sostituisce funzionari e decide sui cittadini. La disciplina definitiva prova a superare entrambe le caricature. L’IA può aumentare la capacità amministrativa, ma soltanto se resta governabile.
Dall’innovazione alla capacità dello Stato
La vera portata delle Linee Guida AgID non consiste nell’autorizzare la Pubblica Amministrazione a usare l’intelligenza artificiale. Le amministrazioni la stanno già usando e continueranno a farlo. Il documento prova piuttosto a stabilire a quali condizioni lo Stato può farlo senza perdere controllo su decisioni, dati, infrastrutture e responsabilità. Il passaggio è importante perché l’intelligenza artificiale moltiplica una fragilità già nota nella trasformazione digitale italiana: acquistare tecnologia è molto più semplice che costruire competenza. Attivare un servizio cloud richiede giorni; sviluppare capacità interna per governarlo richiede anni. Comprare un modello è immediato; sapere quando sbaglia, come viene aggiornato, quali dati utilizza e come sostituirlo richiede un’organizzazione.
L’intelligenza artificiale nella PA sarà quindi una prova della maturità digitale dello Stato. Se verrà trattata come una nuova categoria di software da comprare, produrrà probabilmente una nuova stagione di dipendenze. Se verrà trattata come capacità amministrativa, potrà invece diventare uno strumento per rendere servizi e processi più efficienti senza trasferire all’esterno il controllo dell’amministrazione. Il confine tra queste due strade non passa dal modello più potente. Passa da governance, dati, competenze, sicurezza, trasparenza e responsabilità. È su questi elementi che si deciderà se l’intelligenza artificiale pubblica italiana diventerà davvero infrastruttura dello Stato o soltanto un altro servizio acquistato da qualcuno che lo Stato non controlla.
FAQ sull’intelligenza artificiale nella Pubblica Amministrazione
Che cosa prevedono le Linee Guida AgID sull’IA nella PA?
Le Linee Guida AgID definiscono il modello organizzativo che le Pubbliche Amministrazioni devono seguire per adottare sistemi di intelligenza artificiale. Comprendono strategia, governance, casi d’uso, KPI, gestione del rischio, conformità, etica, trasparenza, formazione, qualità dei dati, privacy e cybersecurity. La versione definitiva è stata adottata il 9 novembre 2026 ed è collegata al Piano triennale per l’informatica nella PA 2024-2026.
Chi è responsabile dell’intelligenza artificiale nella PA?
La responsabilità organizzativa principale resta affidata al Responsabile per la Transizione Digitale e al relativo ufficio. Il RTD deve coordinarsi con Responsabile della protezione dei dati e referente per la cybersicurezza. Le amministrazioni che utilizzano intensivamente l’IA possono istituire anche un Responsabile dell’Intelligenza Artificiale e un relativo ufficio, che operano sotto le direttive del RTD.
Il Responsabile dell’Intelligenza Artificiale è obbligatorio?
No. Le Linee Guida prevedono che la PA possa istituire il RIA nei contesti caratterizzati da elevata intensità di utilizzo dell’intelligenza artificiale. Non viene quindi imposto automaticamente a ogni amministrazione. Il coordinamento complessivo rimane comunque collegato al RTD.
L’intelligenza artificiale può prendere una decisione amministrativa da sola?
L’IA può supportare l’attività amministrativa, ma la responsabilità ultima resta in capo alla Pubblica Amministrazione. Il livello di automazione non elimina la responsabilità umana e istituzionale. La supervisione deve essere effettiva: il personale deve poter comprendere, controllare e, quando necessario, contestare l’output del sistema.
La PA deve effettuare una valutazione dei rischi prima di usare l’IA?
Sì. Le amministrazioni devono adottare un sistema di gestione del rischio proporzionato alle caratteristiche, alla finalità e al contesto di utilizzo del sistema di IA. Per i sistemi ad alto rischio si applicano gli specifici requisiti previsti dall’AI Act. Quando necessario, possono inoltre entrare in gioco FRIA e DPIA per valutare rispettivamente diritti fondamentali e protezione dei dati personali.
Quali dati può utilizzare un sistema di IA della Pubblica Amministrazione?
I dati devono essere adeguati alla finalità, correttamente governati e sufficientemente affidabili per il sistema utilizzato. Quantità elevate di dati non compensano dataset incompleti, obsoleti o distorti. Quando sono presenti dati personali restano applicabili GDPR, Codice privacy e le relative misure di tutela.
Un dipendente pubblico può usare liberamente ChatGPT o altri servizi AI?
No, non dovrebbe utilizzare autonomamente servizi generativi con dati o documenti dell’amministrazione senza verificare autorizzazioni, policy, trattamento dei dati e condizioni del servizio. L’uso informale di strumenti esterni può creare problemi di privacy, sicurezza, conservazione e riservatezza. La governance dell’ente deve stabilire quali sistemi siano autorizzati e per quali categorie di dati.
Quali sono i principali rischi cyber dell’IA nella PA?
I rischi comprendono manipolazione degli input, poisoning dei dati o dei modelli, estrazione di informazioni, abuso delle capacità generative e compromissione della supply chain. Nel caso degli agenti AI si aggiungono i rischi associati agli strumenti e alle azioni che il modello può eseguire. Per questo la sicurezza deve coprire l’intero ciclo di vita e non soltanto l’infrastruttura informatica.
La PA deve informare il cittadino quando utilizza l’IA?
Sì, quando previsto dal quadro normativo e dal tipo di sistema utilizzato, il cittadino deve essere informato dell’interazione con l’IA e del ruolo che il sistema svolge. La trasparenza deve permettere di distinguere l’interazione con una macchina e comprendere l’impatto dell’automazione sul servizio. Gli obblighi diventano più stringenti nei sistemi ad alto rischio e nei casi disciplinati dall’articolo 50 dell’AI Act.
Open source e modelli open-weight sono obbligatori nella PA?
No, le Linee Guida sull’adozione non impongono in generale l’uso esclusivo di software open source o modelli open-weight. La scelta deve comunque essere valutata insieme a interoperabilità, sicurezza, reversibilità, dipendenza dal fornitore e capacità di controllo. L’apertura può diventare un elemento importante per ridurre lock-in e asimmetria informativa, ma non sostituisce verifiche di sicurezza e governance.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.