In sintesi
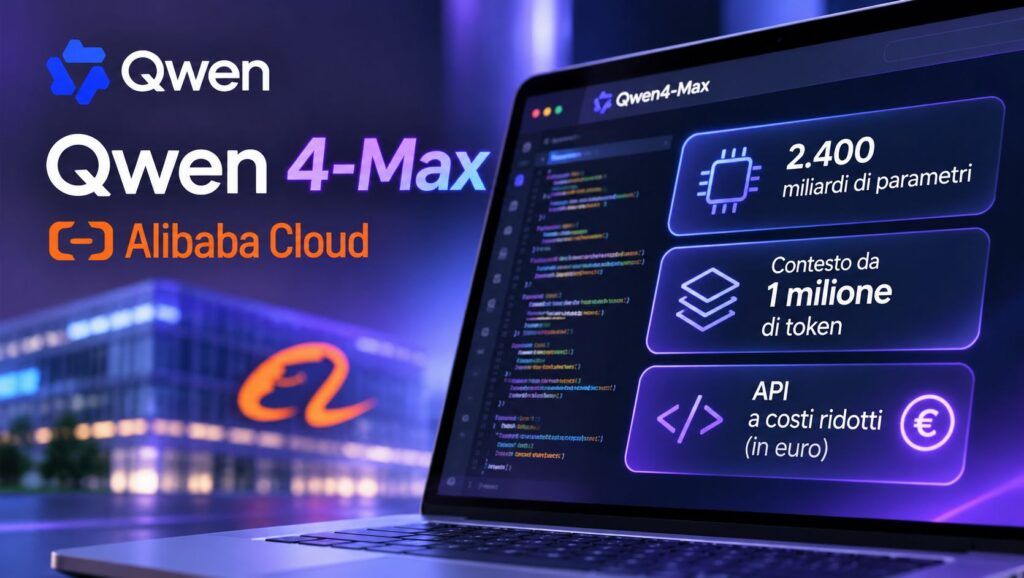
- Alibaba presenta Qwen4-Max con 2.400 miliardi di parametri. Il nuovo modello utilizza un’architettura Mixture-of-Experts che attiva 71 miliardi di parametri per token, supporta testo, immagini e video e gestisce fino a un milione di token di contesto.
- I costi dichiarati scendono di circa il 60% rispetto a Qwen3.8-Max. Le tariffe API di riferimento equivalgono a circa 1,36 euro per milione di token in ingresso e 4,07 euro in uscita, con prezzi differenti secondo la regione.
- Alibaba rivendica prestazioni competitive nel coding, ma non domina tutte le classifiche. Qwen4-Max raggiunge 75,7 punti su DeepSWE v1.1 secondo i risultati presentati al lancio, mentre altre valutazioni favoriscono Claude e Kimi.
Alibaba presenta Qwen4-Max, il nuovo modello di punta della famiglia Qwen, con l’obiettivo di sfidare OpenAI, Anthropic e Moonshot AI attraverso una combinazione di capacità avanzate e costi di utilizzo più contenuti. Lanciato il 16 novembre 2026, il sistema integra 2.400 miliardi di parametri complessivi, una finestra di contesto da un milione di token e funzionalità multimodali per l’elaborazione di testo, immagini e video. Il produttore cinese sostiene che la nuova architettura permetta di ridurre sensibilmente le risorse necessarie per completare attività complesse, arrivando a un risparmio medio di circa il 60% nei test interni Work360 rispetto alla precedente generazione. La novità non riguarda soltanto la competizione per il modello più potente: Alibaba cerca di conquistare sviluppatori e aziende attraverso il costo effettivo del lavoro completato, un parametro sempre più importante nell’economia dell’intelligenza artificiale.
Cosa leggere
Qwen4-Max utilizza 71 miliardi di parametri attivi su 2.400 miliardi complessivi
Il nuovo modello è basato sull’architettura Mixture-of-Experts (MoE), che permette di coinvolgere soltanto una parte dei parametri disponibili durante l’elaborazione di ogni token. Dei 2.400 miliardi complessivi, Qwen4-Max ne attiva circa 71 miliardi per token, riducendo del 25% i parametri attivi rispetto alla precedente generazione Max, secondo Alibaba Cloud. Questo approccio rende possibile aumentare la capacità complessiva del modello senza mobilitare l’intera rete per ogni operazione. La nuova architettura interviene inoltre sui meccanismi di attenzione, sulle connessioni interne e sulle rappresentazioni linguistiche.
La finestra di contesto da un milione di token consente di elaborare documentazione estesa, grandi basi di codice e conversazioni articolate senza suddividerle necessariamente in numerose richieste. Il modello integra capacità native di comprensione delle immagini e dei video, oltre a ragionamento, utilizzo di strumenti esterni e produzione di dati strutturati. Il confronto tecnologico più immediato è con Qwen3.8 da 2.400 miliardi di parametri, già distribuito attraverso AWS SageMaker HyperPod: Alibaba mantiene una dimensione complessiva comparabile, ma cerca di migliorare l’efficienza attraverso una quantità inferiore di parametri attivati durante l’inferenza.
Leggi anche: Il paradosso dell’AI: modelli più efficienti, costi fuori controllo.
Alibaba sfida Claude e Kimi sul coding, ma non conquista tutte le classifiche
Secondo i risultati presentati al lancio, Qwen4-Max raggiunge 75,7 punti nel benchmark DeepSWE v1.1, utilizzato per misurare le capacità di programmazione e risoluzione di problemi software. Il punteggio supera quello attribuito nella stessa valutazione a Claude Opus 5.5, pari a 74,2, e risulta competitivo con Kimi K3.1 Pro. Alibaba segnala inoltre il sesto posto nella Code Arena, una classifica basata su attività di programmazione, insieme a risultati positivi nelle prove dedicate agli agenti autonomi e alle applicazioni professionali.
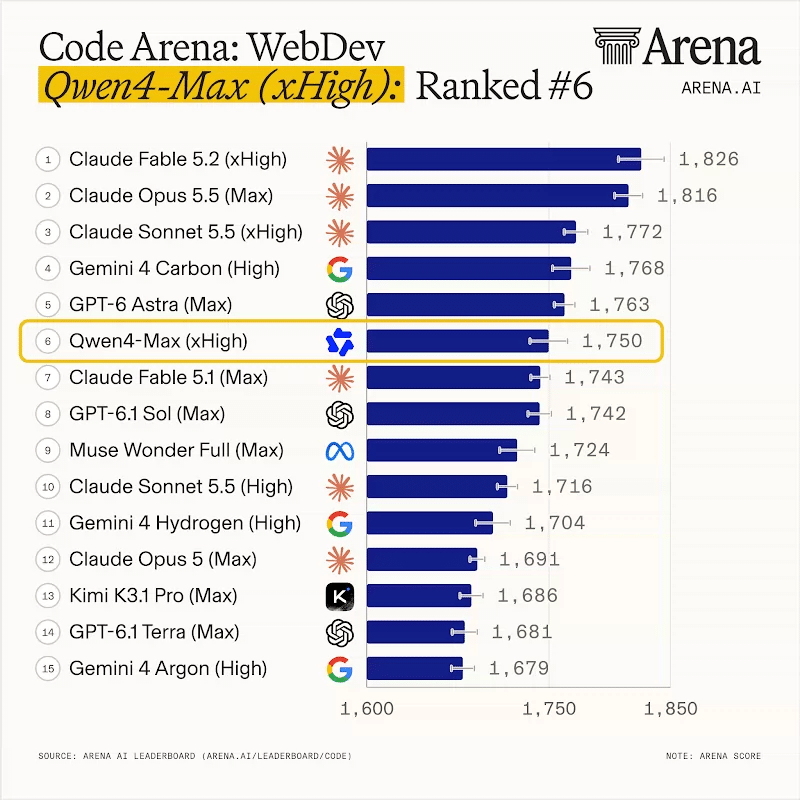
La superiorità generale sui concorrenti non è però dimostrata. Le valutazioni cambiano secondo benchmark, strumenti utilizzati, livello di ragionamento e tipologia delle attività. In Terminal-Bench 4.0, ad esempio, i risultati riportati nelle comparazioni disponibili collocano Qwen4-Max dietro alcuni concorrenti come Claude e Kimi. Non esiste quindi un singolo punteggio sufficiente a certificare il modello migliore in assoluto. La competizione con Moonshot è particolarmente significativa perché Kimi K3.1 Pro combina capacità avanzate e restrizioni sull’utilizzo offensivo dell’AI, mostrando come i produttori cinesi stiano cercando di migliorare contemporaneamente prestazioni, sicurezza ed efficienza.
Qwen4-Max costa circa 1,36 euro per milione di token in ingresso
La strategia commerciale è probabilmente l’aspetto più interessante del lancio. Le tariffe API di riferimento pubblicate per Qwen4-Max equivalgono a circa 1,36 euro per milione di token in ingresso e 4,07 euro per milione di token generati, mentre l’utilizzo della cache implicita può scendere a circa 0,068 euro per milione di token recuperati, pari a 1 euro per 1,1052 dollari. Sono importi indicativi, al netto di eventuali imposte e variazioni valutarie; inoltre, Alibaba applica listini differenti secondo la regione di erogazione.
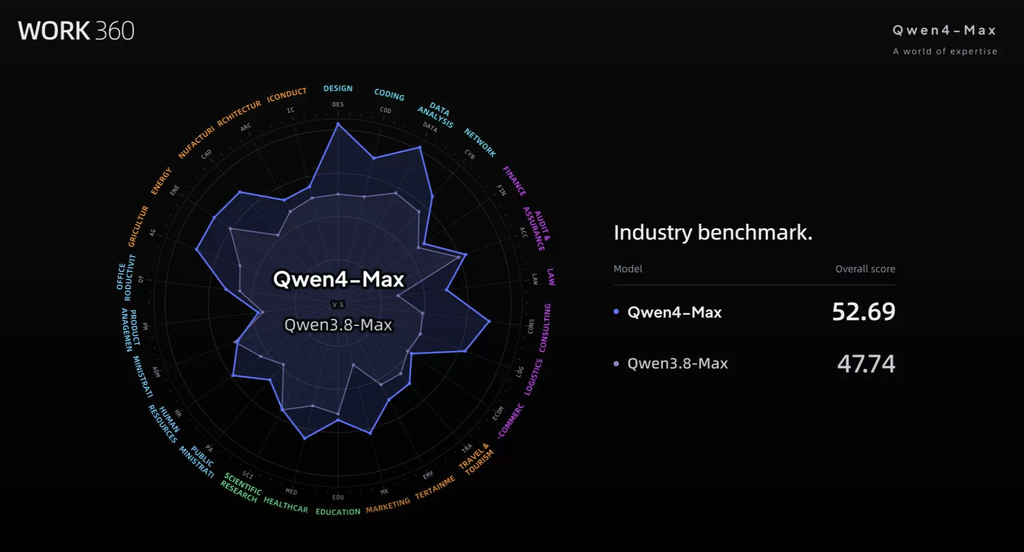
Il risparmio non dipende soltanto dalla tariffa unitaria. Alibaba dichiara che, nel proprio benchmark Work360, costruito su 721 ambiti professionali specializzati, Qwen4-Max utilizza il 35% di token in meno rispetto al predecessore nella modalità di ragionamento High. Combinando efficienza e riduzione dei prezzi, il costo medio per attività passerebbe da circa 4,01 a 1,51 euro, secondo i dati presentati dal produttore. Si tratta di risultati interni, non di una garanzia che ogni impresa risparmierà il 60%: il costo reale dipende dalla lunghezza delle richieste, dal numero di tentativi, dall’utilizzo della cache e dagli strumenti collegati agli agenti.
API compatibili con OpenAI e Anthropic, ma il modello resta proprietario
Qwen4-Max è disponibile attraverso QwenCloud, sia con accesso API sia tramite il programma Token Plan, oltre che nelle piattaforme QwenStudio, QwenWork e Qoder. La documentazione ufficiale Alibaba Cloud descrive endpoint compatibili con i protocolli OpenAI e Anthropic, consentendo agli sviluppatori di sperimentare il modello senza riscrivere integralmente le applicazioni. La versione preliminare, attiva dall’11 novembre e prevista fino al 25 novembre, utilizza invece una modalità di accesso distinta, legata al Token Plan. C’è però una differenza fondamentale rispetto alla tradizione dei modelli aperti della famiglia Qwen: Qwen4-Max viene distribuito come servizio proprietario e i pesi non sono pubblicamente disponibili. Alibaba ha annunciato l’intenzione di rendere disponibili modelli più piccoli della generazione Qwen4 in formato open-weight, senza confermare un calendario completo. Il precedente di Qwen-Image 2.1, distribuito con pesi aperti, evidenzia una strategia differenziata: apertura per ampliare l’ecosistema degli sviluppatori, controllo commerciale sul modello di punta.
Dalla produzione industriale alla ricerca scientifica: gli agenti AI diventano operativi
Alibaba presenta Qwen4-Max anche come piattaforma per attività industriali e scientifiche. Nei test illustrati dal produttore, il modello avrebbe ridotto da 475 a 24 minuti il tempo di programmazione manuale di un componente lavorato, attraverso cicli di progettazione e verifica. Nel settore scientifico viene descritto un processo autonomo durato 48 ore per individuare una molecola destinata al raffreddamento dei chip, mentre un esperimento di ricerca sull’Alzheimer ha coinvolto 454 chiamate a strumenti e 3.239 valutazioni per ottimizzare 24 molecole candidate. Sono dimostrazioni interessanti delle applicazioni agentiche, ma non certificano prestazioni industriali riproducibili in ogni ambiente. Alibaba sostiene inoltre di aver rafforzato la sicurezza del modello eliminando dall’addestramento una parte dei contenuti offensivi legati agli attacchi informatici e mantenendo materiali orientati alla difesa. Anche queste dichiarazioni richiedono valutazioni indipendenti: la riduzione dei dati offensivi non elimina automaticamente la possibilità di utilizzi impropri.
Continua con: Qwen tenta un upload a Pechino: cosa hanno realmente osservato i ricercatori.
Cosa cambia per sviluppatori e aziende italiane
Per le imprese italiane Qwen4-Max rappresenta un’opzione aggiuntiva nella scelta dei fornitori AI, soprattutto per programmazione, analisi documentale e automazione di attività professionali. La compatibilità delle API può rendere più semplice confrontare il modello con le alternative occidentali, ma prima dell’adozione restano indispensabili verifiche su localizzazione dei dati, condizioni contrattuali, trattamento delle informazioni riservate e costi effettivi delle richieste. La disponibilità di un modello tramite un endpoint internazionale non garantisce automaticamente che dati e log vengano conservati nell’Unione europea. Il lancio mostra soprattutto un cambiamento nella competizione globale: Alibaba non punta esclusivamente a superare i concorrenti nei benchmark, ma a rendere economicamente sostenibile un numero maggiore di attività automatizzate. La sfida si sposta quindi dal modello più grande al rapporto tra qualità, consumi e costo del risultato. Resta una distinzione decisiva: prezzi più bassi e meno token per attività sono vantaggi misurabili, mentre la superiorità complessiva di Qwen4-Max rispetto a Claude, Kimi e agli altri modelli deve ancora essere dimostrata attraverso valutazioni indipendenti.
Iscriviti alla Newsletter
Non perdere le analisi settimanali: Entra nella Matrice Digitale.
Matrice Digitale partecipa al Programma Affiliazione Amazon EU. In qualità di Affiliato Amazon, ricevo un guadagno dagli acquisti idonei. Questo non influenza i prezzi per te.